The FreeBSD Project
Screenshot:
VulcanSphere | wikimedia_commons | BSD
RAG-система может показать ссылку на документ и всё равно ответить неправильно. Ссылка лишь говорит, что некоторый фрагмент был найден или добавлен в контекст. Она не доказывает, что конкретное утверждение модели действительно следует из этого фрагмента.
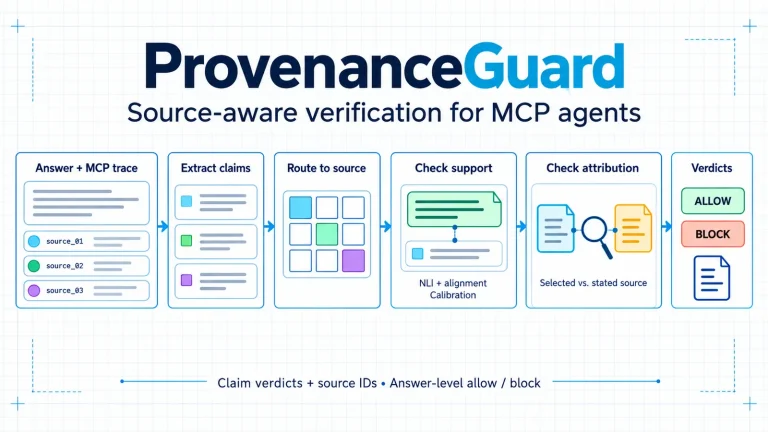
Поэтому проверка цитат RAG должна отвечать на более узкий вопрос: можно ли восстановить путь от каждого существенного утверждения в ответе к подтверждающему фрагменту исходного документа?
Это полезно для внутренних баз знаний, технической документации, юридических архивов и корпоративных ассистентов. Ошибка здесь обычно возникает в одном из трёх мест: поиск достал не тот фрагмент, чанкинг потерял необходимый контекст или модель сделала вывод, которого в источнике нет.
Что именно нужно проверять в RAG-ответе
У ответа есть как минимум четыре независимых свойства:
Релевантность найденного контекста — содержит ли выдача документы, относящиеся к вопросу.
2. Полнота контекста — есть ли в выдаче фрагменты, необходимые для ответа.
3. Поддержанность утверждений — следует ли каждое утверждение из найденных данных.
4. Корректность самой ссылки — можно ли открыть именно тот документ и фрагмент, на который ссылается система.
Эти свойства нельзя заменить одной метрикой. Например, поиск может вернуть правильный документ, но модель неправильно интерпретирует исключение из правила. Или ответ будет полностью подтверждённым, но пропустит важное условие, находившееся в другом разделе.
В документации Ragas метрика faithfulness оценивает, насколько утверждения ответа поддерживаются контекстом. Context precision, напротив, смотрит на порядок и релевантность найденных фрагментов. TruLens использует близкое понятие groundedness — степень опоры ответа на предоставленный контекст. Это разные проверки, и смешивать их в один показатель рискованно.
Почему наличие URL не доказывает точность
Рассмотрим простой пример. В базе есть правило:
> Бесплатный тариф включает 1 000 запросов в месяц. После превышения лимита новые запросы блокируются до начала следующего расчётного периода.
Пользователь спрашивает: «Что произойдёт после превышения лимита?»
Плохой ответ может выглядеть так:
> После превышения лимита включается платная тарификация. Источник: страница с описанием тарифов.
URL существует и относится к теме, но утверждение не подтверждено. Модель добавила типичный для SaaS-сервисов сценарий, которого в тексте нет.
Проверка должна разделить ответ на атомарные утверждения:
- бесплатный тариф включает 1 000 запросов;
- после превышения лимита новые запросы блокируются;
- блокировка действует до следующего расчётного периода;
- включается платная тарификация.
Первые три утверждения подтверждаются документом, последнее — нет. Если оценивать ответ целиком, ошибка может затеряться за счёт трёх правильных фраз.
Минимальный воспроизводимый тест
Для первой версии не нужен сложный бенчмарк. Достаточно 20–50 вопросов, составленных по реальным документам, и эталонных ответов с указанием подтверждающих фрагментов.
Для каждого примера сохраните:
- вопрос пользователя;
- список документов, доступных поиску;
- найденные фрагменты с идентификаторами;
- ответ модели;
- атомарные утверждения ответа;
- фрагменты, которые подтверждают каждое утверждение;
- ручную оценку: подтверждено, частично подтверждено или не подтверждено.
Полезно добавить вопросы четырёх типов:
- прямой поиск факта;
- вопрос с несколькими условиями;
- вопрос, ответа на который нет в базе;
- вопрос, где похожие документы содержат разные версии правила.
Последний тип особенно важен. RAG может выглядеть хорошо на простых вопросах и проваливаться, когда в документации одновременно существуют старая и новая редакции.
Простейшая итоговая метрика выглядит так:
text
доля подтверждённых утверждений =
число полностью подтверждённых утверждений /
общее число проверенных утверждений
Частично подтверждённые утверждения лучше считать отдельно, а не автоматически округлять до правильных. Иначе ответ, в котором потеряно важное ограничение, получит слишком высокий балл.
Как отделить ошибку поиска от ошибки генерации
Один и тот же неправильный ответ может появиться по двум разным причинам.
Если нужный фрагмент не попал в контекст, проблема находится в retrieval-слое. Проверьте:
- не слишком ли маленький размер чанка;
- не потерялся ли заголовок или условие при разбиении;
- используется ли правильная версия документа;
- не отфильтровал ли reranker нужный результат;
- достаточно ли велико значение top-k.
Если нужный фрагмент был в контексте, но модель добавила неподтверждённый вывод, проблема находится в генерации или инструкции. В этом случае полезно повторить запрос с жёстким требованием:
> Отвечай только утверждениями, которые прямо подтверждаются контекстом. Если подтверждения нет, напиши «в документах нет ответа». Для каждого утверждения укажи ID фрагмента.
Если после этого ошибка остаётся, изменение промпта само по себе проблему не решило. Нужны структурированный формат, постпроверка утверждений или другой маршрут обработки.
Можно зафиксировать диагностику в таком виде:
| Ситуация | Найден правильный фрагмент | Вывод |
|---|---|---|
| Ответ верный | Да | Поиск и генерация сработали |
| Ответ неверный | Нет | Сначала исправлять retrieval |
| Ответ неверный | Да | Проверять генерацию и правила цитирования |
| Ответ «нет ответа» | Да | Возможно, модель слишком консервативна |
Таблица не заменяет разбор примеров, но помогает не лечить промптами проблему индекса.
Как проверять цитату на уровне фрагмента
Ссылка должна вести не только на страницу, но и к проверяемой части источника. Для этого в записи о retrieved-контексте храните:
- стабильный ID документа;
- URL;
- дату или версию;
- номер чанка;
- текст фрагмента;
- заголовок раздела;
- позицию в исходном документе.
Если база построена на Markdown или HTML, можно сохранять якорь раздела. Для PDF потребуется более аккуратная привязка: номер страницы, координаты блока или неизменяемая копия текста. Ссылка на PDF без номера страницы плохо подходит для аудита.
Важно проверять не только существование URL, но и его соответствие версии документа. Если страница обновилась после формирования ответа, пользователь может уже не увидеть исходное подтверждение. Для чувствительных сценариев храните снимок документа или хеш индексированной версии.
Метрики полезны, но не должны становиться единственным судьёй
Автоматическая оценка удобна для регрессионных тестов. После изменения эмбеддингов, модели или размера чанков можно быстро сравнить новую сборку со старой.
Но LLM-as-a-judge способен ошибаться в тех же местах, что и проверяемая модель. Он может принять правдоподобный вывод за подтверждённый, не заметить отрицание в документе или проигнорировать число и единицу измерения.
Поэтому практичная схема состоит из трёх уровней:
Правила и программные проверки. Проверяют наличие ID документов, URL, пустых цитат и соответствие схемы.
2. Автоматические метрики. Сравнивают faithfulness, context precision и долю отказов на наборе тестов.
3. Ручной аудит. Проверяет случайную выборку и все примеры с высокой ценой ошибки.
Для контрольного набора заранее отметьте особенно опасные конструкции:
- «не» и другие отрицания;
- даты и сроки;
- лимиты и пороги;
- исключения;
- сравнения «выше», «ниже», «только»;
- несколько версий одного правила.
Именно на них модель часто создаёт ответ, который звучит уверенно, но меняет смысл источника.
Рабочий формат ответа с цитатами
Чем свободнее модель формулирует ответ, тем сложнее его проверять. Для прикладного ассистента лучше ограничить формат:
json
{
«answer»: «После превышения лимита новые запросы блокируются до следующего периода.»,
«claims»: [
{
«text»: «Новые запросы блокируются после превышения лимита.»,
«source_id»: «pricing-v3#limits»,
«support»: «полное»
},
{
«text»: «Блокировка действует до следующего расчётного периода.»,
«source_id»: «pricing-v3#limits»,
«support»: «полное»
}
],
«confidence»: «высокая»
}
На практике поле `confidence` не следует принимать за доказательство. Оно отражает оценку модели, а не независимую проверку. Решение о публикации или выполнении действия должно опираться на наличие подтверждающего фрагмента и результат отдельной проверки.
Если утверждение нельзя связать с источником, безопаснее удалить его или явно пометить как неподтверждённое. Формулировка «в найденных документах этого нет» полезнее, чем правдоподобное заполнение пробела.
Что проверить перед запуском в продакшене
Соберите небольшой фиксированный набор и запускайте его после каждого изменения индекса, модели, reranker или шаблона ответа. Минимальный отчёт должен показывать:
- долю полностью подтверждённых утверждений;
- долю частично подтверждённых;
- число неподтверждённых;
- долю вопросов без ответа;
- ошибки, вызванные отсутствием нужного фрагмента;
- ошибки при наличии правильного фрагмента;
- среднее число источников на ответ;
- задержку и стоимость проверки.
Не сравнивайте две версии только по среднему баллу. Новая система может улучшить faithfulness, но начать чаще отвечать «нет данных» на вопросы, где ответ действительно есть. Отдельно измеряйте полноту и полезность.
Перед внедрением также задайте порог отказа: при каком результате система не отвечает автоматически, а просит уточнить вопрос или передаёт его человеку. Для финансовых, медицинских и юридических документов такой порог должен быть строже, чем для внутреннего поиска по справочнику.
Проверка цитат RAG — это не тест на наличие ссылок. Надёжная схема связывает утверждение, конкретный фрагмент, версию документа и решение о том, достаточно ли этого подтверждения. Начните с малого набора реальных вопросов, разбирайте ошибки отдельно для поиска и генерации, а автоматические метрики используйте вместе с ручной проверкой. Перед следующим релизом прогоните тесты на отрицания, даты, лимиты и устаревшие версии — именно там аккуратный на вид ответ чаще всего расходится с источником.