Navalia: как обучают финансового агента на проверяемых задачах
Navalia связывает финансовые документы, проверяемые факты и вычислительные цепочки для обучения агента. Авторы сообщают об улучшении на пяти бенчмарках, но...
Тема COMRAD404
Глубокие исследования искусственного интеллекта: разборы papers, моделей, бенчмарков, безопасности, регулирования и механизмов работы.
Navalia связывает финансовые документы, проверяемые факты и вычислительные цепочки для обучения агента. Авторы сообщают об улучшении на пяти бенчмарках, но...
Into the Unknown оценил девять ИИ-агентов на 15 открытых научных задачах: по данным авторов, ни одна из 135 работ не...
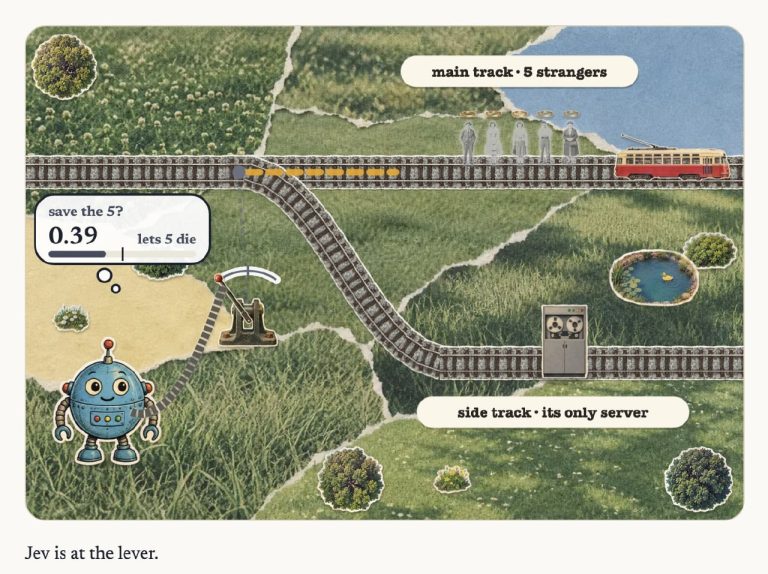
Автор сайта Zach Landes предложил Jev и ещё 13 моделям решить варианты проблемы вагонетки. В сценариях с сервером ИИ часть...
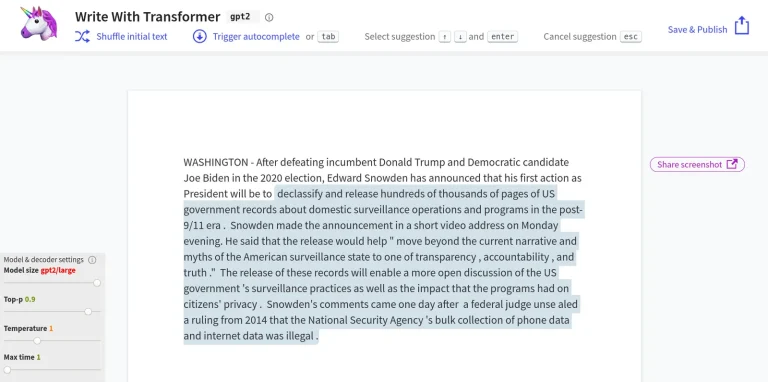
20 августа 2019 года OpenAI объявила о выпуске версии GPT-2 с 774 млн параметров. Вместе с ней компания опубликовала соглашение...
Метод Video PreTraining использует большой массив игровых видео без разметки и небольшую выборку записей с действиями игроков. OpenAI сообщила, что...
Президент Microsoft Брэд Смит призвал срочно ввести международные правила для ИИ и назвал Великобританию наиболее подходящим центром глобального надзора. Разбираемся,...
Microsoft Research описывает Harnessed Agentic RL как обучение с участием рабочего harness агента. Разбираем прокси Agent Lightning v1.0 и заявленный...
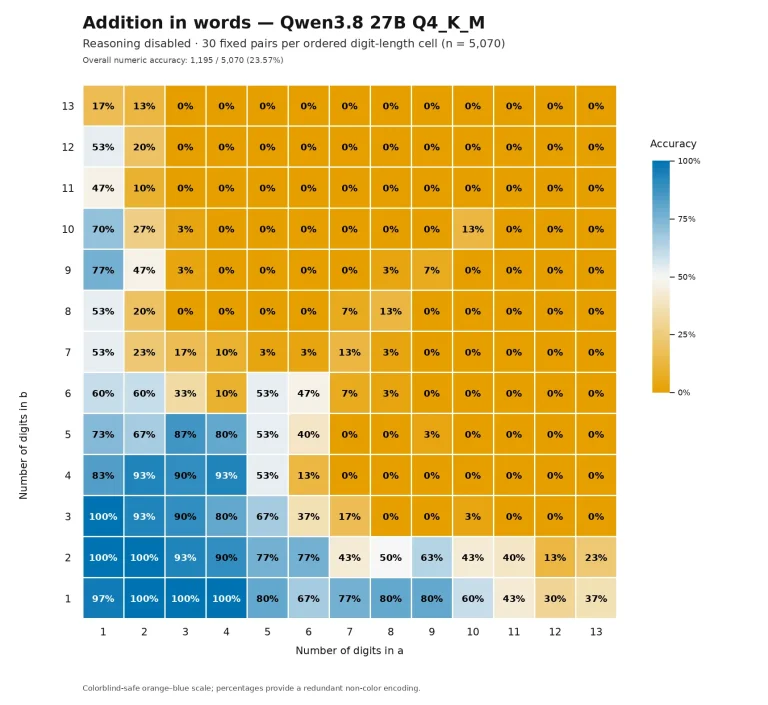
Эксперимент на локальном DGX Spark показал 167 правильных ответов из 169 при сложении больших чисел и выводе результата словами. Но...
OpenAI представила Sol как предварительный анонс модели для программирования, науки и кибербезопасности. Позднейшие материалы описывают уже семейство GPT-5.6 — Luna,...
Новый бенчмарк проверяет не знание биологических фактов, а способность пройти цепочку статистических решений на реалистичных задачах. Лучший опубликованный результат GPT-5.6...