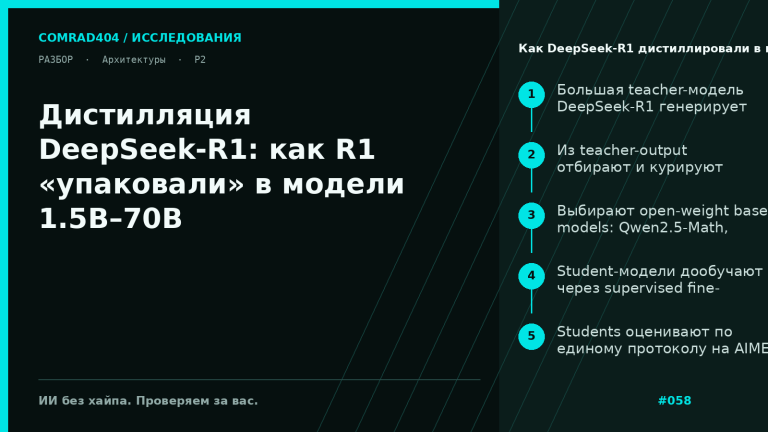
Дистилляция DeepSeek-R1: как R1 «упаковали» в модели 1.5B–70B
Разбираем первый релиз DeepSeek-R1 от 20 января 2025 года: что именно дистиллировали в Qwen и Llama, какие результаты показали модели...
Тема COMRAD404
Глубокие исследования искусственного интеллекта: разборы papers, моделей, бенчмарков, безопасности, регулирования и механизмов работы.
Разбираем первый релиз DeepSeek-R1 от 20 января 2025 года: что именно дистиллировали в Qwen и Llama, какие результаты показали модели...
Разбираем, из каких частей собирают длинный контекст в LLM: что делает RoPE, зачем нужны YaRN и LongRoPE, и почему без...
Разбираем работу Stability AI от 5 марта 2024 года: как MMDiT, синтетические подписи и стек текстовых энкодеров сделали Stable Diffusion...
Разбираем три главные корпоративные рамки безопасности frontier AI — Anthropic RSP, OpenAI Preparedness Framework и Google DeepMind FSF: пороги риска,...
Разбор работы Anthropic от 2 апреля 2024 о many-shot jailbreak: почему длинный контекст стал новым вектором обхода защит LLM, что...
Разбор Weak-to-Strong Generalization от OpenAI: как слабая модель может вытягивать более сильную, зачем нужен PGR, где метод сработал, а где...
Разбираем, как DPO заменил связку reward model и PPO одним loss-функционалом и зачем затем появились KTO, ORPO и SimPO. Где...
Разбираем, что именно показала работа Lost in the Middle, почему длинное окно не гарантирует использование всех фрагментов и как это...
Разбираем две ключевые работы 2023–2024 годов о самопроверке RAG: Self-RAG учит модель решать, когда искать и как критиковать ответ, а...
Brown et al. показали, что множество независимых попыток может заметно поднять качество LLM без нового обучения. Разбираем repeated sampling, результаты...