«Эмерджентность — мираж?»: разбор Schaeffer et al. о внезапных способностях LLM
Schaeffer и коллеги утверждают: многие «внезапные способности» LLM могут быть не скачком модели, а эффектом метрики. Разбираем, что именно показала...
Тема COMRAD404
Глубокие исследования искусственного интеллекта: разборы papers, моделей, бенчмарков, безопасности, регулирования и механизмов работы.
Schaeffer и коллеги утверждают: многие «внезапные способности» LLM могут быть не скачком модели, а эффектом метрики. Разбираем, что именно показала...
Разбираем работу Scale AI о GSM1k — закрытом аналоге GSM8k для проверки утечек. Что именно показал бенчмарк, почему в источниках...
Разбираем FrontierMath от Epoch AI в исторической версии 2024 года: как собрали задачи, почему ни одна модель не превышала 2%...
Разбираем Humanity’s Last Exam — бенчмарк CAIS и Scale AI для закрытых вопросов экспертного уровня. Что в нём меряют, почему...
Первый International AI Safety Report от 29 января 2025 года — это не манифест о «судьбе человечества», а карта научных...
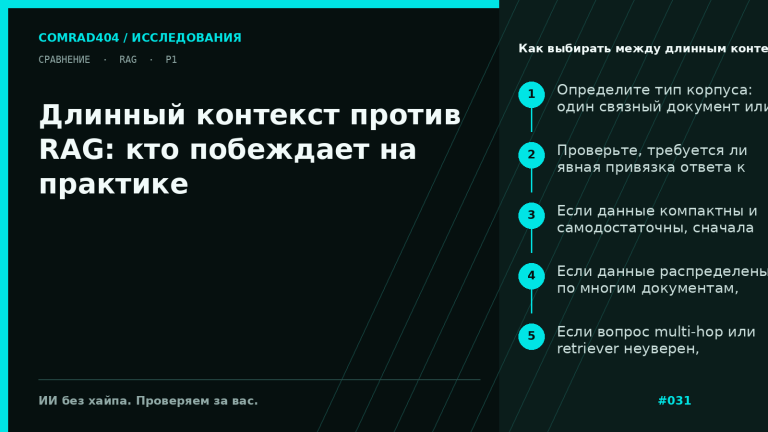
Сравниваем длинный контекст и RAG по первоисточникам 2024 года: где full-context действительно сильнее, где retrieval не сдал позиции, и почему...
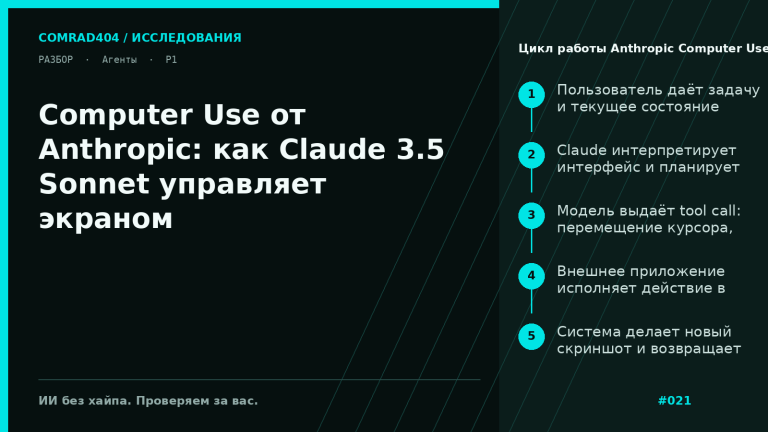
Разбираем запуск Computer Use от Anthropic 22 октября 2024 года: как Claude 3.5 Sonnet работает со скриншотами, почему упирается в...
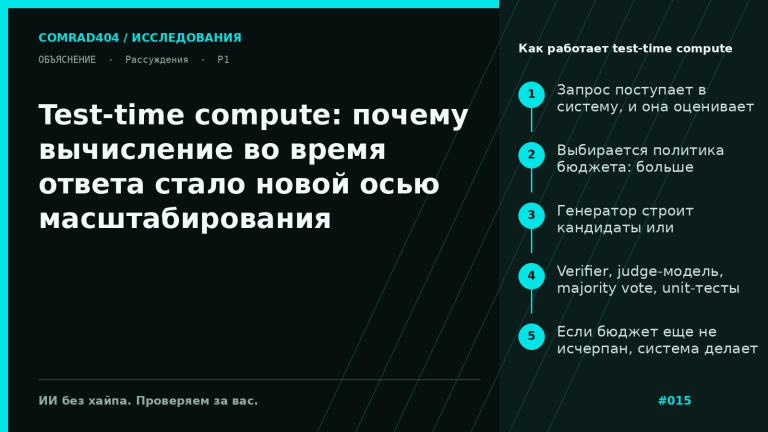
Test-time compute — это отдельный дизайн вычислений на этапе ответа: sampling, ревизии, verifier и поиск. Разбираем, как работы 2024 года...
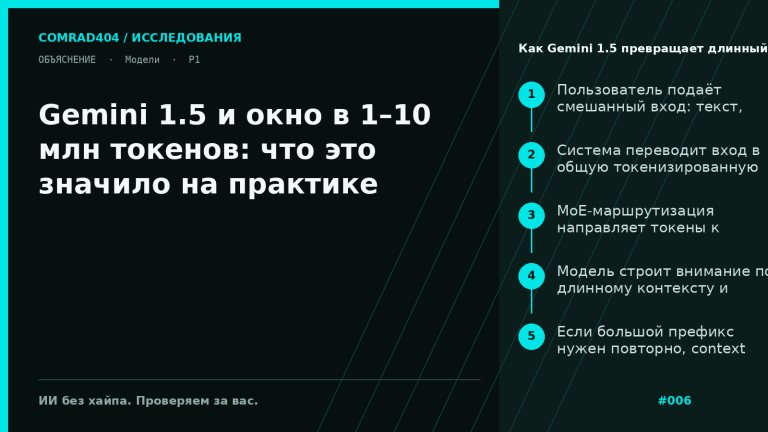
Разбираем исторический срез Gemini 1.5 в 2024 году: что Google DeepMind реально открыла разработчикам, где заканчивался продуктовый лимит и где...
Разбор Nature-статьи Shumailov et al. о model collapse: почему рекурсивное обучение на данных от ИИ стирает хвосты распределения, что показали...