CMU выложила открытый курс по ИИ-агентам: от обвязки до RL-обучения
Университет Карнеги — Меллон опубликовал на YouTube полный курс по созданию агентов. В программе — инструменты, память, планирование, дообучение и RL. Первое задание и стартовый...
COMRAD404
Новости, инструменты и практика ИИ
Университет Карнеги — Меллон опубликовал на YouTube полный курс по созданию агентов. В программе — инструменты, память, планирование, дообучение и RL. Первое задание и стартовый...
Метод POIL использует функциональные точки объекта для переноса показанного движения и замкнутого управления роботом без готовой 3D-модели или отдельного оценщика позы.
Автор представляет открытый проект Harness Router — слой принятия решений, который не даёт LLM наугад хвататься за инструменты, а проверяет и перепланирует вызовы.
Разобраться в теме
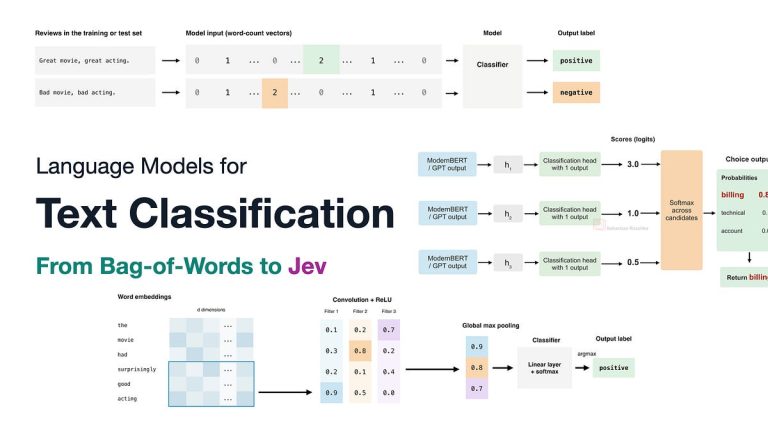
Себастьян Рашка проследил развитие классификации текста от bag-of-words до трансформеров и объяснил, где Jev может быть выгоднее универсальных LLM, а где уступит специализированной модели.
Исследователи MIT смоделировали рынок, на котором компании используют одинаковый алгоритм найма. Главным риском оказалась потеря разнообразия решений, а возможной защитой — ансамбль моделей.
Препринт HybridInfer описывает роутер, который выбирает между локальной, периферийной и облачной LLM с учётом теплового состояния смартфона, сложности запроса и стоимости инференса.
Рейтинг COMRAD404
Топ-100 моделей: качество, код, скорость и стоимость. С фильтрами и описанием методологии.
Открыть рейтингGitHub начал поэтапно подключать Claude Sonnet 5.5 в Copilot. По внутренним тестам компании, модель справляется с задачами программирования на уровне Sonnet 5, но использует меньше...
Разработчики превратили инженерный калькулятор в шпионский гаджет со скрытым ИИ-доступом и камерой. Вопросы к этике и практичности такого решения остаются открытыми.
GitHub уточнила график применения минимальных версий self-hosted runners в Enterprise Cloud. Полное включение требований начнется 29 сентября 2026 года; GitHub Enterprise Server изменение не затрагивает.
Авторы нового препринта проверили LLM-судью на базе gpt-4o-mini в рабочем Text-to-SQL-сервисе. На выборке с повышенной долей спорных случаев каппа Коэна составила 0,04, а самостоятельно размещённая...
OpenAI, CSET и Stanford Internet Observatory представили исследование о том, как большие языковые модели могут усилить кампании по дезинформации и какие меры помогут снизить связанные...
Авторы нового препринта описали каскадные атаки, при которых вредоносная цель распределяется между несколькими навыками ИИ-агента. Представленный ими SkillCascade-Bench содержит 213 проверенных сценариев.