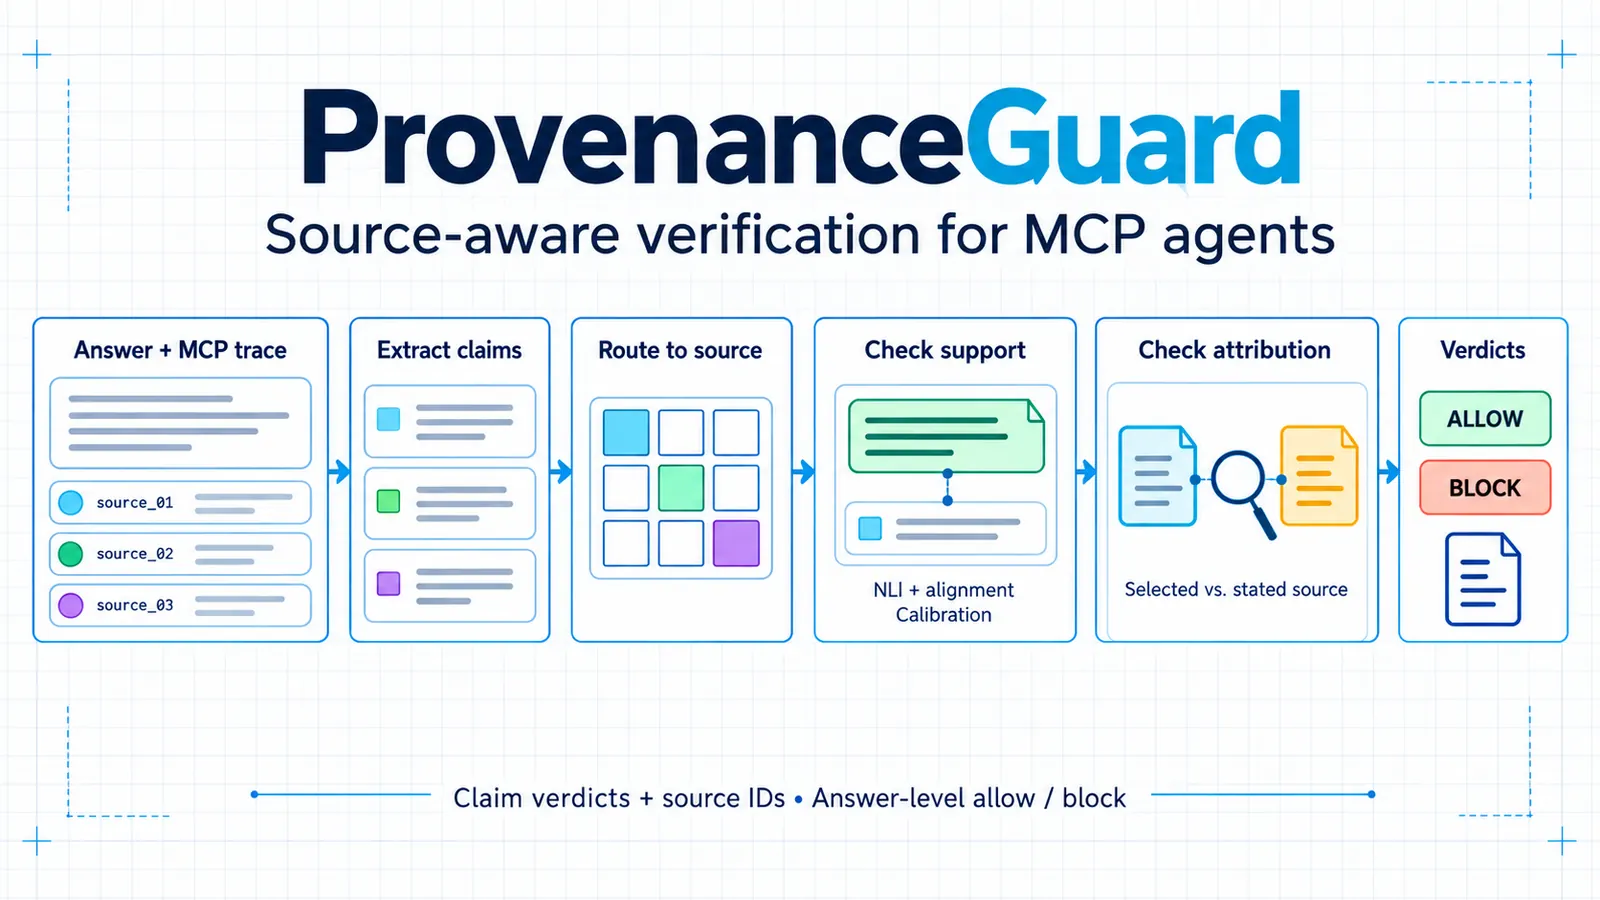
Исследователи представили ProvenanceGuard — постгенерационный метод проверки ответов LLM-агентов, подключённых к нескольким инструментам через Model Context Protocol. Система определяет, подтверждает ли выбранный источник каждое утверждение и соответствует ли он источнику, указанному или подразумеваемому в ответе.
Работа описана 29 сентября 2026 года в публикации на Hugging Face. Приведённые показатели получены авторами метода; в доступных материалах нет результатов независимого воспроизведения экспериментов.
Истинный факт с ошибочной атрибуцией
MCP позволяет агенту обращаться к поиску, базам данных, внутренним документам, пользовательским записям и другим инструментам в рамках одной задачи. При этом каждый вызов возвращает собственный набор данных. Общая архитектура и принципы работы протокола описаны в официальной документации MCP.
Проблема возникает, когда агент правильно воспроизводит факт, но называет неверное происхождение данных. Авторы ProvenanceGuard обозначают этот сбой как cross-source conflation — смешение источников.
Например, служба поддержки может сообщить: «Согласно данным вашей учётной записи, тариф предусматривает возврат в течение 30 дней». Само условие может существовать, но находиться в общем документе с правилами, а не в записи конкретного клиента. Если объединить результаты двух инструментов в один контекст, утверждение выглядит подтверждённым. При раздельной проверке становится видно, что агент ошибочно приписал общее правило персональной записи.
В медицинском сценарии последствия потенциально серьёзнее: сведения из истории пациента нельзя выдавать за вывод научной статьи, даже если формулировки совпадают. Поддержка утверждения где-либо в собранном контексте ещё не доказывает корректность его атрибуции.
Такие методы, как RAGAS Faithfulness, MiniCheck, AlignScore и SummaC, используются для оценки связи ответа с предоставленным контекстом. Например, описание метрики Faithfulness в документации RAGAS сосредоточено на том, можно ли вывести утверждения ответа из извлечённого контекста. По оценке авторов ProvenanceGuard, объединение свидетельств не позволяет установить, какой именно MCP-инструмент подтвердил конкретную фразу.
Пять этапов проверки
ProvenanceGuard работает после формирования ответа и не требует дообучать исходного агента. Метод получает MCP-трейс — журнал вызовов инструментов, их результаты и идентификаторы источников. Если агентская инфраструктура не сохраняет эти данные, полноценно применить подход не получится.
Проверка состоит из пяти этапов:
Ответ разбивается на отдельные проверяемые утверждения.
Для каждого утверждения выбирается наиболее релевантный источник из трейса.
3. Система оценивает, подтверждает ли выбранный источник содержание утверждения.
4. Найденный источник сопоставляется с тем, который агент назвал прямо или обозначил косвенно.
5. Формируется вердикт для каждого утверждения и итоговое решение: пропустить либо заблокировать весь ответ.
Отдельно проверяются числа, даты и идентификаторы. Если конкретное значение отсутствует в выбранном источнике, одной семантической похожести недостаточно для положительного решения.
В экспериментальной конфигурации MiniLM использовалась для поиска релевантного источника, модель DeBERTa для вывода на естественном языке — для проверки поддержки, а локальная языковая модель — для декомпозиции ответа. Авторы выбрали локальный стек, чтобы обрабатывать трейсы в контролируемой офлайн-среде. Это реализация эксперимента, а не обязательная архитектура: компоненты можно заменить облачными моделями, но такую конфигурацию придётся тестировать и калибровать заново.
Заблокированный ответ может быть направлен на исправление в стиле RARR с последующей повторной проверкой. Описание исходного подхода к редактированию ответов с опорой на найденные свидетельства доступно в работе RARR.
Медицинский тест показал высокую чувствительность
Авторы исследовали 281 реальный трейс медицинского агента, который обращался к записям пациентов, научным публикациям и другим инструментам. Для основного теста эксперты разметили 361 утверждение из 40 ответов, отделённых от данных, применявшихся при разработке системы.
Эксперты решили, что 139 утверждений не должны проходить проверку. ProvenanceGuard заблокировал 138 из них и пропустил одно. Вместе с тем система задержала ещё 67 утверждений, которые эксперты считали подтверждёнными. Иными словами, высокая чувствительность достигнута ценой дополнительных проверок корректного материала.
Такой баланс может быть оправдан для клинических, финансовых или корпоративных систем, где ошибочная атрибуция дороже задержки ответа. Для массового помощника или службы поддержки с большим потоком запросов дополнительные блокировки означают рост задержек и стоимости ручного контроля.
Среди утверждений, для которых можно было определить источник, метод выбирал его правильно примерно в 86% случаев. Авторы также сравнили ProvenanceGuard с четырьмя другими средствами проверки на том же наборе утверждений. По использованной в работе метрике он показал лучший баланс между выявлением недопустимых утверждений и лишними блокировками. При этом ключевым результатом исследователи считают сохранение проверяемой связи «утверждение — источник», которой не выдавали сравниваемые системы.
Похожие источники остаются слабым местом
В отдельном усложнённом тесте, где системе приходилось различать несколько похожих источников, F1 для решения о блокировке составила 0,846. Однако точный источник был определён правильно только для 50,3% утверждений.
Эти показатели измеряют разные задачи. Система может верно решить, что утверждение следует остановить, и одновременно ошибиться при выборе документа или инструмента, который лучше всего объясняет проблему. Поэтому значение F1 нельзя интерпретировать как точность атрибуции.
Ограничена и предметная область исследования. Основные результаты получены на данных медицинского агента. Они не подтверждают автоматически такую же эффективность в банковских сервисах, юридических помощниках, корпоративном поиске или технической поддержке. В этих системах будут отличаться структура источников, длина документов, качество метаданных и допустимый уровень ложных блокировок.
Нельзя считать доказанной и универсальность выбранных порогов. Консервативная настройка, подходящая для медицинских ответов, может оказаться слишком строгой для менее рискованных задач.
Что проверить в работающем MCP-агенте
Главный практический вывод для разработчиков касается телеметрии. Добавить источник после генерации ответа сложнее, чем сохранить его идентификатор в момент вызова инструмента. Команде, планирующей подобную проверку, стоит провести тест на собственных трассах:
- сохраняются ли идентификатор инструмента, версия документа и время получения данных;
- можно ли связать отдельные фразы ответа с конкретными результатами вызовов;
- различает ли система персональные записи, внутренние правила и публичные материалы;
- блокируются ли числа и даты, которых нет в выбранном источнике;
- сколько подтверждённых утверждений ошибочно отправляется на исправление;
- может ли человек увидеть основание для каждого вердикта.
Особенно показателен тест с намеренной перестановкой атрибуции: факт оставляют правильным, но указывают рядом другой источник из того же трейса. Обычная проверка по объединённому контексту может не заметить подмену. Система контроля происхождения должна её обнаружить.
ProvenanceGuard демонстрирует способ проводить такую проверку поверх уже работающего агента, однако опубликованные цифры пока относятся к авторской реализации и ограниченному медицинскому набору. Перед внедрением потребуются собственные трассы, экспертная разметка и отдельная оценка того, сколько корректных ответов выбранный порог отправляет на повторную обработку.