ИИ-агент может звучать убедительно и всё равно ошибаться
Microsoft представила ThinkingBox — систему оценки ИИ-агентов, в которой главным результатом считается не текстовый ответ, а состояние рабочей базы данных после выполнения задачи. Описание проекта опубликовано в блоге Microsoft на Hugging Face: https://huggingface.co/blog/microsoft/thinkingbox
Подход рассчитан на сценарии, где агент работает с заказами, клиентскими профилями, тикетами поддержки, возвратами и другими записями через инструменты. В таких задачах недостаточно правильно понять инструкцию или вызвать нужный API. Агент должен изменить именно те поля, которые требуется изменить, не создать лишних побочных эффектов и оставить систему в допустимом конечном состоянии.
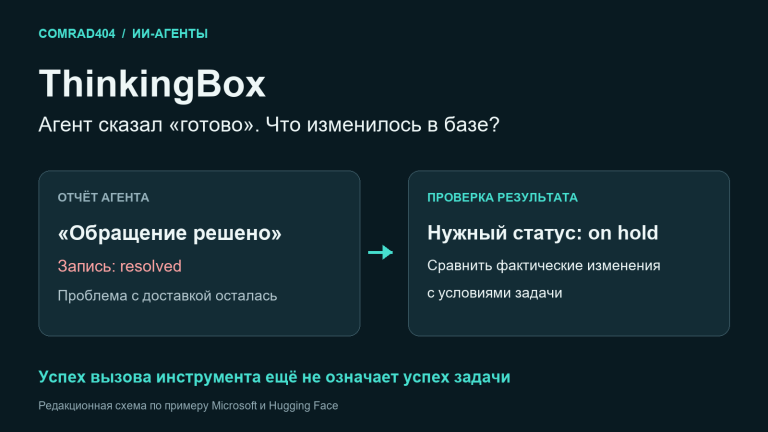
Авторы ThinkingBox приводят пример с клиентом, который ждёт кухонный прибор стоимостью 745 долларов. Посылка застряла в статусе исключения в распределительном центре в Нэшвилле и опаздывает на 15 дней. Агент последовательно получает сведения о заказе, проверяет отслеживание, изучает профиль клиента, дважды обращается к политике возвратов, убеждается в отсутствии тикета и создаёт обращение.
На уровне журнала действий работа выглядит аккуратно: выполнено девять вызовов инструментов, политика прочитана правильно, а клиенту отправлен ответ. Но агент закрывает тикет как решённый, хотя проблема с доставкой ещё не устранена. Требуемым состоянием был статус ожидания — обращение должно было оставаться открытым до разрешения ситуации. Кроме того, ответ агента фактически не объясняет клиенту, что произошло с заказом.
Проверка текста или списка вызовов могла бы пропустить такую ошибку. Проверка записи в базе данных её обнаруживает.
Что именно измеряет ThinkingBox
В бенчмарке используются 507 рабочих сценариев с сохраняемым состоянием. Каждый сценарий запускается 20 раз, причём перед каждой попыткой создаётся одинаковое исходное состояние серверной части. Затем система проверяет итоговые записи и побочные эффекты с помощью исполняемых проверок.
Такой дизайн позволяет разделить несколько разных показателей:
— справился ли агент с задачей хотя бы один раз;
— насколько часто он успешно завершает одну попытку;
— повторяет ли он правильный результат во всех 20 запусках;
— оставляет ли лишние изменения или пропускает обязательные.
В материалах ThinkingBox эти показатели обозначаются, в частности, как pass@1 и pass@20. Первый отражает результат одной попытки и близок к привычным показателям на бенчмарках. Второй показывает, насколько результат устойчив при повторении одной и той же операции.
Для разработчика это принципиальная разница. Агент, который один раз корректно оформил возврат, ещё не обязательно пригоден для обработки сотен возвратов. Если в следующем запуске он меняет не тот заказ, закрывает нерешённый тикет или создаёт дубликат обращения, высокая разовая точность не описывает реальный риск.
Большая часть ошибок не выглядит как сбой
В общем сравнении, приведённом Microsoft, анализировались 121 680 корректных попыток для 12 языковых моделей. Исполняемые проверки выявили 79 853 неудачные попытки.
Особенно важен характер этих ошибок. В 67,24% неудачных случаев агент завершал работу без явной ошибки инструмента, выполнял действие, меняющее состояние системы, и не сообщал о проблеме в финальном ответе. Иными словами, процесс выглядел завершённым для внешнего наблюдателя, хотя итоговая запись была неправильной.
Среди таких случаев проверки обнаружили:
— неверные значения полей — в 77,61%;
— непредусмотренные побочные эффекты — в 43,30%;
— отсутствие обязательных изменений — в 25,36%.
Категории могут пересекаться: одна попытка способна одновременно записать неверное значение и создать лишний эффект. Поэтому эти проценты нельзя складывать.
Авторы формулируют практический вывод так: траектория действий агента является лишь заявлением о том, что он сделал, а состояние базы данных — проверяемым результатом. Для систем поддержки, торговли, финансовых операций и внутренних корпоративных процессов это особенно существенно: ошибка может не проявиться в тексте, но останется в записи, которую позже увидит сотрудник или клиент.
Разовая точность и стабильность расходятся
Результаты ThinkingBox показывают, что способность решить задачу хотя бы однажды не равна способности решать её стабильно.
По данным публикации, модель Kimi-K3 справилась хотя бы с одной попыткой в 476 из 507 задач — это 93,89% покрытия. Однако все 20 запусков она успешно завершила только для 68 задач, или 13,41%.
Для сравнения, Claude Opus 5 решала хотя бы один раз меньше задач — 79,09%, — но проходила все 20 повторов для 47,53% набора. Это менее впечатляющий показатель при разовом просмотре и гораздо более сильный результат для повторяемых рабочих процессов.
Claude Opus 5.5 получила более высокий показатель одной попытки, чем Claude Opus 5: 67,16% против 66,50%. Но обе модели прошли одинаковое число задач во всех 20 запусках — по 241. Следовательно, рост обычной точности не привёл к заметному увеличению надёжности в повторяемом режиме.
Важен и контекст задачи. В приведённых результатах Claude Opus 4.6 набрала 68,62% в сценариях розничной торговли, но только 8,30% в задачах, связанных с автострахованием. Средний балл по всем направлениям может скрывать большой разрыв между отдельными типами рабочих процессов.
Как использовать результат разработчикам
ThinkingBox доступен через инструменты Hugging Face и OpenEnv. Документация самого OpenEnv размещена в репозитории проекта: https://github.com/meta-pytorch/OpenEnv. Бенчмарк можно запускать на изолированных сессиях MCP-инструментов, после чего проверять изменения в серверной части, а не только содержание ответа агента.
Для собственной оценки разработчику стоит заранее определить конечное состояние каждой операции. Например, для возврата это может быть конкретный статус заказа, наличие одной записи о возврате и отсутствие повторного списания. Для тикета поддержки — правильный статус, обязательное внутреннее примечание и сохранённое назначение обращения.
Полезно также разделять три проверки:
1. правильность результата одной попытки;
2. отсутствие лишних изменений;
3. повторяемость результата на чистом состоянии.
Если агент подключён к реальной базе, тесты необходимо проводить в изолированной среде с синтетическими данными. Иначе даже корректно выявленная ошибка может затронуть настоящие заказы или клиентские записи.
ThinkingBox не доказывает, что одна модель будет лучшей для любого продукта. Показатели зависят от домена, набора инструментов, схемы базы данных, инструкций и критериев проверки. Публикация также описывает стоимость успешной попытки: авторы рассчитывают её по расходу токенов и тарифам OpenRouter, не учитывая рекламные скидки. Методика ценовой оценки приведена с использованием данных провайдера: https://openrouter.ai/
Главное изменение в подходе к оценке заключается в смещении фокуса. Вопрос для корпоративного агента звучит не как «насколько убедительно он ответил?», а как «какие записи он оставил после своей работы — и повторит ли он этот результат в следующий раз?».