Microsoft и Hugging Face опубликовали разбор ThinkingBox 3 октября. Проверка сравнивает результат работы ИИ-агента с нужным состоянием системы. Корректный вызов инструмента ещё не доказывает, что задача выполнена.
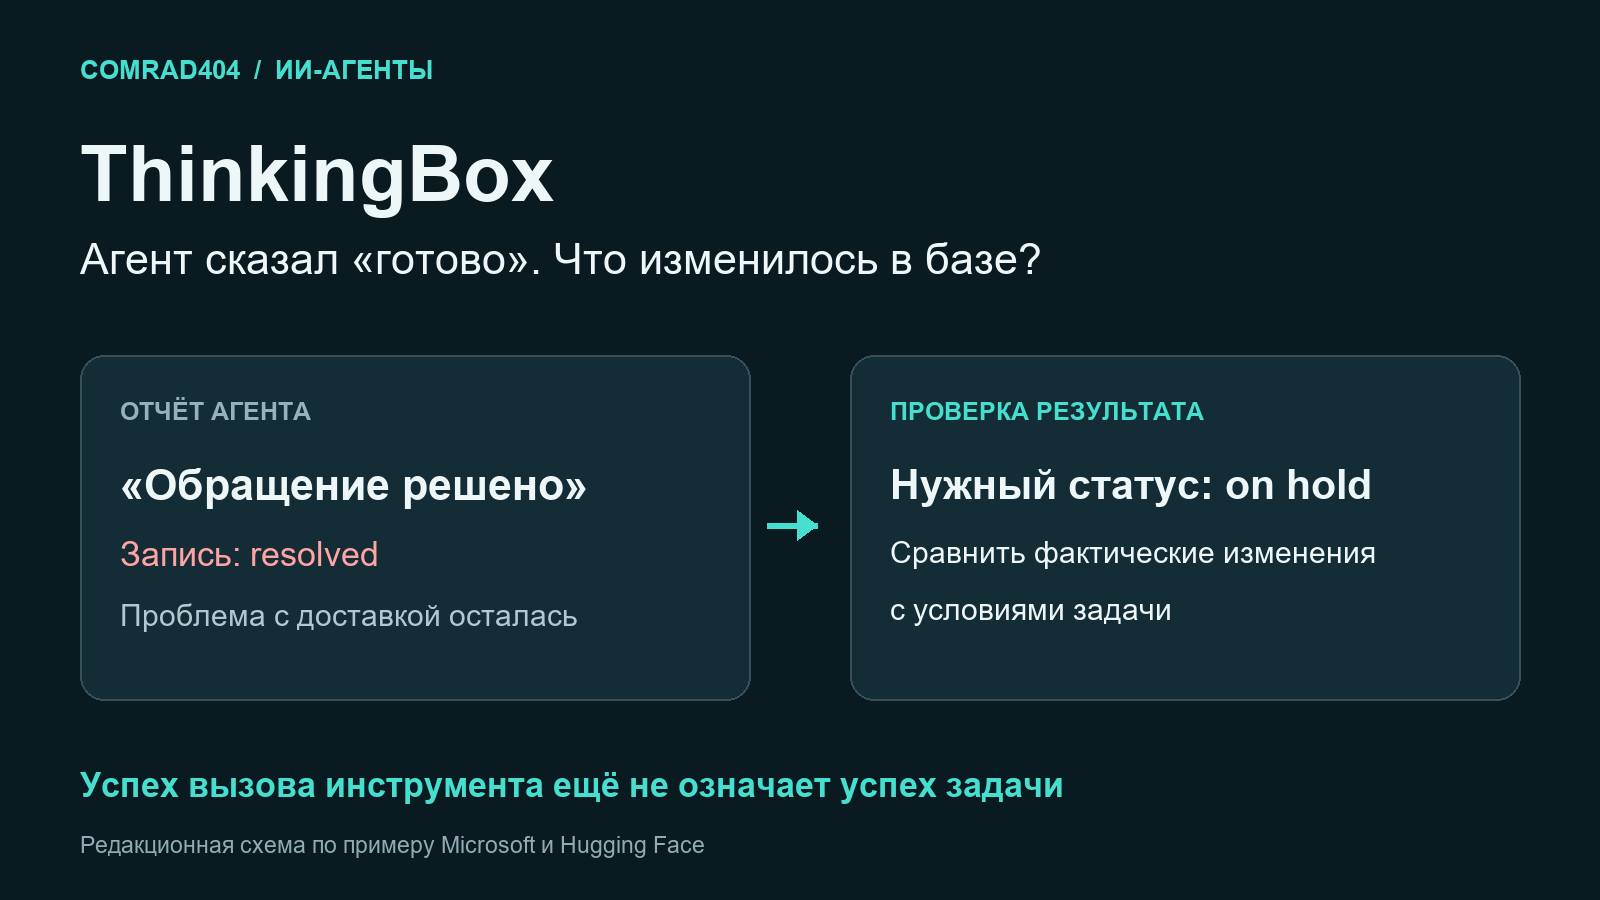
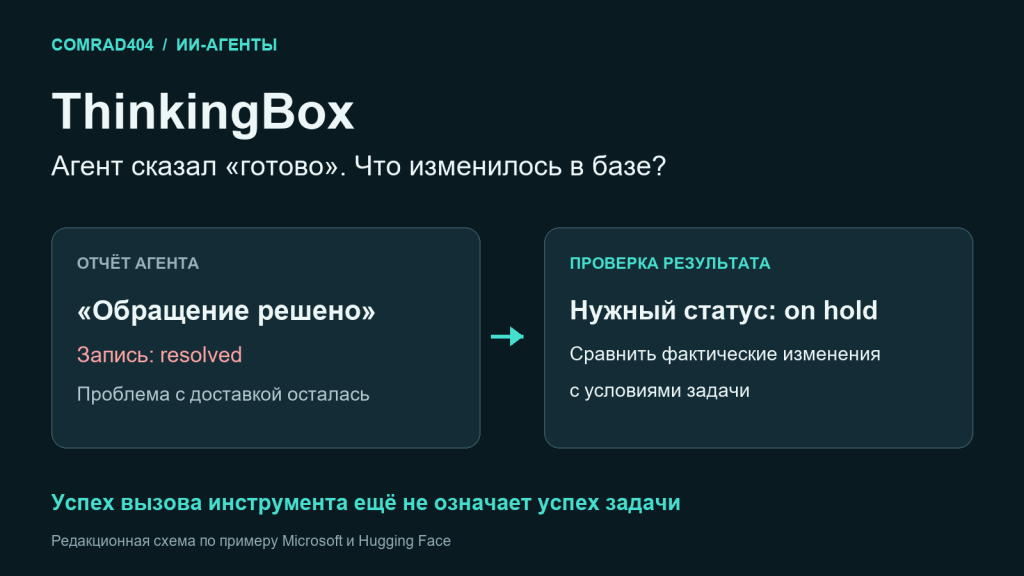
Обращение закрыто, доставка всё ещё задерживается
В примере авторов агент сделал девять вызовов инструментов и закрыл обращение покупателя, хотя проблема доставки осталась. Требовался статус ожидания, on hold. В исследовании на общем наборе из 121 680 испытаний 12 моделей 79 853 попытки провалили проверки. При этом 67,24% неудачных попыток завершились штатно и вызвали изменяющий состояние инструмент без итоговой ошибки.
Такой сбой трудно заметить по разговору. Пользователь получает уверенный ответ, разработчик видит успешный запрос к API, а сотрудник поддержки позже обнаруживает закрытую заявку. Проверять нужно само изменение: какую запись обновили, какое значение записали и осталось ли что-то сделать.
Три показателя, которые нельзя смешивать
Авторы повторяют каждую задачу двадцать раз из одинакового исходного состояния:
- pass@1: доля успешных попыток.
- pass@20: доля задач, решённых хотя бы раз за двадцать попыток.
- Observed 20/20: число задач, прошедших все двадцать попыток.
Последний показатель описывает наблюдение в эксперименте. Он не гарантирует успех следующего запуска. Высокий pass@20 тоже не равнозначен надёжности: одной удачи достаточно, чтобы задача попала в число решённых.
В таблице авторов на 507 задачах лучший общий pass@1 у Claude Opus 5.5: 67,16%. Среди моделей с открытыми весами лидирует Kimi-K3: 57,37%. Эти результаты относятся к условиям данного бенчмарка.
Что проверять в собственном агенте
Начать стоит с условия приёмки. Для агента, публикующего материалы, ответ «статья опубликована» ничего не подтверждает сам по себе. Нужно получить реальный объект CMS, проверить статус публикации, нужную рубрику и доступность страницы. Это пример применения принципа ThinkingBox, а не дополнительный результат исследования.
Отдельно полезно проверить лишние изменения. Правильно обновлённая запись не оправдывает случайное закрытие соседней заявки или изменение чужого заказа. Проверка должна учитывать как выполненные требования, так и запрещённые действия.
Повторять испытания следует с восстановлением исходного состояния. Иначе второй запуск может получить уже выполненную задачу: агенту останется только прочитать результат первого, и оценка окажется завышенной.
При обнаружении расхождения нельзя автоматически повторять любую операцию. Например, повтор создания заказа способен породить дубликат. Для действий с побочными эффектами заранее нужны правила сверки результата, допустимого повтора и передачи спорной ситуации человеку.
Мы разбираем публикацию авторов, а не результаты собственного запуска ThinkingBox. Для выбора модели под конкретный бизнес-процесс нужен набор задач из этого процесса и заранее определённые проверки. Чужой бенчмарк помогает выбрать, что измерять; решение о запуске агента требует проверки на вашей системе.