Qwen3.8-27B правильно решил 167 из 169 задач на сложение больших чисел в эксперименте на локальном NVIDIA DGX Spark. На первый взгляд это почти идеальный результат: точность составила около 98,8%. Но главный вывод здесь не в том, что языковая модель внезапно превратилась в калькулятор. Эксперимент показывает более узкую и полезную вещь: при включённом reasoning модель способна довольно устойчиво выполнять позиционное сложение, проверять промежуточные шаги и исправлять часть собственных ошибок.
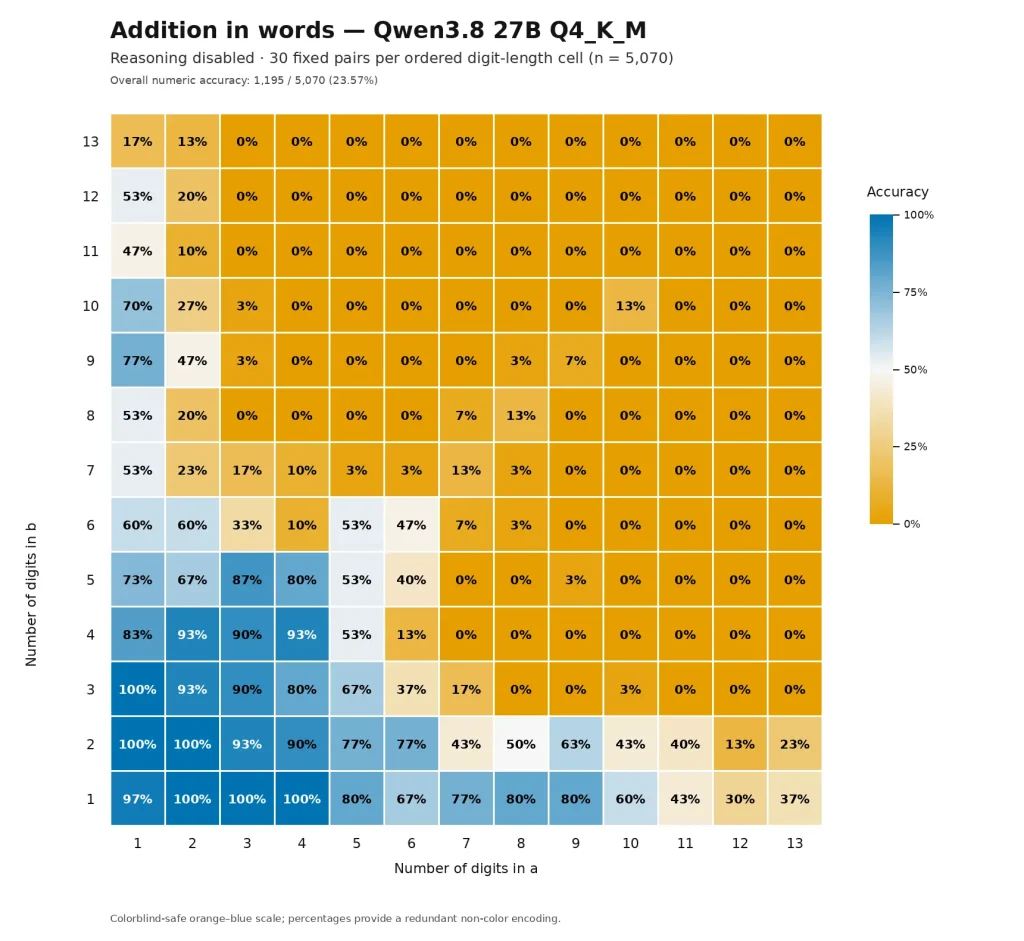
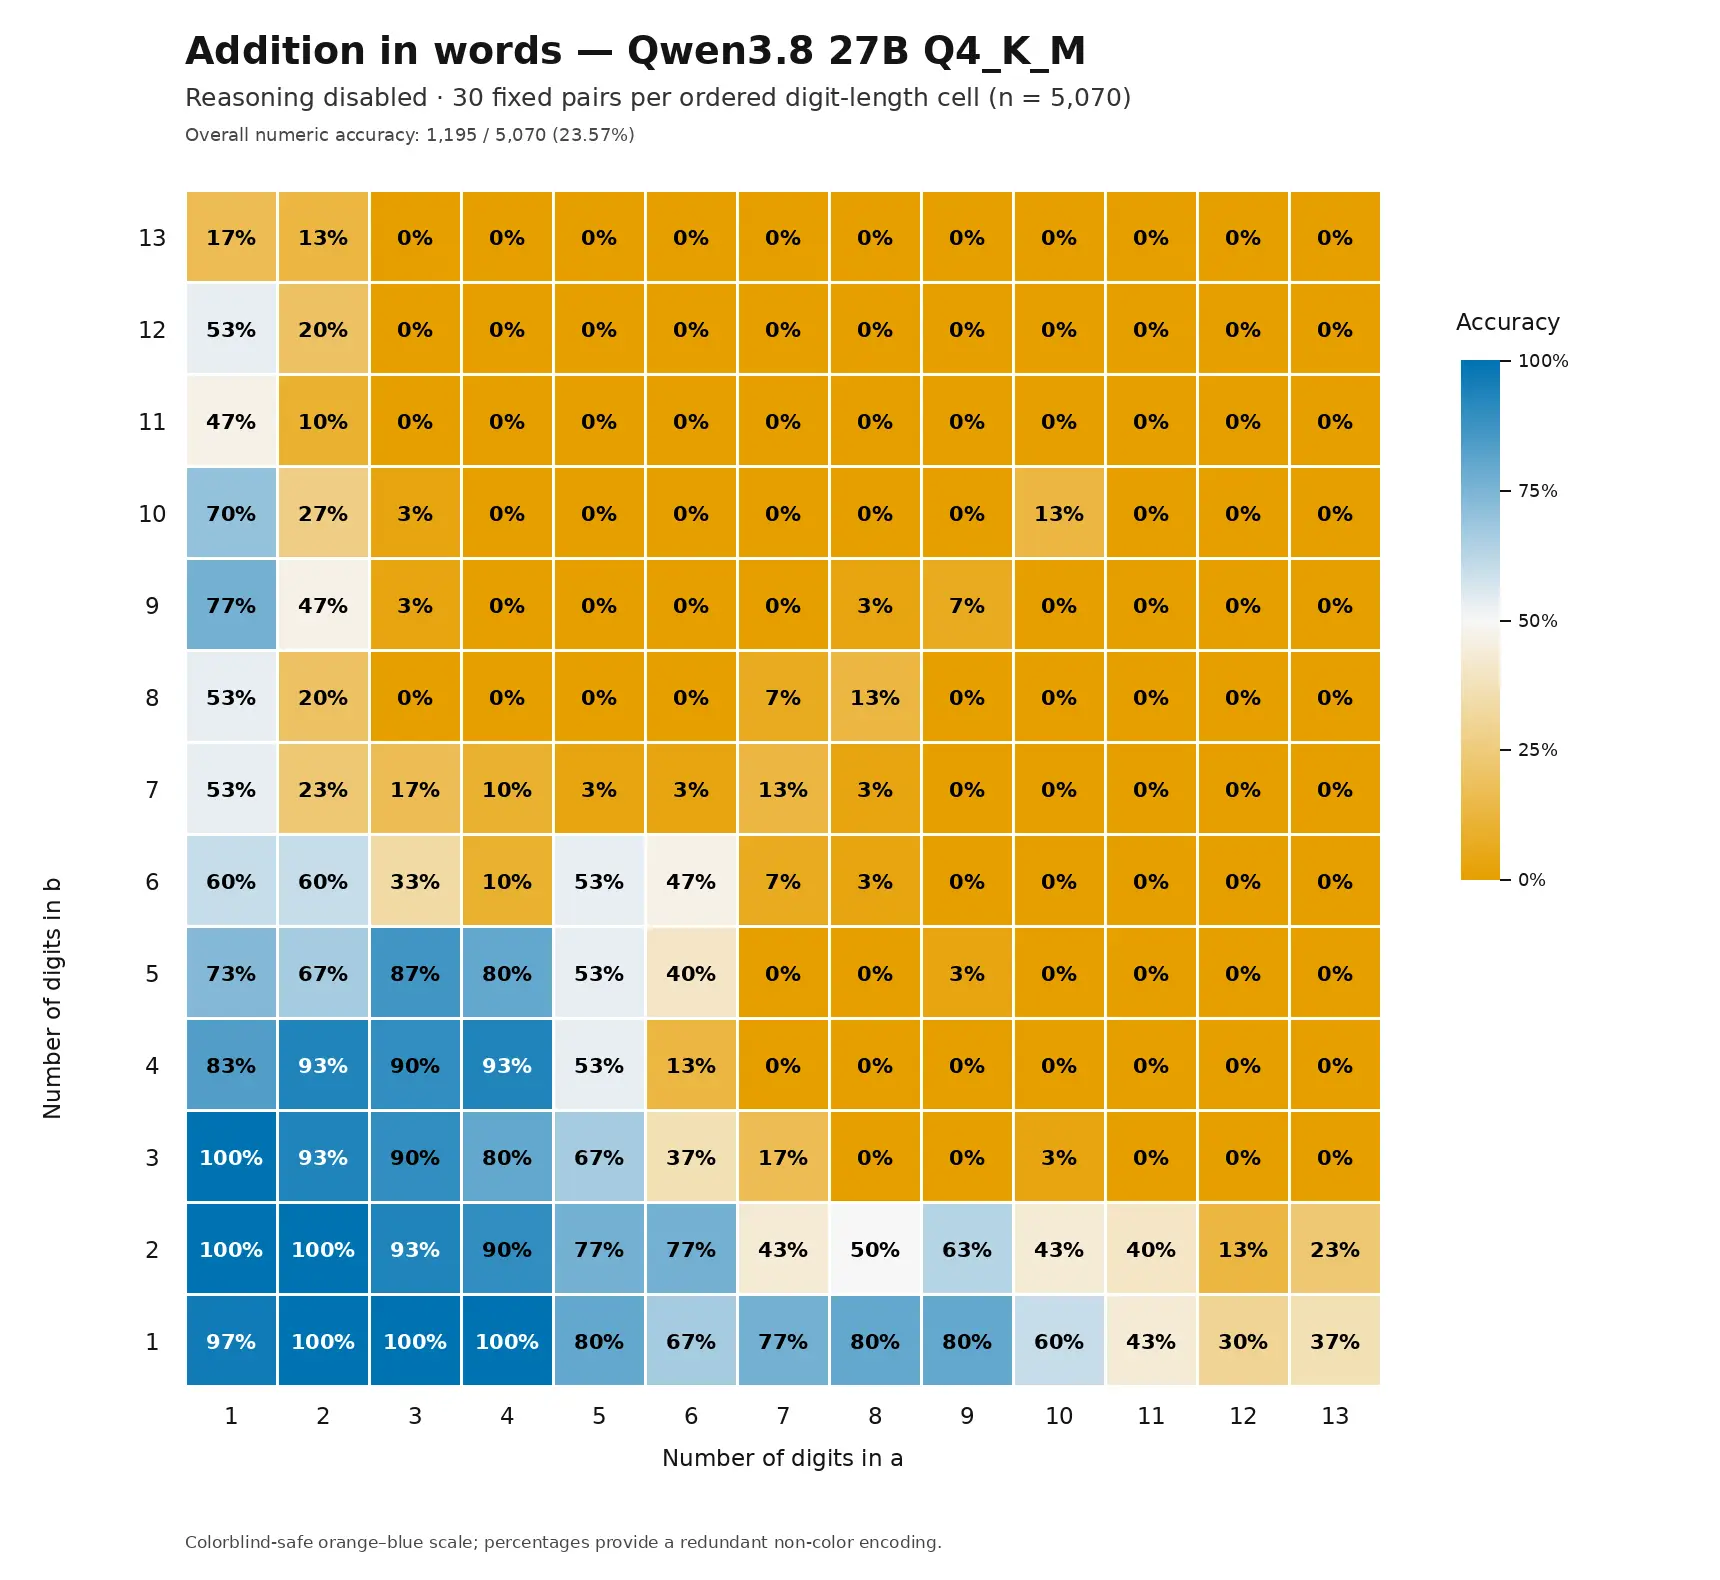
Одновременно тест хорошо демонстрирует границы такого вывода. В режиме без рассуждений автор запускал по 30 попыток для каждой комбинации чисел, а в режиме с рассуждениями — только по одной попытке. Поэтому две тепловые карты нельзя напрямую сравнивать как два равных измерения. Кроме того, результат зависит от формата запроса, параметров генерации, конкретной сборки модели и того, что считать правильным ответом.
Именно поэтому этот тест интереснее как исследование поведения локальной LLM, чем как очередной «экзамен по математике».
Что именно проверяли
Исходная идея принадлежит Колину Фрейзеру. Более двух лет назад он проверял GPT-4o на задаче, сформулированной примерно так: вычислить сумму, но вернуть ответ словами. В тесте использовались всё более крупные числа. Такой формат важен: модели приходится не только выполнить арифметическую операцию, но и преобразовать итог в естественный язык.
Это существенно сложнее, чем кажется. Большие числа представлены для языковой модели последовательностью токенов, а не удобными для вычислений машинными регистрами. Ошибка может возникнуть на любом этапе:
- модель неправильно выровняет разряды;
- забудет перенос единицы;
- неверно перепишет один из операндов;
- правильно посчитает сумму, но ошибётся при переводе результата в слова;
- выдаст правдоподобный, но неверный ответ без проверки.
В исходном эксперименте GPT-4o часто ошибалась. Автор нового теста отдельно отмечает, что не считает вероятным использование встроенного калькулятора: большое количество неверных ответов скорее указывает на самостоятельное выполнение операции моделью. Это, однако, остаётся интерпретацией поведения, а не доказательством отсутствия скрытого инструмента.
Саймон Уиллисон повторил эксперимент на локальном оборудовании. Он использовал файл Qwen3.8-27B-Q4_K_M.gguf и запускал его на NVIDIA DGX Spark. Изображение с исходными результатами было передано в удалённую сессию Codex, после чего модель должна была воспроизвести ту же схему испытаний.
Здесь есть важная методологическая деталь: тест проверяет не абстрактную «математическую способность» Qwen3.8-27B, а связку из нескольких компонентов — конкретные веса, квантизацию Q4_K_M, рантайм, настройки генерации и инструкцию. Это измерение поведения одной локальной конфигурации, а не универсальный рейтинг модели.
Почему режим reasoning дал другой результат
Эксперимент провели в двух режимах.
В первом reasoning был отключён. Для каждой комбинации чисел запускали 30 попыток. Это позволяет получить не только долю правильных ответов, но и примерную устойчивость поведения: если модель решила одну и ту же задачу 29 раз из 30, это отличается от случая, когда она дала правильный ответ один раз из одного.
Результаты были представлены в виде тепловой карты. Каждая ячейка показывает, как часто модель справлялась с конкретным сочетанием размеров чисел. Такая визуализация полезна для поиска границы сложности: можно увидеть, при каком количестве разрядов точность начинает снижаться и возникают ли отдельные «острова» ошибок.
Во втором запуске reasoning включили. Это заметно увеличило время обработки каждой пары, поэтому вместо 30 повторов на квадрат тепловой карты сделали одну попытку. В результате каждая ячейка могла быть только полностью правильной или полностью неправильной — 100% либо 0%. Это делает изображение менее информативным, но позволяет оценить общий результат одной серии.
Qwen3.8-27B ответила правильно в 167 случаях из 169. Это примерно 98,8% успешных решений. Автор подчёркивает, что при однократных запусках две ошибки не следует воспринимать как стабильную характеристику именно этих задач: повторный прогон, вероятно, дал бы другой набор ошибок.
Такая оговорка принципиальна. Если модель ошиблась в одной ячейке при 30 независимых попытках, можно обсуждать частоту ошибки. Если она ошиблась один раз в режиме one-shot, мы видим лишь один конкретный исход случайного процесса. Разница между «модель ошибается на этой категории задач» и «модель ошиблась в этой конкретной генерации» огромна.
Что происходит в цепочке рассуждений
В отчёте с трассами reasoning виден характерный фрагмент работы модели. Для двух чисел:
4 299 366 105 622
6 088 794 067 970
Qwen3.8-27B сначала переписывает операнды, выравнивая их по разрядам, а затем складывает справа налево. На первых шагах она явно фиксирует промежуточные значения:
- единицы: 2 + 0 = 2;
- десятки: 2 + 7 = 9;
- сотни: 6 + 9 = 15, записать 5 и перенести 1.
Особенно показателен не сам факт пошагового сложения, а возможность исправления. В трассе встречается фраза «Wait, let me redo this more carefully» — модель останавливается и пересматривает вычисление. Она не просто выдаёт один ответ, а пытается сверить выравнивание цифр и переносы.
Это может объяснять высокий результат reasoning-режима. При выключенном рассуждении модель вынуждена сразу сопоставить вход, вычисление и словесный вывод. При включённом режиме у неё появляется больше промежуточных токенов, в которых можно обнаружить ошибку и повторно пройти по разрядам.
Но reasoning-трасса не является независимым доказательством корректности. Текст «я перепроверю» может быть убедительным даже тогда, когда вычисление остаётся неверным. Модель генерирует объяснение тем же механизмом, которым генерирует ответ, поэтому подробность рассуждения не равна математической верификации.
Для надёжной проверки нужен внешний контроль: второй независимый вычислительный путь, обычный калькулятор, интерпретатор Python или сравнение с эталонным набором. В описанном тесте ценность как раз в том, что автор сознательно изучал поведение модели в контролируемой локальной среде, а не пытался представить reasoning как замену арифметическому инструменту.
Что означает результат 167 из 169
Если рассматривать только опубликованную серию с включённым reasoning, цифра выглядит впечатляюще. Модель корректно выполнила почти все задания, включая операции с большими числами и преобразование ответа в слова. Для локальной модели на 27 млрд параметров это сильное практическое наблюдение.
Qwen3.8-27B — плотная модель: при обработке каждого токена активируются все 27 млрд параметров. В руководстве Linas’s Newsletter указано, что версия Q4 занимает примерно 17–18 ГБ, а запуск вместе с KV-кэшем возможен на одной потребительской видеокарте с 24 ГБ памяти, например RTX 3090 или RTX 4090, а также на некоторых системах Apple Silicon. Это объясняет интерес к тесту: речь идёт не только о лабораторной модели, но о системе, которую можно запускать локально.
Однако 167 из 169 нельзя превращать в «98,8% точности на математике». В тесте было всего 169 one-shot-попыток, причём не сообщается полная таблица всех входов и ошибок в кратком описании. Неизвестно, как менялась точность при разных размерах чисел, были ли задания равномерно распределены и одинаково ли сложны. Неизвестно также, как оценивался словесный ответ: строгое совпадение, нормализация написания числительных или ручная проверка.
Для оценки общего арифметического навыка понадобились бы как минимум:
несколько независимых наборов операндов;
одинаковое число повторов в обоих режимах;
3. фиксированные параметры генерации;
4. автоматическая проверка числового результата;
5. отдельная проверка перевода числа в слова;
6. сравнение с другими локальными моделями и обычным калькулятором.
Без этого правильнее говорить: в конкретной серии Qwen3.8-27B показала 167 правильных ответов из 169, а не «научилась считать с точностью 98,8%».
Небольшая проверка, которую можно повторить
Самый полезный способ интерпретировать эксперимент — разделить его на три независимых задачи.
Сначала нужно проверить арифметику. Берём два длинных числа, складываем их обычным скриптом и сохраняем результат. Затем передаём модели только операнды и просим вернуть сумму цифрами. На этом этапе нельзя засчитывать ответ, если он выглядит убедительно, но отличается хотя бы на один разряд.
Затем проверяется преобразование в слова. Эталонное число уже известно, поэтому модель не должна дополнительно выполнять сложение. Ей предлагается записать готовый результат словами. Это позволяет понять, где находится источник ошибки: в арифметике или в языковом преобразовании.
Наконец, соединяем обе операции в исходном формате: «вычисли сумму и верни ответ словами». Если точность резко падает именно здесь, проблема может быть не в сложении как таковом, а в удержании промежуточного результата и переключении между двумя представлениями числа.
Для честного сравнения нужно запускать каждую пару не один раз, а, например, 30 раз с фиксированными настройками. Важны температура, top-p, максимальная длина ответа и системная инструкция. При температуре выше нуля правильность одной генерации не гарантирует повторяемость. При temperature 0 результат обычно стабильнее, но особенности конкретного рантайма всё равно могут влиять на декодирование.
Ещё один полезный вариант — попросить модель сначала вывести вычисление цифрами, затем отдельной строкой — число словами, а после этого автоматически проверить оба поля. Так можно отличить ошибку в вычислении от ошибки форматирования. Но это уже будет другая задача, и её нельзя напрямую сравнивать с первоначальным требованием вернуть только словесный результат.
Локальная модель против калькулятора
Практический вывод для разработчика достаточно простой: Qwen3.8-27B может быть хорошим исполнителем арифметических инструкций в агентном сценарии, но не должна быть единственным вычислительным механизмом.
Если агенту нужно посчитать бюджет, размер файла, срок или сумму платежей, надёжная архитектура выглядит иначе:
- языковая модель разбирает запрос;
- извлекает числа и единицы измерения;
- формирует выражение;
- передаёт его калькулятору или коду;
- получает машинный результат;
- формулирует ответ для пользователя;
- при необходимости показывает исходные данные и проверку.
В такой схеме Qwen3.8-27B полезна как локальный интерпретатор и координатор. Она может работать без отправки пользовательских данных во внешний API, а локальный запуск даёт контроль над версией модели, параметрами и журналом запросов. Но непосредственное сложение лучше поручить детерминированному инструменту.
Это особенно важно для больших чисел. Ошибка на одном переносе может изменить итог на тысячи или миллионы, а естественный язык легко маскирует проблему. Подробное объяснение с выровненными цифрами повышает проверяемость, но не заменяет машинную валидацию.
Почему эксперимент всё равно важен
Тест ценен не потому, что установил окончательный математический рейтинг Qwen3.8-27B. Его значение в другом: он показывает, как меняется поведение одной и той же локальной модели при добавлении reasoning и увеличении вычислительного бюджета.
Модель не получила новый внешний калькулятор. Она получила возможность дольше развернуть промежуточное решение, заметить несоответствие и повторить часть вычисления. В приведённой трассе это видно буквально: Qwen3.8-27B выравнивает числа, проходит разряды справа налево и возвращается к решению после сомнения.
Но высокая точность может измениться при других условиях. Сложнее форматирование, отрицательные числа, десятичные дроби, ведущие нули, перенос результата через границу разрядов или требование одновременно объяснить метод могут дать другую картину. То же относится к другой квантизации, рантайму и параметрам генерации.
Следующий убедительный этап исследования — опубликовать полный набор входов, эталонные ответы, все генерации и настройки запуска, а затем повторить тест на нескольких локальных моделях. Особенно полезно было бы сопоставить one-shot и 30-кратные серии при одинаковых уровнях сложности. Если результат сохранится на новых данных, можно будет говорить о стабильной способности модели выполнять длинное позиционное сложение.
Пока же формулировка должна оставаться точной: Qwen3.8-27B в конкретном локальном эксперименте почти безошибочно справилась с задачей на сложение больших чисел и вывод результата словами. Это сильный результат для языковой модели, но не основание отключать калькулятор в реальном приложении.