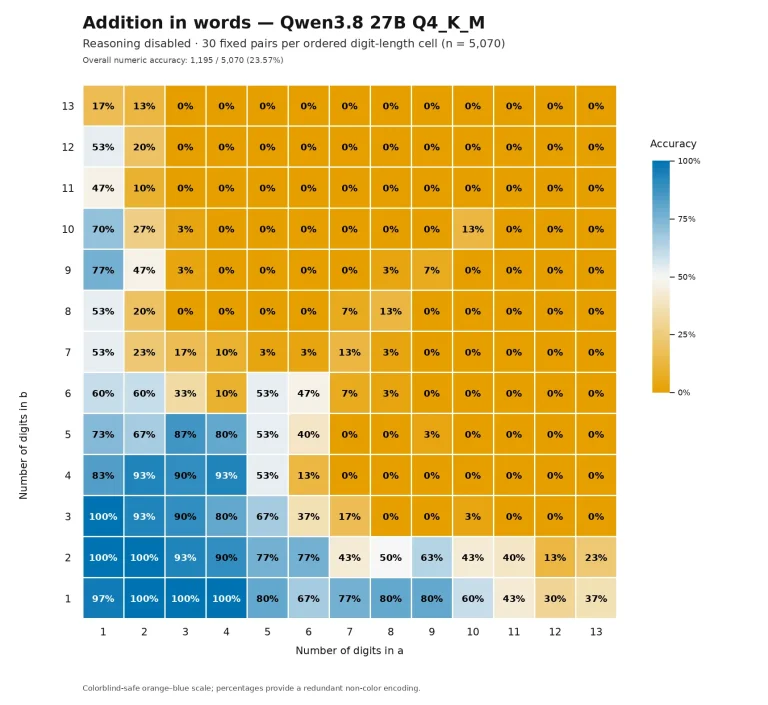
Qwen3.8-27B почти не ошибся в сложении — но это не значит, что он умеет считать
Эксперимент на локальном DGX Spark показал 167 правильных ответов из 169 при сложении больших чисел и выводе результата словами. Но...
Тема COMRAD404
Эксперимент на локальном DGX Spark показал 167 правильных ответов из 169 при сложении больших чисел и выводе результата словами. Но...
Метод CCPS (Chopthin-Consensus Power Sampling) предлагает новый подход к сэмплированию на этапе инференса LLM, заменяя агрессивное обнуление весов на их...
NVIDIA опубликовала открытый эталонный агент AI-Q, построенный на двух Llama-моделях. Он занял первое место на бенчмарке DeepResearch Bench, обойдя закрытые...
Исследователи OpenAI опубликовали набор из 13 тестов для оценки того, насколько внутренние рассуждения языковых моделей поддаются мониторингу. Результаты показывают, что...
Инженер-программист с двадцатилетним стажем ставит под сомнение способность современных LLM достичь AGI. Он анализирует фундаментальные ограничения авторегрессивной генерации и приходит...
Модель OpenAI o1 использует внутреннюю «цепочку мыслей» для решения сложных задач. Разбираем архитектурные особенности, тесты производительности и ограничения новой парадигмы...
Разбираем ключевые улучшения Gemini 2.5 Pro: расширение контекстного окна до 1 млн токенов, нативные рассуждения (thinking) и продвинутое использование инструментов....
Reasoning‑модели (OpenAI o1, o3, DeepSeek R1) меняют правила промптинга. Стандартные chain‑of‑thought подсказки здесь не нужны, а иногда вредят. Разбираем, какие...