Что меняет Agile Deliberation
Google Research представила Agile Deliberation — подход с участием человека для создания классификаторов изображений по субъективным понятиям, где граница между «подходит» и «не подходит» заранее неочевидна. Описание MarkTechPost опубликовано 4 ноября 2026 года. Для разработчика это означает настройку критериев на примерах до запуска классификации, без дообучения модели.
Подход рассчитан на категории вроде «здоровой еды», «вдохновляющего искусства» и контента, который выглядит как результат оплаты за продвижение. Здесь нужно не только распознать объект, но и согласовать смысл самой категории.
Как формируется правило
Agile Deliberation превращает расплывчатое понятие в структурированное письменное определение. Оно одновременно служит политикой разметки для человека и текстовым промптом для VLM-классификатора. После раунда сохраняется вариант определения с лучшим F1 на пользовательских метках.
На первой стадии Gemini 2.5 Pro разбивает категорию максимум на три составных понятия, а затем предлагает для них положительные и отрицательные подклассы с найденными изображениями. Так обсуждение переносится с абстрактного слова вроде «здоровый» на конкретные признаки и исключения.
Зачем нужны пограничные изображения
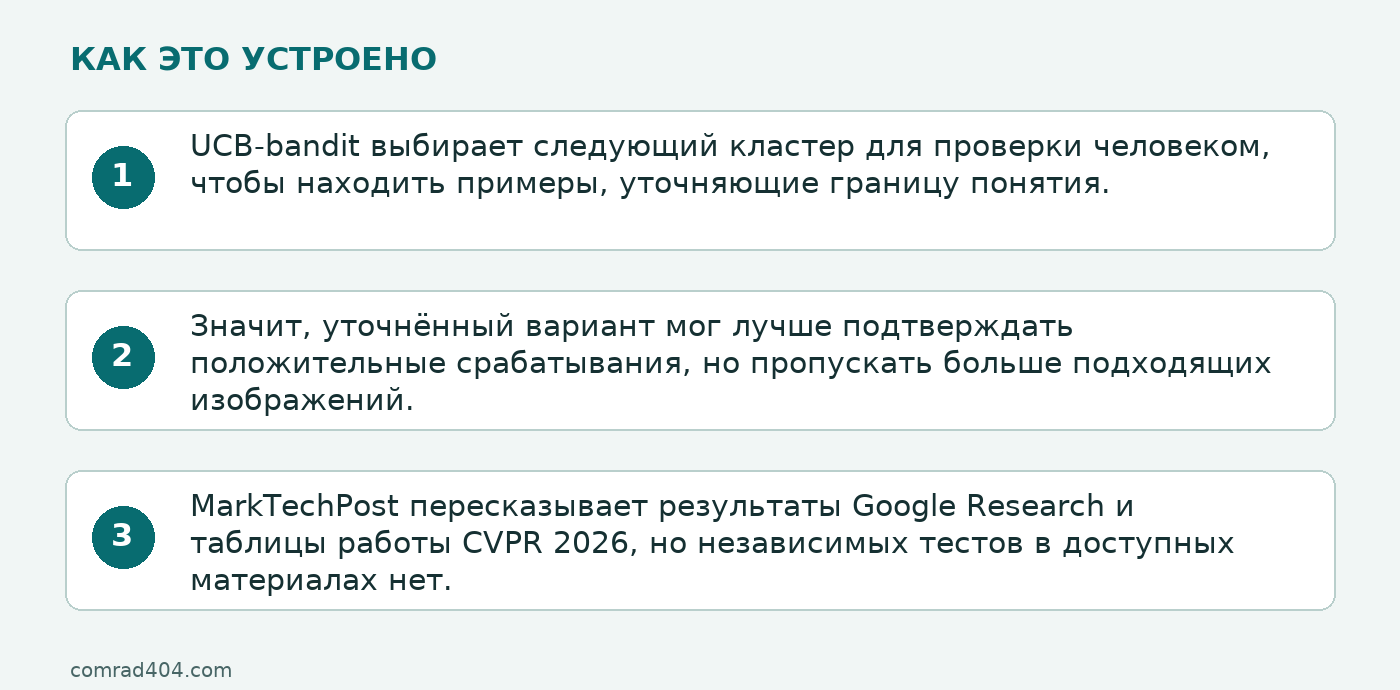
Система формирует текстовые запросы и получает по 50–100 изображений на запрос, удаляет дубликаты и группирует результаты. UCB-bandit выбирает следующий кластер для проверки человеком, чтобы находить примеры, уточняющие границу понятия. Для поиска используются CLIP-эмбединги и индекс FAISS, работающий на CPU или GPU.
На практике это переносит часть работы с обучения модели на итеративную разметку: разработчику всё равно нужно просматривать спорные изображения и решить, какой баланс между precision и recall подходит его задаче.
Какие результаты заявлены
В пересказе MarkTechPost средний F1 оказался на 10,5 процентного пункта выше, чем у zero-shot Gemini 2.5 Flash. Показатель получен в 18 живых сессиях на двух концепциях. Для «paid to play» F1 вырос с 0,48 до 0,59, а precision — с 0,35 до 0,57, то есть на 22 процентных пункта.
Рост F1 сопровождался снижением recall. Для «paid to play» он упал с 0,80 до 0,63, или на 17 процентных пунктов; для «healthy food» снижение составило 15 процентных пунктов. Значит, уточнённый вариант мог лучше подтверждать положительные срабатывания, но пропускать больше подходящих изображений.
Что потребуется для запуска
Описанное демо запускается в Jupyter или Google Colab и обращается через API к Gemini 2.5 Pro и Gemini 2.5 Flash. Также нужны ключ Gemini API, CLIP-эмбединги и индекс FAISS. Стартовый индекс занимает около 260 МБ, а полный вариант из 100 сегментов — около 13 ГБ.
Границы оценки
По описанию источника девять участников без профессионального опыта модерации провели по две примерно 90-минутные сессии, всего 18 сессий; после этого они разметили по 200 отложенных тестовых изображений. MarkTechPost пересказывает результаты Google Research и таблицы работы CVPR 2026, но независимых тестов в доступных материалах нет. Поэтому прирост нельзя считать универсальным преимуществом для любых категорий. Стоимость API, доступность кода и воспроизводимость запуска отдельно не подтверждены.