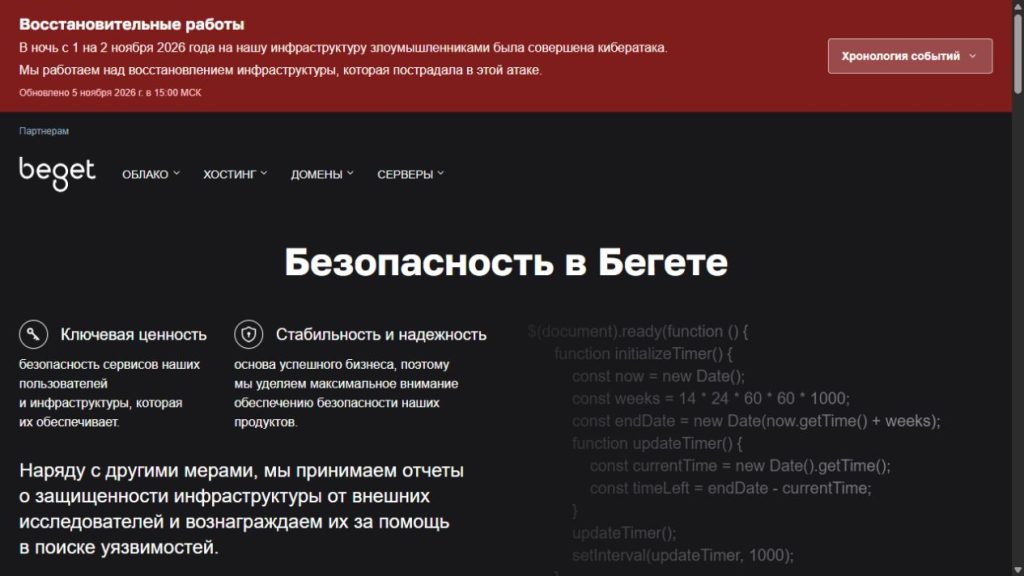
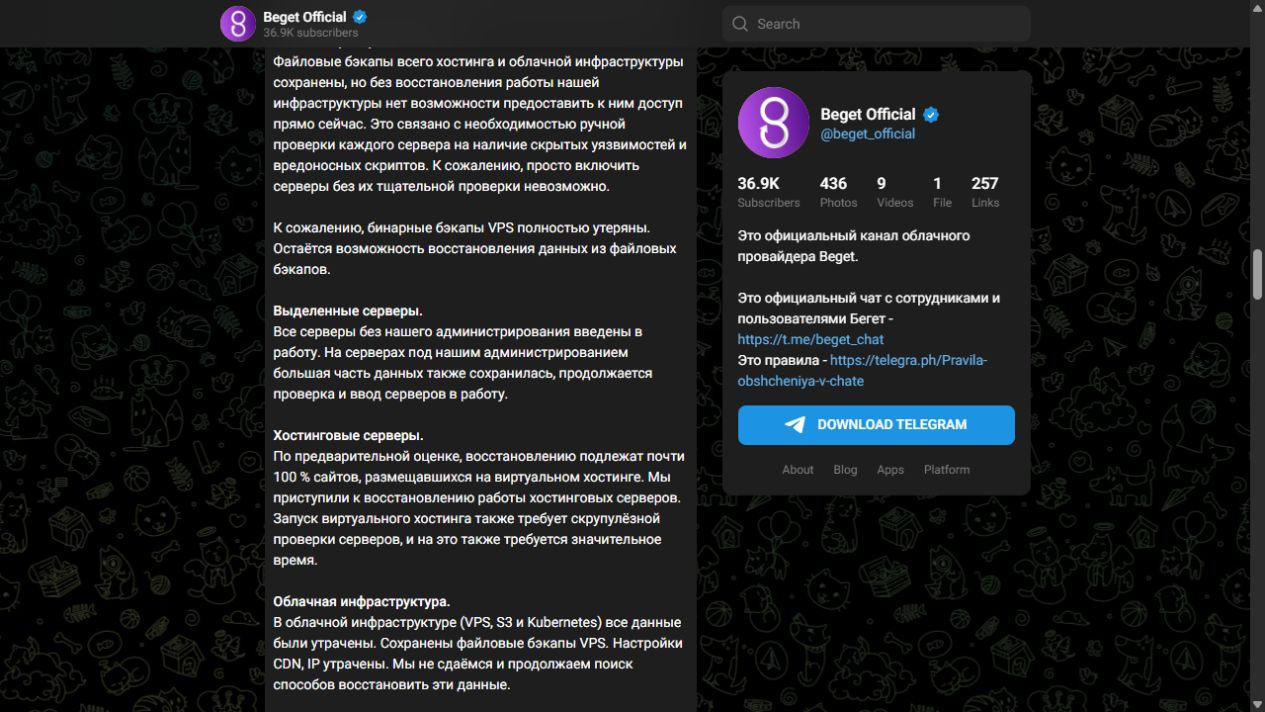
В ночь с 1 на 2 ноября 2026 года злоумышленники получили доступ к управляющему контуру в инфраструктуре Beget и запустили скрипты, обнуляющие данные. Провайдер сообщает об утрате рабочих данных VPS, S3 и Kubernetes, бинарных резервных копий VPS, настроек CDN и IP; файловые резервные копии большинства VPS при этом сохранились, гарантии по всем данным нет. Это два разных уровня восстановления, и путать их не стоит: «копия есть» не значит «сервер включится как раньше», а «данные потеряны» не значит, что файлы нельзя вернуть из сохранённых копий (Заявление Beget о состоянии данных). Причины атаки, конкретная уязвимость, CVE и виновник официально не раскрыты. Автоматически связывать это с октябрьскими событиями вокруг PHP нет оснований.
Владельцу сайта или сервера действовать нужно по своей услуге, а не по общим новостям. Сначала определите, что именно у вас было у Beget: виртуальный хостинг, VPS, выделенный сервер, S3, Kubernetes или только домен с DNS. От этого зависит и сценарий, и то, что реально можно запросить у поддержки. Сохраните все письма, тикеты и уведомления: они понадобятся, если спор понадобится решать позже. Не запускайте случайные скрипты восстановления и не передавайте незнакомцам ключи, архивы и доступы к панели. Имеющиеся копии уберите из зоны риска: отключите синхронизацию, автоудаление старых снимков и любые задачи, которые могут перезаписать архив рабочей версией.
Проверено 5 ноября 2026, по Москве; последний учтённый апдейт Beget — от 5 ноября.
Что подтвердил Beget и что остаётся неизвестным
- 2 ноября, ночь. Beget публикует хронологию: около 02:00 — начало, 02:30 — запуск ПО удаления, 02:40 — обнаружение, 02:55 — отключение сети. Это опубликованная провайдером хронология, а не результат независимого расследования (Статус и хронология инцидента).
- Подробное заявление компании. Beget сообщила, что попыток скачать или изменить данные на серверах пользовательских данных не замечено. Отсутствие замеченных попыток не означает, что секреты в безопасности: их всё равно стоит перевыпустить (Заявление Beget о состоянии данных).
- Управление DNS. На странице domains.beget.ru управление DNS доступно для всех доменов, обслуживаемых через Beget, включая международные. Менять записи там имеет смысл, только если домен использует NS Beget; иначе зоной управляет текущий DNS-провайдер (Управление DNS в domains.beget.ru).
Неизвестным остаётся вектор входа, конкретная первоначальная уязвимость, полный технический postmortem и точные сроки по сильно пострадавшим серверам. Провайдер отдельно пишет, что не раскрывает часть деталей, пока это может повредить безопасному запуску инфраструктуры.
Провайдеры облачных услуг обычно разделяют две плоскости: гостевую, где работает ваша операционная система, приложения и данные, и управляющую, которая создаёт и останавливает виртуальные машины, управляет хранилищем, сетью и доступом. AWS описывает такое разделение в модели общей ответственности: провайдер защищает инфраструктуру хоста, а клиент отвечает за гостевую ОС и приложения (aws.amazon.com). Это пример общей архитектуры, а не описание устройства конкретного провайдера.
Поэтому доступ к управляющему контуру опаснее взлома одного сайта: из этой плоскости можно влиять на множество ресурсов сразу, включая те, что находятся за пределами вашей гостевой ОС. Патч CMS или PHP закрывает конкретную уязвимость приложения, но не устраняет риск компрометации инфраструктуры. Облачный управляющий контур и права на управление хостами находятся вне клиентской гостевой ОС, не внутри неё. Отсюда и вывод для резервных копий: копия, лежащая в том же управляющем или учётном контуре, может стать недоступной вместе с основной системой. Нужны независимые права и внешний слой хранения.
Какие услуги пострадали и что можно восстановить
Разница в таблице важна по одной причине: от неё зависит, что именно запрашивать и чего не ждать.
| Услуга | Что сообщено | Что из этого следует для плана |
|---|---|---|
| VPS, файловые копии | Большая часть файловых бэкапов сохранилась, готовится выдача | Можно рассчитывать на выдачу файловой копии; её состав, включая конфигурацию, нужно уточнить. Это не прежний загрузочный образ со всем окружением |
| VPS, бинарные копии | Утеряны полностью | Прямое восстановление «как было» из такого образа недоступно |
| Виртуальный хостинг | Работает часть серверов; по оценке, подлежит восстановлению почти 100% сайтов | Оценка не означает мгновенного доступа: серверы проверяют и вводят вручную |
| S3 и Kubernetes | Данные в облаке заявлены утраченными; файловые копии VPS сохранены | Нужны собственные внешние копии объектов и состояния кластера |
| Выделенные без администрирования Beget | 100% введены в работу | Доступ есть, но проверка своих сервисов и доступов остаётся на владельце |
| Выделенные с администрированием Beget | 40% работают, остальные восстанавливают | Проценты относятся к серверам, а не к вашим данным или ко всем клиентам |
| DNS | Управление записями: при NS Beget — через domains.beget.ru, при других NS — у текущего DNS-провайдера | Сначала проверьте целевую площадку, затем при необходимости меняйте DNS-записи |
Отдельно про почту: заявлено 99% работающих почтовых серверов и доступный webmail. На практике сначала проверьте отправку, приём, SPF/DKIM/DMARC и очереди, а не только вход в интерфейс (Сроки восстановления VPS и панели).
Текущее восстановление и два этапа выдачи бэкапов
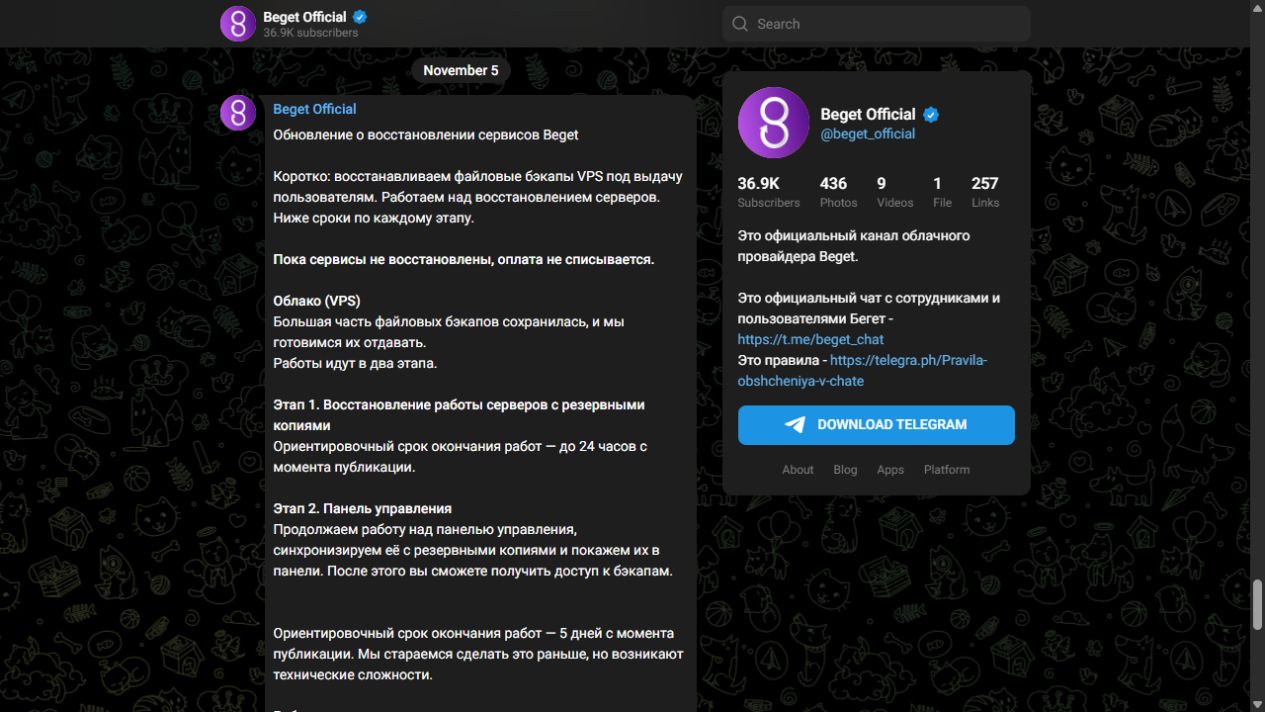
Восстановление идёт в два параллельных этапа. Серверы с резервными копиями VPS обещают вернуть до 24 часов с публикации поста 5 ноября, панель с доступом к копиям — примерно через 5 дней с того же момента. Это ориентиры этапов, а не срок для каждого отдельного сервера: по данным Beget, работы стараются ускорить, но возникают технические сложности (Сроки восстановления VPS и панели). Пока сервисы не восстановлены, оплата не списывается.
Что делать в первые 30 минут
- Составьте список своих услуг Beget: домены, хостинг, VPS, выделенные серверы, S3, Kubernetes, почта, CDN. Отметьте, какие зависят друг от друга.
- Сохраните уведомления, письма и тикеты в отдельную папку; зафиксируйте, что именно перестало работать и когда.
- Защитите то, что уцелело: остановите автосинхронизацию, задачи автоудаления снимков и любые скрипты, которые могут перезаписать старые копии новыми.
- Приостановите автоматические деплои, миграции, массовые повторы платежей, рассылки и обработку очередей, пока не сверите состояние данных.
- Не устанавливайте сомнительные утилиты «спасения» и не передавайте незнакомым людям ключи, доступы и архивы. Адреса официальных страниц вводите вручную.
- Определите приоритеты: код и версии окружения, дамп или согласованная копия БД, пользовательские файлы, конфигурация сети, почты, очередей и внешних интеграций.
Три сценария
Есть внешняя копия
Разворачивайте новый чистый сервер и восстанавливайте данные изолированно, не поверх рабочего окружения. Проверьте приложение до переключения DNS: тестовый домен или обращение по IP через curl --resolve позволит увидеть сайт без правки зон. Сверьте дату копии, количество записей и последние заказы, наличие файлов загрузок, вход пользователей, работу фоновых задач, SMTP и webhooks. Нулевую потерю данных заранее не обещайте: между копией и моментом аварии мог пройти интервал.
Есть только резервная копия провайдера
Запросите у поддержки конкретику: дату и состав копии, как обеспечена согласованность, входят ли конфигурация и дампы БД, в каком виде отдают файлы, каков размер и как проверить целостность. Уточните ограничения: например, файловая копия VPS — это не загрузочный образ, поэтому поднять сервер из неё автоматически не получится. Просите не «восстановите всё», а точный перечень компонентов, которые войдут в выдачу, и способ проверки до подключения к продакшену.
Нет доступной копии
Ищите собственные легальные материалы: локальные дампы, экспорты из базы, артефакты CI, исходники, пользовательские медиа, резервные диски. Git-репозиторий и CDN-кэш дают только часть — код или статику, но не гарантируют базу, заказы, пароли и целые сервисы. При восстановлении по частям сначала поднимайте базовый стенд, затем БД, потом интеграции, и только после проверки открывайте доступ пользователям.
Восстановление на чистой машине
Когда копия есть, сервис собирают не на боевом сервере, а на отдельном чистом хосте: новая машина, свежая ОС, никаких общих с прежней инфраструктурой SSH-ключей, панелей и монтирований. Задача этапа — собрать сервис целиком в стороне, убедиться, что он работает, и только потом переключать трафик.
Проверка до смены DNS удобна через временную привязку имени: hosts на вашей машине или curl --resolve. Пройдите основные сценарии: вход в админку, загрузка и скачивание файлов, регистрация, работа фоновых задач, а также оформление тестового заказа. Заказ проверяйте только в sandbox с отключёнными реальными платежами, письмами и исходящими webhook. Работу писем и webhook проверяйте на тестовых получателях и endpoint, без реальных побочных действий. Сверьте даты данных, число записей и последние операции, так вы поймёте, на какой момент времени копия пригодна.
Почему копия работающей БД — не дамп
Файлы базы данных, скопированные с работающего сервера, это набор страниц на диске в разных состояниях. Обычное файловое копирование работающего каталога PostgreSQL не обеспечивает согласованности: часть страниц уже на диске, часть ещё в памяти, журналы предзаписи неполные. Штатные физические бэкапы решают это с помощью остановки сервера по процедуре, согласованного снимка тома или поддерживаемого способа копирования вместе с необходимыми журналами. Копировать отдельные файлы таблиц из работающего кластера нельзя.
Отдельно стоит pg_dump: он делает внутренне согласованный дамп одной базы на момент старта, и это удобный переносимый формат. Но он не заменяет копию ролей, настроек, остальных баз и самого приложения. Для восстановления проекта нужен набор: дамп базы, файлы кода, пользовательские загрузки, конфигурация.
В WordPress действует тот же принцип. Одного репозитория исходников мало: база хранит записи, настройки, пользователей, ссылки на медиа; каталог uploads хранит сами файлы; wp-config.php описывает подключение. Значит, копия сайта это файлы плюс база, желательно с одинаковым моментом времени. Если дамп базы свежее файлов, часть записей будет ссылаться на отсутствующие изображения.
Kubernetes: манифесты, etcd и тома
В кластере три разных слоя, и они не подменяют друг друга. Манифесты (в Git или IaC) описывают желаемое состояние: deployments, services, конфигурации. etcd хранит состояние управления кластером: объекты API, но не содержимое прикладных данных. PersistentVolume это отдельный ресурс хранилища, где живут файлы и данные приложений.
Из этого следует практичный вывод: Git вернёт описания, но не вернёт содержимое томов. Восстановление etcd вернёт кластер к прежнему состоянию API, но если данные в PV утеряны, приложение поднимется пустым. Нужны отдельные прикладные копии: базы, файловые хранилища, очереди.
S3-зеркало тоже не равно независимой истории. Синхронизация отражает текущее состояние и, если в ней включена передача удалений, повторяет логические удаления: удалённый объект исчезнет и в зеркале. Нужны версии с историей и жизненным циклом, а в идеале отдельный аккаунт с ограниченными правами. Amazon S3 Object Lock защищает версии объектов от изменения или удаления на срок хранения и требует включённого versioning. Это свойство именно Amazon S3: переносить его автоматически на любые S3-совместимые сервисы, включая Beget, неверно. Физическая устойчивость хранилища от этого свойства тоже не следует.
Какие секреты отозвать
Провайдер рекомендовал сменить пароли и ключи, хранившиеся на серверах. Это указание относите к мерам предосторожности, а не к доказанному факту утечки — и не делайте обратного вывода, что утечки точно не было.
С доверенного устройства, не имеющего отношения к прежнему хосту, отзовите всё, что могло лежать на машине: ключи API внешних сервисов, доступы к S3 и CDN, SMTP-пароли, токены CI и Git, торговые и платёжные ключи, пароли баз данных. Отзывать лучше по приоритету: сначала платёжные и инфраструктурные доступы, потом остальное. Новые учётные данные вводите только в чистую систему, скомпрометированному хосту их передавать не нужно. Смена пароля сама по себе не возвращает удалённые данные и не очищает заражённый сервер.
DNS и почта
Сначала проверьте целевую площадку, затем при необходимости переключите DNS. Если ваш домен обслуживается NS Beget, записи правятся в панели управления доменом — она открыта для доменов, обслуживаемых через Beget, включая международные. Если домен использует чужие NS, записи настраиваются у действующего DNS-провайдера, и панель Beget тут не поможет.
Меняете NS, переносите всю зону, а не только A и AAAA: MX, SPF, DKIM, DMARC, TXT-проверки владения, записи поддоменов. Почту ради переезда сайта трогать не нужно: перенос веб-адресов можно сделать, не задевая MX. Учтите TTL и кэширование у провайдеров, обновление занимает разное время, и ровно 24 часа никто гарантировать не может. С DNSSEC переезд требует аккуратности: несоответствие подписей временно ломает разрешение имён.
Внешние копии и цели RPO/RTO
RPO это сколько данных допустимо потерять, RTO это сколько времени допустим простой. Для блога и магазина эти цели выбирает бизнес: блог может допустить потерю суток и восстановление за несколько часов, магазину с заказами нужны минуты-часы и почти без перерыва. Это условный пример, а не универсальный норматив и не гарантия быстрого запуска. Учтите: ежедневная копия в 03:00 при сбое в 23:00 потеряет почти сутки, но это не ровно сутки, всё зависит от момента сбоя. Репликация не заменяет историю копий: она, в зависимости от реализации, копирует и логические удаления.
Рабочая схема: несколько поколений копий, второе хранилище в другом независимом контуре у другого провайдера, отдельные учётные данные, offline- или immutable-слой и офлайн-ключ шифрования. Добавьте регулярный тест восстановления и оповещения об отсутствии свежей копии. Один архив на том же VPS это локальный откат, не disaster recovery. В момент инцидента не удаляйте старые копии автоматически.
# Шаблон для уже существующего репозитория restic.
# Замените /mnt/offline-repo на путь к своему офлайн-репозиторию.
# Замените 0123abcd на ID своей проверенной копии.
# Не запускайте команды вслепую.
# НИКОГДА не указывайте latest и не восстанавливайте поверх production.

# 1. Посмотреть список снимков
restic -r /mnt/offline-repo snapshots

# 2. Проверить репозиторий
restic -r /mnt/offline-repo check

# 3. Глубокая проверка: читает данные, занимает время и трафик
restic -r /mnt/offline-repo check --read-data

# 4. Восстановить выбранный снимок в новый пустой каталог на изолированной машине
restic -r /mnt/offline-repo restore 0123abcd --target /srv/restore/project-01

# 5. Проверить конфигурацию перед запуском сервиса
#    на отдельном хосте, без доступа к production
snapshots показывает снимки, check проверяет целостность репозитория, check --read-data дополнительно читает данные. Это не проверка на malware и не прикладная проверка базы: она не скажет, соответствуют ли таблицы приложению. Восстановление выбранного снимка в заданный каталог описано в документации restic restore. Для проверки данных после восстановления запускайте приложение в изолированном контуре и сравнивайте с ожидаемым состоянием.
FAQ
Восстановится ли VPS автоматически из файлов? Файловая копия — это набор файлов, а не готовый загрузочный образ сервера. Окружение придётся воссоздать отдельно, а дальнейшая автоматизация зависит от состава копии и доступных инструментов.
Достаточно ли сменить пароль? Нет. Смена пароля — одна из мер защиты, она не возвращает удалённые данные и не удаляет возможные следы на хосте. Нужно проверить систему и восстановить её из копий.
Вернуть сайт только из Git? Сам по себе репозиторий исходников обычно не содержит актуальную пользовательскую базу и uploads. Если их специально сохраняли, это уже отдельные копии. Статический сайт иногда можно собрать из Git, но для сайта с базой данных кода недостаточно.
Куда смотреть официальный статус? На страницу провайдера beget.ru/ru/security и официальные Telegram-сообщения Beget. Проверяйте там даты и этапы, а не пересказы в чатах.