Авторы SlackBench представили бенчмарк для проверки ИИ-агентов в совместной работе: системе нужно сопоставлять рабочую переписку с меняющимся состоянием репозитория, а не отвечать на изолированный вопрос из готового набора данных. Версия 1 препринта датирована 3 ноября 2026 года, запись появилась на arXiv 5 ноября. Для читателя это означает проверку цепочки действий: агент должен найти нужное обсуждение, восстановить контекст, изучить код и учесть изменения в решениях команды.
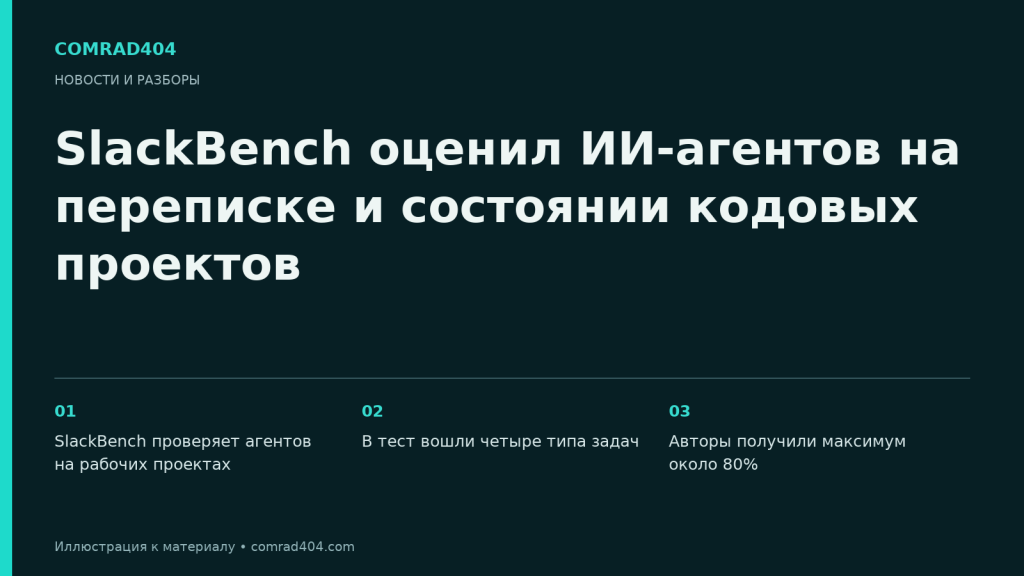
SlackBench проверяет агентов на рабочих проектах
По описанию авторов, многие существующие тесты используют синтетические данные или отдельные задачи. SlackBench моделирует ситуацию, в которой важная информация распределена между каналами и личными сообщениями, репозиторием и историей решений. Поэтому ответ требует не только языкового рассуждения, но и навигации по нескольким источникам с возможными противоречиями и устаревшими сведениями.
Такой подход меняет предмет оценки. Изолированный вопрос проверяет, может ли система выдать ответ на доступном ей фрагменте данных. SlackBench дополнительно проверяет, умеет ли агент определить релевантные обсуждения, пройти по цепочке сообщений, посмотреть состояние проекта и объединить сведения из переписки и кода.
В тест вошли четыре типа задач
Основа SlackBench — реконструкции реальных академических исследовательских проектов с сохранением приватности. В окружения включены многосоставные диалоги, меняющиеся решения, связанные с ними изменения кода в репозиториях GitHub и материалы Google Docs.
Авторы описывают 140 запросов четырёх типов: поиск по разным источникам, отказ от ответа при недостатке данных или ложной предпосылке, целевое суммирование и восстановление обстоятельств по длинным разговорам. В совокупности они проверяют не только поиск факта, но и выбор источников, распознавание недоказуемого утверждения и восстановление причинно-временного контекста проекта.
Авторы получили максимум около 80%
Авторы SlackBench сравнили 33 передовые модели и агентные системы. По их данным, лучший результат составил около 80% из 140 запросов, а большинство систем набрали меньше 66% из тех же 140 запросов. Это показывает заметный разрыв между возможностью работать с отдельными фрагментами информации и устойчивой работой в среде, где переписка, решения и код меняются одновременно.
Результаты опубликованы авторами бенчмарка и относятся к реконструированным академическим проектам. В представленном источнике нет независимого редакционного тестирования, поэтому показатели нельзя автоматически переносить на другие организации, инструменты и типы рабочих задач. Они также описывают оценку на конкретном наборе из 140 запросов, а не универсальную вероятность успешной работы агента в любой команде.