Nace AI 1 ноября 2026 года выложила Drex Max v1 в открытый доступ: это самая крупная модель решений компании, и теперь она работает на собственном железе пользователя. Релиз включает веса bf16, квантованный Q8_0 GGUF, affine Q4-чекпоинт, а также форки llama.cpp и Ollama. Для разработчиков это означает, что маршрутизация запросов, классификация и проверки политик могут оставаться на локальной машине, без обращения к внешнему API. Об этом сообщает MarkTechPost со ссылкой на Nace AI.
Что это за модель
Drex Max v1 — плотная модель на 27 млрд параметров с окном контекста 262 144 токена, по умолчанию выставляется 16 384. На один вопрос модель принимает до 255 вариантов ответа. Архитектура: 64 слоя, из которых 48 — линейное внимание Gated DeltaNet, работающее слева направо, а 16 — полное некаузальное внимание, размещённое каждый четвёртый слой, так что каждый токен может смотреть на всю последовательность. Изображения проходят через нативный визуальный блок.
Модель не пишет текст, а выдаёт вероятности
Drex Max отвечает на типизированные вопросы по заданному контексту. На вход подаётся состояние — текст, JSON или изображения — плюс именованные вопросы. На выходе за один прямой проход модель возвращает вероятность для каждого варианта. Текст не генерируется вообще. Именно поэтому модель позиционируют под маршрутизацию агентов, сортировку тикетов и проверки на границах политик: там нужен выбор из фиксированного набора, а не свободный ответ.
Заявленные бенчмарки
Nace AI сообщает о 67,52 балла на публичном Decision Index 0.4 — на 6,27 балла выше Drex v2.0. Лучший отдельный результат — 97,3 в задаче InfographicVQA, блок инструментов (Tools) доходит до 81,9. Все эти цифры — self-reported данные производителя, независимых прогонов в доступных материалах нет.
Как запустить на Apple Silicon
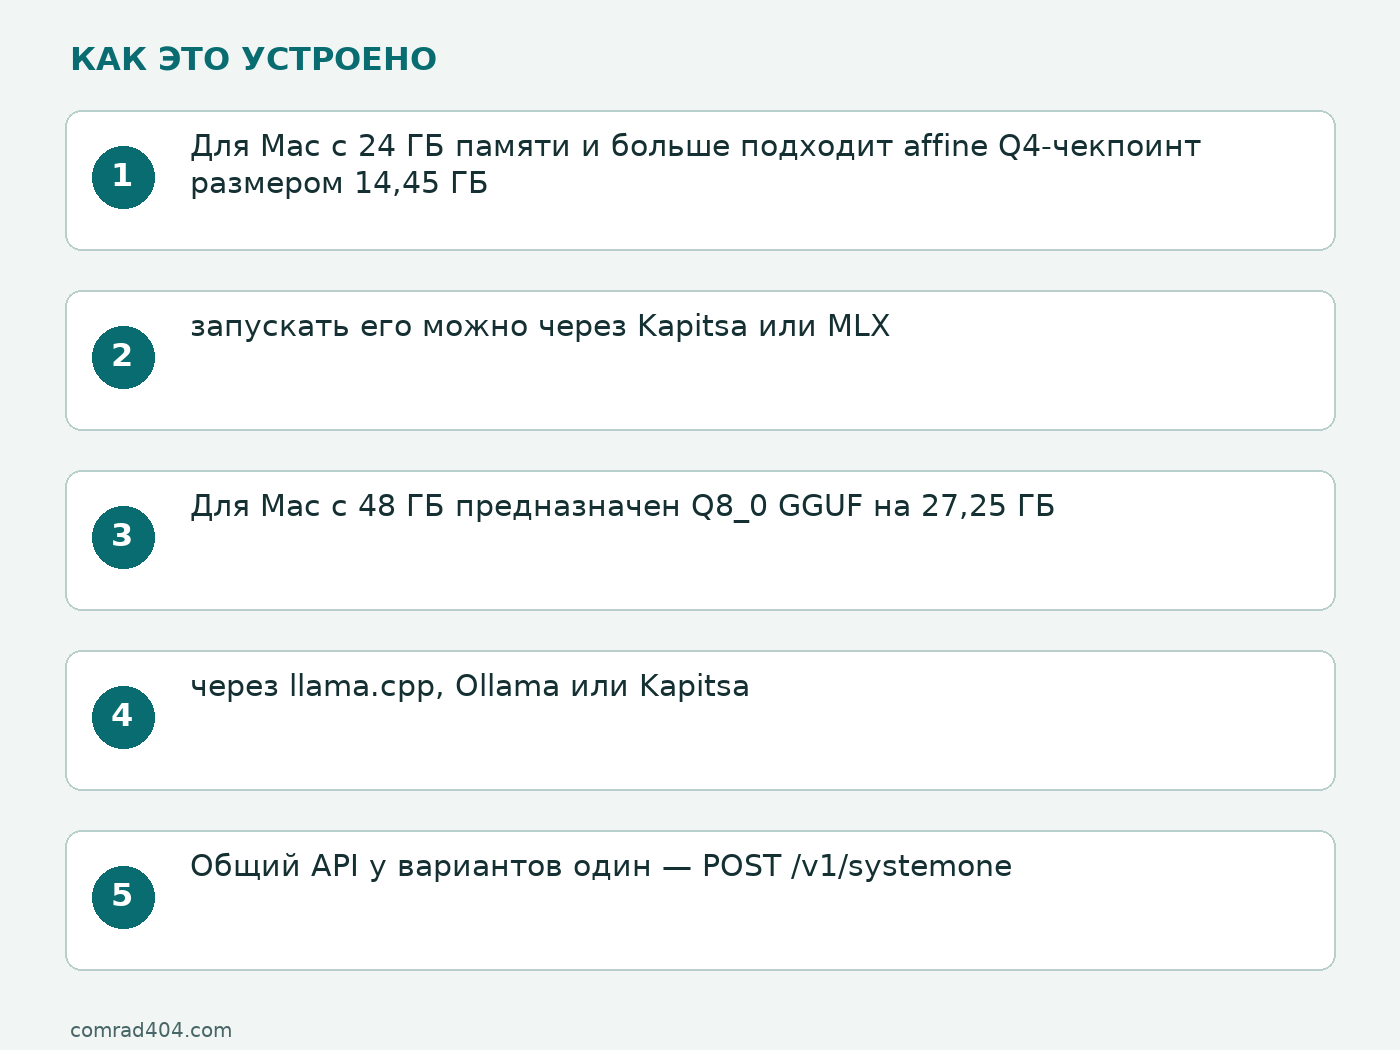
Для Mac с 24 ГБ памяти и больше подходит affine Q4-чекпоинт размером 14,45 ГБ, запускать его можно через Kapitsa или MLX. Для Mac с 48 ГБ предназначен Q8_0 GGUF на 27,25 ГБ — через llama.cpp, Ollama или Kapitsa. На NVIDIA-железе с Python доступны H100 в bf16 или L40S на 48 ГБ в 8-битном режиме; на CPU работают llama.cpp и Ollama. Общий API у вариантов один — POST /v1/systemone.
Требования к памяти в описании релиза привязаны к конкретным чекпоинтам, а не к модели целиком: bf16-веса и 8-битный режим на NVIDIA рассчитаны на отдельные конфигурации, которые в тексте не детализированы.
Что остаётся непроверенным
Все цифры бенчмарков и сравнения с другими конфигурациями — заявление Nace AI, а не независимая проверка: в доступных материалах нет ни сторонних прогонов, ни данных о лицензии весов и условиях коммерческого использования, ни сведений о поведении модели на реальных задачах пользователя за пределами заявленных тестов.