В RAG-системе генератор отвечает только по тому контексту, который получил от поискового слоя. Если нужный фрагмент оказался на 17-м месте, а в промпт попали первые 5 результатов, модель не исправит ошибку самостоятельно. Поэтому в архитектуру часто добавляют второй этап — reranking, или переранжирование найденных документов.
Reranker для RAG не заменяет векторный поиск. Он получает небольшой список уже найденных кандидатов и заново оценивает их связь с запросом. Это может улучшить порядок документов, но одновременно увеличивает задержку и стоимость обработки. Проверять такую связку нужно не по впечатлению от нескольких ответов, а на собственном наборе запросов.
Что именно делает reranker для RAG
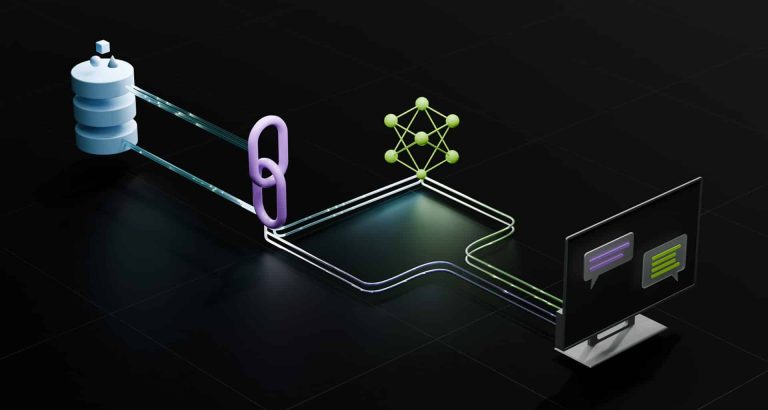
Типичный конвейер выглядит так:
Пользовательский запрос преобразуется в эмбеддинг.
Векторная база или полнотекстовый индекс возвращает первые `k` кандидатов.
3. Reranker получает запрос и каждый кандидат как пару текстов.
4. Документы сортируются по новым оценкам.
5. В генератор передаются первые `n` фрагментов.
Разница между первым и вторым этапом поиска принципиальна. Би-энкодер заранее кодирует документы и запросы отдельно, поэтому может быстро искать по большому индексу. Cross-encoder читает запрос и документ вместе. Такой подход обычно лучше учитывает конкретные формулировки, отрицания, названия и отношения между сущностями, но требует отдельного вычисления для каждой пары.
Документация Sentence Transformers описывает CrossEncoder именно как модель, которая принимает пару текстов и возвращает оценку релевантности. В примерах библиотека использует её для переранжирования результатов, а не для первичного поиска по всей коллекции: документация CrossEncoder.
Практический вывод: сначала нужно получить достаточно широкий список кандидатов, например 20–100 документов, а затем сократить его до контекста для LLM. Если первичный поиск не вернул правильный документ вообще, reranker его не найдёт.
Почему сравнивать нужно не ответы модели, а порядок документов
У RAG есть как минимум два разных места отказа:
- релевантный фрагмент не попал в список кандидатов;
- фрагмент попал в список, но оказался слишком низко и не дошёл до генератора.
Reranker влияет в основном на вторую проблему. Поэтому оценка должна начинаться с разметки поиска. Для каждого запроса понадобится:
- сам запрос;
- идентификатор одного или нескольких релевантных документов;
- список кандидатов от базового поиска;
- желаемый размер контекста `n`;
- при необходимости — шкала релевантности, например от 0 до 3.
Для небольшого внутреннего теста достаточно 30–100 реальных запросов. Их лучше брать из логов приложения, тикетов поддержки или вопросов пользователей, а не придумывать только из названий документов. В наборе должны быть сложные случаи: синонимы, сокращения, отрицания, несколько похожих сущностей и запросы, на которые ответа в базе нет.
Главные метрики:
- Recall@k — попал ли хотя бы один правильный документ в первые `k` результатов;
- MRR@k — насколько высоко оказался первый релевантный результат;
- nDCG@k — учитывает порядок нескольких релевантных документов и разные степени их полезности.
Если задача — передать LLM пять фрагментов, критично смотреть не только на MRR@10, но и на Recall@5. Высокий Recall@50 не поможет, если после переранжирования в контекст всё равно попадают нерелевантные документы.
Для расчёта nDCG можно использовать реализацию из документации scikit-learn. Важно подавать в неё одинаковый набор документов в одинаковом порядке, меняя только оценки конкретного метода.
Воспроизводимый тест на BGE Reranker
Один из доступных локально вариантов — `BAAI/bge-reranker-v2-m3`. В карточке модели на Hugging Face приведён пример использования для оценки пар «запрос — документ», а также указана поддержка многоязычных сценариев. Для русскоязычного проекта это делает модель удобным кандидатом для первичной проверки, но не доказательством качества на конкретном домене.
Ниже — минимальный пример. Он не выполняет первичный поиск: список `candidates` должен прийти от вашей векторной базы или полнотекстового движка.
python
from sentence_transformers import CrossEncoder
query = «Как настроить ротацию API-ключей в агенте?»
candidates = [
«Сервис хранит ключи в переменных окружения и меняет их вручную.»,
«Ротация ключей выполняется через секрет-хранилище. Агент получает короткоживущий токен, а приложение обновляет его без перезапуска.»,
«API ограничивает число запросов в минуту для каждого пользователя.»,
«Логи агента содержат входные и выходные сообщения инструментов.»
]
model = CrossEncoder(«BAAI/bge-reranker-v2-m3»)
scores = model.predict([(query, text) for text in candidates])
ranked = sorted(
zip(scores, candidates),
key=lambda item: float(item[0]),
reverse=True
)
for score, text in ranked:
print(f»{float(score):.4f}\t{text}»)
Для эксперимента нужно сохранить не только отсортированный список, но и:
- название модели;
- версию библиотеки;
- устройство выполнения — CPU или GPU;
- размер входных текстов;
- время обработки всего списка;
- число кандидатов `k`;
- число документов, передаваемых генератору.
Карточка `bge-reranker-v2-m3` доступна по адресу BAAI/bge-reranker-v2-m3 на Hugging Face. При запуске в продакшене стоит зафиксировать конкретную версию модели и не сравнивать результаты после её замены с прежними метриками без отдельной пометки.
Сравнение с Cohere Rerank и базовым поиском
Локальная модель удобна, когда данные нельзя отправлять внешнему API или требуется контролировать инфраструктуру. Облачный сервис может быть проще для запуска, особенно если важны масштабирование и отсутствие собственного инференса.
В документации Cohere этап `rerank` описан как переоценка списка документов по отношению к запросу. API принимает запрос, массив документов и возвращает результаты с индексами и оценками. Важное ограничение то же самое: сервис ранжирует переданные кандидаты, а не ищет по всей базе. Официальное описание параметров и поведения находится в документации Cohere Rerank.
Сравнивать варианты следует в трёх конфигурациях:
Базовый поиск — результаты векторного или гибридного индекса без второго этапа.
Локальный reranker — например, `BAAI/bge-reranker-v2-m3`.
3. Облачный reranker — например, Cohere Rerank с зафиксированной версией модели и одинаковым списком кандидатов.
Для честного теста все три варианта должны получать один и тот же запрос и один и тот же список кандидатов. Нельзя сравнивать локальную модель на 50 документах с API, которому передали только 10. Также нужно отделять время первичного поиска от времени переранжирования.
Полезный формат результата — не «модель А лучше модели Б», а профиль:
| Метод | Recall@5 | MRR@5 | Средняя задержка | Доля запросов с улучшением |
|---|---|---|---|---|
| Базовый поиск | измерить | измерить | измерить | — |
| Локальный CrossEncoder | измерить | измерить | измерить | измерить |
| Облачный reranker | измерить | измерить | измерить | измерить |
Числа в такой таблице должны появиться только после запуска на вашем наборе. Бенчмарки из карточки модели или статьи не заменяют проверку на собственных документах.
Как подобрать размер списка кандидатов
Параметр `k` определяет, сколько документов первичный поиск передаст на второй этап. Маленькое значение снижает задержку, но увеличивает риск, что нужный фрагмент не попадёт к reranker. Большое значение повышает шанс обнаружения, однако CrossEncoder должен обработать больше пар.
Начните с трёх конфигураций:
- `k=10`, в контекст передаются 3–5 документов;
- `k=30`, в контекст передаются 3–5 документов;
- `k=50`, в контекст передаются 3–5 документов.
Для каждого варианта измерьте Recall@k у первичного поиска, MRR после переранжирования и полное время до формирования контекста. Если переход с 30 на 50 кандидатов почти не улучшает Recall@5, дополнительные вычисления, вероятно, не оправданы.
Есть и другой риск: слишком длинный кандидат может исказить оценку. Документ на 20 страниц, поданный одним текстом, содержит много нерелевантного материала даже при правильном заголовке. Поэтому размер чанка, перекрытие и правила очистки текста нужно держать неизменными во время сравнения. Иначе эксперимент будет измерять одновременно качество нарезки и качество reranker.
Где переранжирование ухудшает результат
Reranker не является универсальным исправлением RAG. Он может дать слабый результат в нескольких ситуациях.
- Нужного документа нет среди кандидатов. Смена модели второго этапа не исправит плохой recall первичного индекса. Сначала проверьте, видит ли базовый поиск правильный фрагмент хотя бы в топ-50.
- Запрос слишком короткий. Поиск по словам вроде «ошибка авторизации» может возвращать много похожих документов. Здесь полезнее добавить в запрос тип продукта, код ошибки или действие пользователя, чем просто увеличить число кандидатов.
- В корпусе есть дубликаты. Reranker может поднять несколько почти одинаковых чанков, вытеснив разные части ответа. После сортировки иногда нужен этап дедупликации по документу, заголовку или семантическому сходству.
- Документы требуют свежести. Модель оценивает соответствие текста запросу, но сама по себе не знает, какой документ актуальнее. Для инструкций, API и политик доступа к релевантности нужно добавить фильтр по версии или дату обновления.
- Стоимость важнее нескольких процентов качества. На небольшом трафике задержка незаметна, но при сотнях запросов в минуту число пар быстро растёт. Измеряйте p50 и p95, а не только среднее время.
Исследование Nogueira и Cho о passage re-ranking показывает, почему совместное чтение запроса и фрагмента может улучшать порядок результатов по сравнению с быстрым первым этапом, но оно также иллюстрирует общую архитектурную идею, а не гарантию для любой современной модели: Passage Re-ranking with BERT.
Контрольный эксперимент перед внедрением
Перед подключением reranker к генератору проведите четыре проверки.
Зафиксируйте набор запросов. Не меняйте его между запусками и храните разметку отдельно от кода.
2. Сравните порядок документов. Посмотрите 20–30 случаев, где новый метод изменил первые пять позиций.
3. Проверьте отрицательные примеры. Добавьте похожие, но неправильные документы: другую версию API, соседний продукт, устаревшую инструкцию.
4. Измерьте полный путь. Учитывайте получение кандидатов, переранжирование, сериализацию и передачу контекста модели.
Результат стоит принимать по заранее заданному порогу. Например, команда может считать внедрение оправданным, если Recall@5 вырос минимум на 10% относительно базового поиска, а p95 задержки увеличился не более чем на установленный лимит. Сам порог зависит от продукта: для интерактивного помощника и ночной пакетной обработки допустимы разные компромиссы.
После запуска полезно логировать запрос, идентификаторы кандидатов, позиции до и после reranking, выбранные фрагменты, задержку и версию модели. Содержимое пользовательских данных при этом нужно сокращать или обезличивать. Через несколько недель такой журнал позволит собрать новые сложные примеры и проверить, не ухудшилось ли качество после изменения индекса или чанкинга.
Reranker имеет смысл подключать не потому, что он является обязательной частью RAG, а когда измерения показывают конкретную проблему с порядком найденных документов. Начните с базовой линии, проверьте Recall первичного поиска, затем сравните локальный CrossEncoder и API на одинаковом списке кандидатов. Перед продакшеном отдельно проверьте актуальность документов, дубликаты, p95 задержки и стоимость каждой пары «запрос — фрагмент».