
Если вы хоть раз задавали вопрос ChatGPT и получали уверенный, но абсолютно ложный ответ — вы сталкивались с главной проблемой современных языковых моделей. Они не знают, чего не знают. До недавнего времени единственным способом «научить» модель новым фактам был дорогостоящий переобучение. Но в 2020 году группа исследователей, включая Патрика Льюиса (сейчас — Cohere), предложила принципиально иной подход: retrieval-augmented generation, или RAG.
Суть проста: вместо того чтобы требовать от модели помнить всё, мы даём ей доступ к библиотеке. Как судья, который отправляет клерка в юридическую библиотеку за прецедентами, RAG-система сначала находит релевантные документы, а затем генерирует ответ на их основе. Льюис, который придумал термин, в интервью NVIDIA признался, что название вышло неблагозвучным: «Мы бы точно подумали над именем, если бы знали, что работа станет такой популярной». Но именно эта «неказистая» техника сегодня стоит за десятками коммерческих сервисов — от AWS и Google до Microsoft и Oracle.
RAG не просто улучшает точность — он меняет архитектуру взаимодействия с ИИ. Вместо чёрного ящика с параметрами мы получаем систему, способную цитировать источники, обновлять знания без переобучения и, что критически важно, работать с конфиденциальными данными, не отправляя их вовне.
Как RAG решает проблему «чёрного ящика»
Любая LLM — это нейросеть, измеряемая количеством параметров. Эти параметры хранят обобщённые закономерности языка, но не факты в человеческом понимании. Отсюда два следствия: модель не знает событий после даты среза обучения, и она склонна к галлюцинациям — выдаче правдоподобных, но ложных сведений. Достаточно вспомнить инцидент с Google Bard, который в 2023 году ошибся в данных о телескопе «Джеймс Уэбб», что привело к падению акций Alphabet на 100 миллиардов долларов.
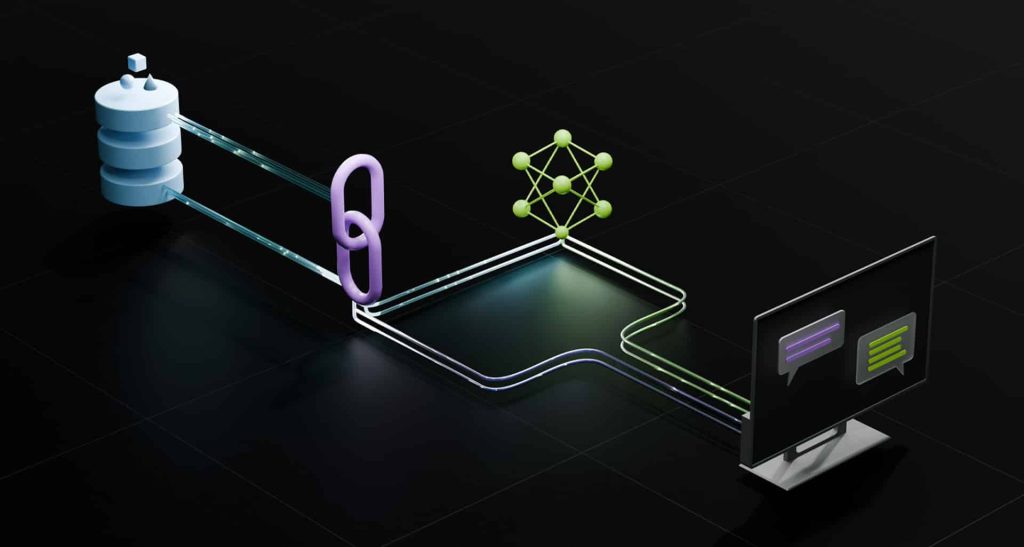
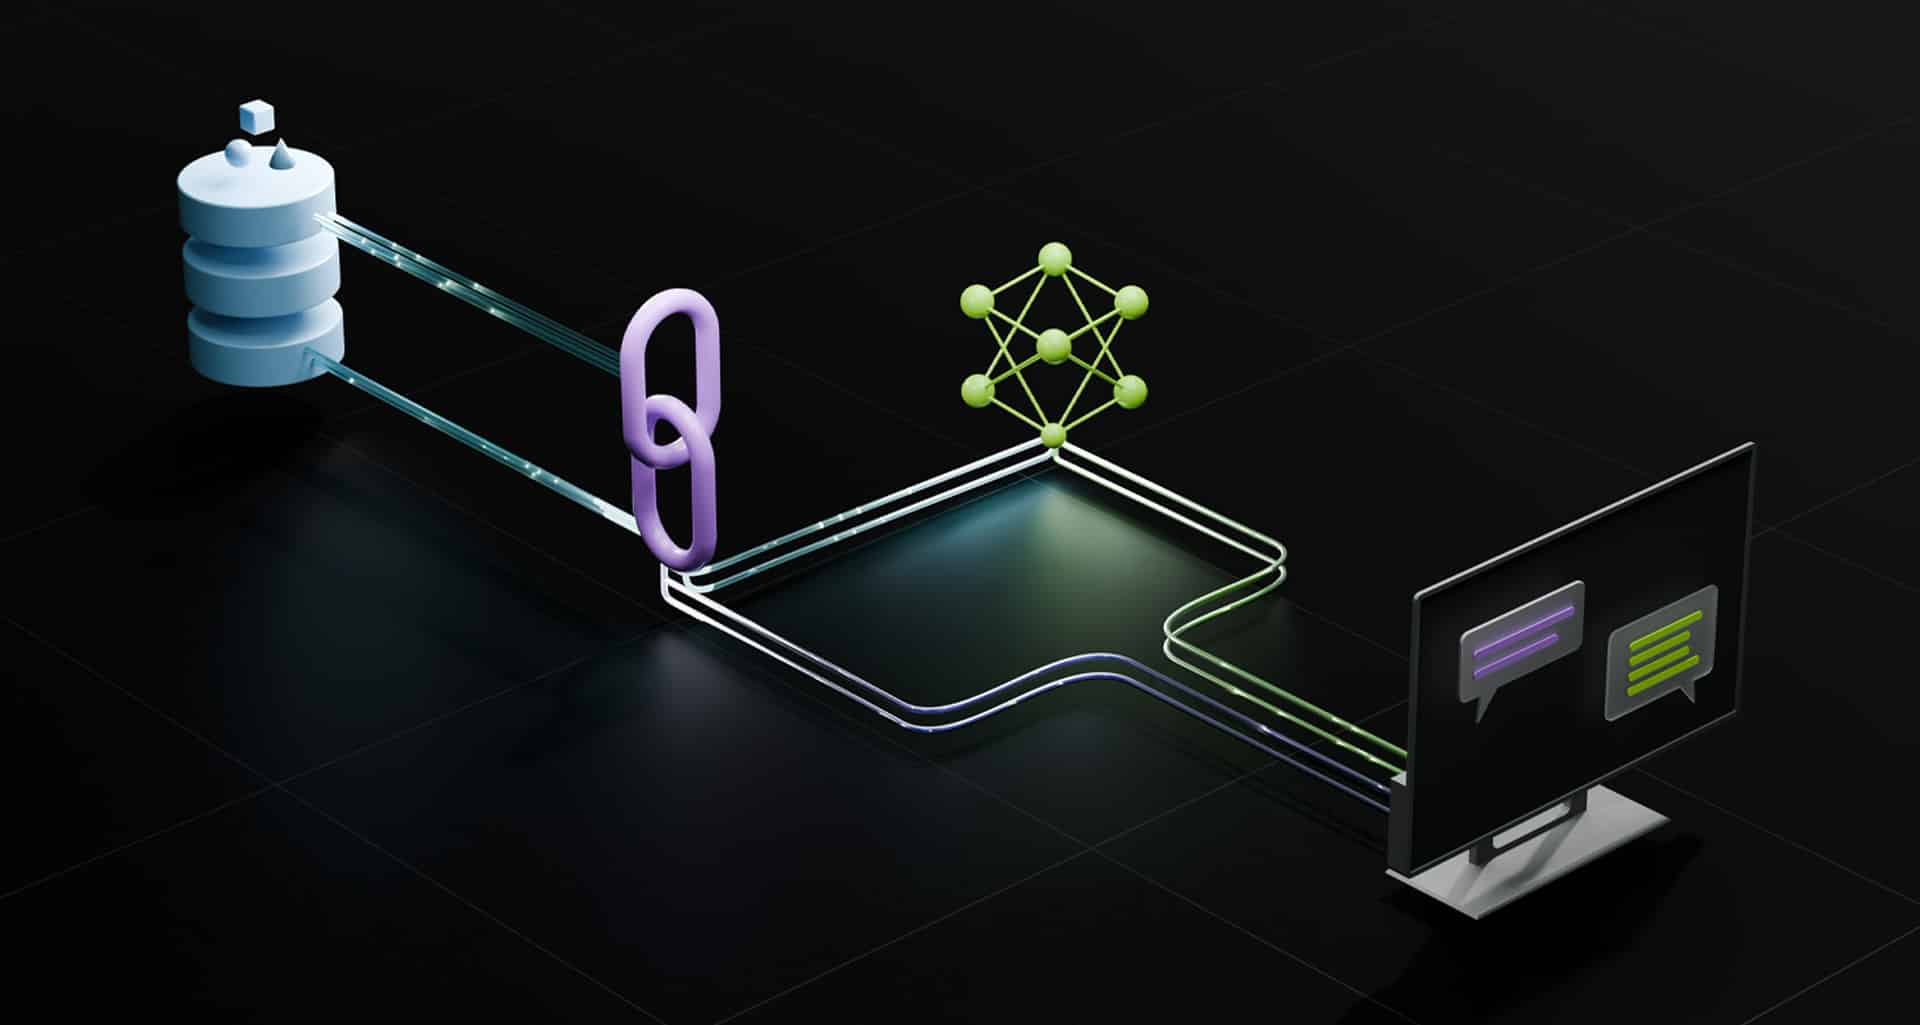
RAG разрывает эту зависимость. Технически процесс выглядит так:
Пользователь отправляет запрос.
Система преобразует запрос в векторное представление (embedding).
3. Выполняется семантический поиск по векторной базе данных, содержащей размеченные документы.
4. Найденные фрагменты (chunks) подаются в LLM вместе с исходным запросом.
5. Модель генерирует ответ, опираясь на предоставленный контекст.
Ключевое отличие от обычного keyword search — семантика. Если поиск по ключевым словам «лучшие кроссовки для плоскостопия» найдёт только точное совпадение, то семантический поиск вернёт «кроссовки с поддержкой свода стопы» и даже обзоры конкретных моделей. Как поясняет глоссарий NVIDIA, «keyword search ищет слова, semantic search — смысл».
Важно: RAG не делает LLM «умнее». Он даёт ей актуальный контекст. И это принципиально меняет требования к инфраструктуре.
Что говорят бенчмарки и независимые тесты
К сожалению, единого стандарта для оценки RAG-систем не существует. Исследователи из arXiv (2025) в систематическом обзоре выделяют четыре ключевых метрики: точность извлечения (retrieval accuracy), беглость генерации (generation fluency), задержку (latency) и вычислительную эффективность. Но на практике результаты сильно зависят от домена и качества индексации.
Независимый тест Aider Polyglot (лидерборд для оценки навыков кодирования LLM) показал, что Claude 3.7 Sonnet набрал 60,4% без использования механизма «размышлений» — лучший результат среди моделей, работающих без дополнительного контекста. Однако, как отмечает создатель теста Пол Голтье, бенчмарк использует 225 упражнений Exercism, которые могли попасть в обучающие данные моделей. Это классическая проблема утечки данных: мы не можем быть уверены, что модель «вспоминает», а не «вычисляет» ответ.
Для корпоративных сценариев важнее другое: RAG позволяет использовать модели с гораздо меньшим количеством параметров, если они подключены к качественной базе знаний. В тестах Microsoft GraphRAG — экспериментального проекта, использующего графовые структуры для контекста, — авторы предупреждают, что индексация может быть дорогой, и рекомендуют начинать с малого. Это честное признание: RAG не панацея, он требует настройки.
RAG против Fine-Tuning: что выбрать
Главное преимущество RAG перед дообучением (fine-tuning) — скорость и стоимость. Переобучение модели требует тысяч GPU-часов и доступа к экспертам по машинному обучению. RAG, по словам Льюиса, можно реализовать «буквально пятью строками кода». Это не преувеличение: популярные фреймворки вроде LangChain и LlamaIndex позволяют подключить векторную базу данных к LLM за несколько минут.
Но есть нюансы. Fine-tuning меняет веса модели, делая её экспертом в узкой области — например, в медицинской диагностике. RAG же лишь добавляет контекст. Если модель не понимает базовых принципов предметной области, никакой контекст не поможет. Идеальная стратегия — комбинировать оба подхода: сначала дообучить модель на корпусе терминов, затем подключить RAG для доступа к актуальным документам.
С точки зрения безопасности RAG также выигрывает. Поскольку данные не используются для переобучения, они не «запоминаются» моделью. Это критично для юридических и медицинских приложений, где конфиденциальность превыше всего. Как отмечает IBM, RAG позволяет организациям «использовать внутренние авторитетные источники данных и получать аналогичное повышение производительности модели без переобучения».
Практические кейсы: от медицины до ПК
NVIDIA активно продвигает RAG через свой AI Blueprint — набор микросервисов NeMo Retriever и NIM, оптимизированных для работы на ускорителях GH200 Grace Hopper. Компания утверждает, что такой конвейер обеспечивает 150-кратное ускорение по сравнению с выполнением на CPU. Скептики резонно замечают, что это маркетинговый показатель: на практике узким местом остаётся скорость поиска в векторной базе данных, а не генерация.
Тем не менее, конкретные применения впечатляют:
- Медицина: LLM, дополненная медицинским индексом, может ассистировать врачу, ссылаясь на последние исследования и протоколы.
- Финансы: аналитик получает доступ к рыночным данным в реальном времени через RAG-интерфейс.
- Техподдержка: компании превращают руководства и видеоинструкции в базы знаний, к которым сотрудники обращаются через чат-бота.
- Персональные ПК: NVIDIA адаптировала RAG для Windows через TensorRT-LLM. Пользователь может подключить локальные файлы (почту, заметки) к модели, работающей на RTX GPU, и все данные остаются на устройстве.
Последний пункт особенно важен в контексте приватности. Как отмечается в блоге NVIDIA, пользователь может «быть уверен, что его источник данных, запросы и ответы остаются конфиденциальными». Это прямая альтернатива облачным решениям, где данные уходят на серверы провайдера.
Подводные камни: галлюцинации, безопасность и стоимость
RAG не решает проблему галлюцинаций полностью. Модель может исказить смысл даже правильного документа или объединить факты из разных контекстов в ложное утверждение. Исследователи из Википедии предупреждают: «LLM могут генерировать дезинформацию, даже если они опираются на фактологически правильные источники». Это происходит из-за inherent bias модели и её склонности к «завершению паттерна», а не к логическому выводу.
Безопасность — ещё один вызов. Если злоумышленник получит доступ к векторной базе данных, он сможет извлечь чувствительную информацию через продуманные запросы (inference attacks). Microsoft в своём проекте GraphRAG прямо указывает, что код предоставляется «как есть» и не является официально поддерживаемым продуктом.
Наконец, стоимость. Индексация больших объёмов данных (40 000+ документов, как обсуждают на Reddit) требует значительных вычислительных ресурсов. Векторные базы данных, такие как Pinecone, Weaviate или Qdrant, могут стоить тысячи долларов в месяц для production-нагрузок. NVIDIA рекомендует свои GH200 с 288 ГБ HBM3e — но такое оборудование доступно далеко не каждому стартапу.
Хронология развития RAG
- 1970-е: первые прототипы question-answering систем в информационном поиске.
- 2020: публикация статьи Льюиса и соавторов (Meta AI, UCL, NYU), вводится термин RAG.
- 2023: массовое внедрение — AWS, Google, Microsoft, NVIDIA анонсируют RAG-сервисы.
- 2024: появление GraphRAG от Microsoft — использование графов знаний для контекста.
- 2025: агентные архитектуры RAG, где модель сама решает, когда и какие источники запрашивать.
Прогресс идёт от простого «прикрепи базу данных» к интеллектуальным системам, способным выбирать стратегию поиска в зависимости от запроса. Исследователи из arXiv называют это направление «agentic RAG» и видят в нём будущее knowledge-intensive NLP.
Вывод: кому и зачем нужен RAG сегодня
RAG — не модный термин, а рабочий инструмент, который решает конкретную проблему: как заставить LLM отвечать на основе фактов, а не обобщений. Он не заменяет качественную модель и не устраняет необходимость в валидации данных. Но он даёт то, чего не может дать ни один LLM сам по себе — доказуемость и актуальность.
Если ваша задача — чат-бот для внутренней документации, аналитический ассистент или система поддержки клиентов, RAG — самый быстрый и дешёвый путь к production-ready решению. Если вы хотите создать ИИ-диагноста или юридического консультанта — готовьтесь к комбинации RAG с дообучением и тщательному тестированию.
Главное — не ждать чуда. RAG не сделает модель всезнающей, но он сделает её честной. А в мире, где ИИ уже советует врачам и пишет код, честность — самый дефицитный ресурс.