
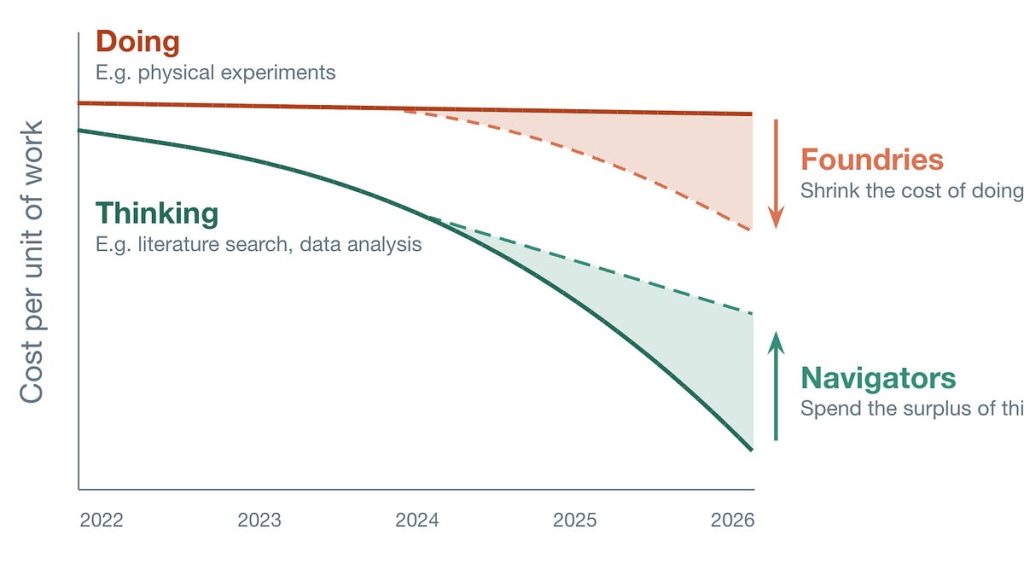
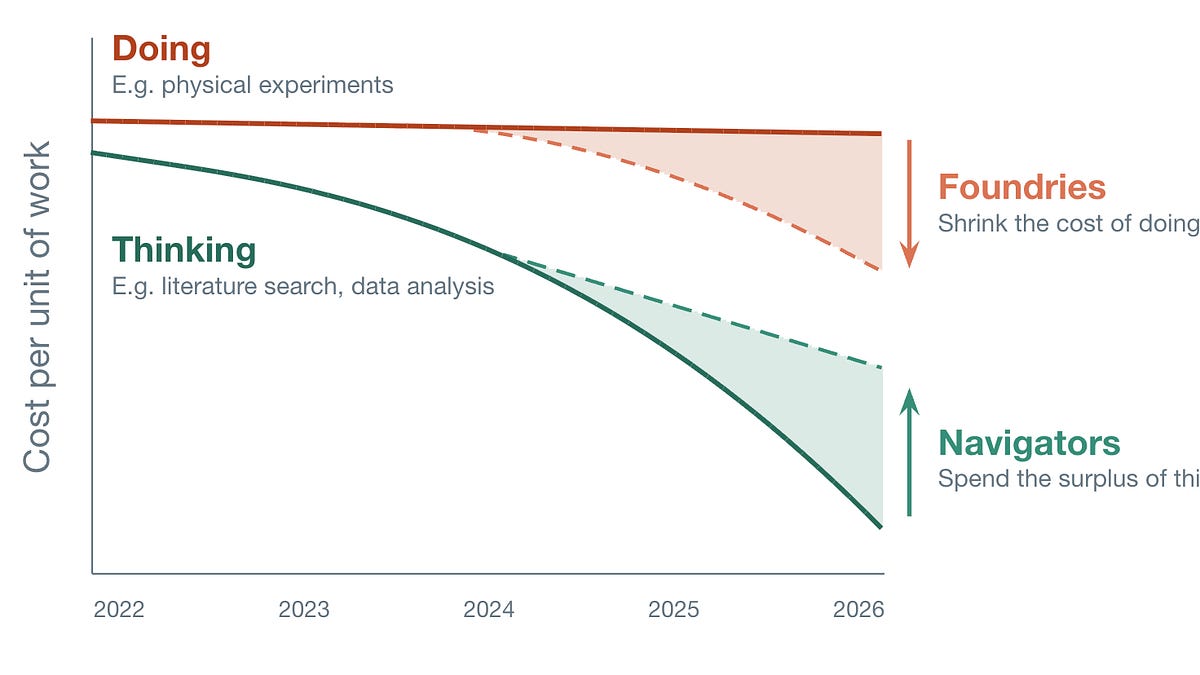
Адриан Сэнборн из Endura Therapeutics предложил разделять научные AI-компании на два типа: Foundries, или «фабрики», снижающие стоимость физических измерений, и Navigators — команды, которые ускоряют анализ, разработку инструментов и принятие решений с помощью языковых моделей.
Фреймворк опубликован 24 сентября 2026 года в гостевой колонке Latent Space. Его отправная точка проста: генерация кода и обработка информации стали дешевле, однако лабораторный эксперимент по-прежнему требует оборудования, реагентов и нескольких дней или недель работы.
Для разработчиков научного ПО это существенное ограничение. LLM может быстро изменить аналитический пайплайн или собрать интерфейс для просмотра результатов, но она не сокращает время инкубации и не увеличивает автоматически пропускную способность микроскопа или секвенатора.
Где ИИ упирается в физический эксперимент
В программной разработке результат часто можно проверить сразу: запустить тесты, сравнить вывод или измерить производительность. Поэтому ускорение написания кода сравнительно быстро отражается на выпуске продукта.
В экспериментальной науке цикл устроен иначе. Даже если модель за несколько минут предложила гипотезу, написала код анализа и подготовила визуализацию, подтвердить результат можно лишь после физического опыта. По оценке Сэнборна, работа вокруг эксперимента ускорилась гораздо заметнее, чем сам эксперимент.
Автор называет это асимметрией между дешёвым «мышлением» и дорогим «действием». Она определяет, куда научная компания может направить инвестиции: в новую измерительную платформу либо в перестройку процессов вокруг уже доступного оборудования.
Такое разделение не означает, что одна стратегия лучше другой. Foundry требует капитала и технологической специализации. Navigator можно развивать постепенно, внедряя модели в анализ данных, внутреннюю разработку и планирование исследований.
Foundries ускоряют получение данных
К Foundries Сэнборн относит компании, которые промышленным способом увеличивают объём экспериментальных измерений. Их преимущество возникает за счёт секвенирования нового поколения, мультиплексирования, высокопроизводительной микроскопии или физической автоматизации лаборатории.
В качестве примеров автор приводит Xaira, NewLimit, Octant, Tahoe и Endura Therapeutics в области секвенирования и мультиплексных измерений. В отдельную группу он включает insitro, Eikon и Noetik, работающие с высокопроизводительной микроскопией, а также Lila и Periodic Labs, ориентированные на автоматизацию физических экспериментов.
Публичное описание подходов отдельных компаний можно проверить на сайтах Xaira и insitro. Однако этот перечень отражает классификацию автора колонки, а не результаты независимого сравнения платформ.
В модели Foundry ИИ помогает интерпретировать данные и строить прогнозы, но основным активом остаётся экспериментальная система. Она должна воспроизводимо генерировать измерения быстрее или дешевле прежнего процесса. Создание такой инфраструктуры занимает годы и привязывает компанию к определённой технологии.
Из-за капиталоёмкости Foundries хорошо заметны на рынке: они могут демонстрировать оборудование, наборы данных и новые модели. Вместе с тем для оценки их эффективности недостаточно количества собранных данных. Имеют значение стоимость одного измерения, воспроизводимость, время полного цикла и связь полученного сигнала с конкретной научной задачей.
Navigators меняют анализ и выбор экспериментов
Navigators используют LLM внутри обычных рабочих процессов. Они могут автоматизировать подготовку кода, адаптацию аналитических пайплайнов, построение интерфейсов и предварительный разбор кандидатов для следующего эксперимента.
Сэнборн утверждает, что для такой стратегии не обязательны собственная фундаментальная модель или огромный закрытый датасет. Ключевым условием становится готовность команды менять процессы по мере появления более быстрых инструментов.
Особенно заметен эффект в исследованиях, где протокол регулярно пересматривается. В программной инженерии частая смена требований может указывать на проблемы с планированием. В лаборатории изменение следующего шага часто является прямым результатом только что проведённого опыта.
Каждое изменение протокола затрагивает код, который обрабатывает и нормализует измерения. Раньше это нередко создавало разрыв между лабораторным специалистом и сотрудником, отвечающим за вычислительный анализ. Обновление пайплайна превращалось в отдельную задачу и могло сдерживать число проверяемых вариантов.
По наблюдениям автора, инструменты генерации кода сокращают такую переделку до нескольких часов или одного рабочего дня. Это не делает выводы автоматически корректными: сгенерированный код всё равно необходимо тестировать, а изменение нормализации может повлиять на интерпретацию результатов.
Внутренние инструменты становятся доступнее
Ещё одно следствие — снижение стоимости специализированного научного ПО. Сэнборн приводит пример интерактивного дашборда Endura Therapeutics, который, по его словам, был собран за несколько часов. Ранее подобная разработка могла занимать несколько дней и зависеть от очереди задач вычислительной команды.
Если исследователь самостоятельно открывает и визуализирует результаты, между экспериментом и интерпретацией становится меньше промежуточных этапов. При этом лаборатории необходимо сохранить контроль версий, происхождение данных и возможность воспроизвести расчёты. Быстрый интерфейс без аудита преобразований способен лишь скрыть ошибки.
Собственные порталы также позволяют учесть особенности конкретного эксперимента, которые не поддерживает универсальная лабораторная система. Коммерческие продукты обычно проектируются для множества клиентов, поэтому предлагают усреднённую структуру данных и заранее определённые сценарии анализа.
LLM и генераторы кода снижают порог разработки внутренних решений, но не устраняют расходы на сопровождение. Команде всё равно придётся поддерживать доступы, тесты, документацию, интеграции и перенос данных при изменении протоколов.
Что проверить научной AI-команде
Фреймворк полезен как способ определить реальное узкое место проекта. Если команда неделями ждёт результатов измерений, новый чат-интерфейс вряд ли заметно ускорит исследовательский цикл. Здесь может потребоваться автоматизация оборудования, параллельное проведение опытов или иной метод измерения.
Если задержка возникает после эксперимента — в очереди на обработку данных, изменении скриптов или подготовке визуализации, — более реалистичной выглядит стратегия Navigator. Небольшой пилот можно оценить по четырём показателям:
- время от получения сырых данных до доступного исследователю результата;
- трудозатраты на изменение анализа после обновления протокола;
- доля расчётов, которые удаётся воспроизвести из сохранённого кода и параметров;
- число экспериментальных вариантов, реально рассмотренных командой за один цикл.
Приведённые Сэнборном цифры — например, сравнение выбора из 500 кандидатов с прежней оценкой пяти — следует воспринимать как иллюстрацию из авторской колонки. В публикации нет методики измерения, независимой выборки компаний или контролируемого сравнения до и после внедрения LLM.
Поэтому Foundries и Navigators пока корректнее считать аналитической моделью, а не подтверждённой классификацией отрасли. Практический тест для конкретной лаборатории заключается в другом: определить, где теряется время — на физическом измерении или на работе вокруг него — и проверить изменение полного цикла на ограниченном проекте до масштабного внедрения.