Статья на arXiv от 11 ноября 2026 года описывает EM-ViT — метод, который во время работы робота адаптирует относительную оценку глубины с одной камеры к метрическому масштабу. Для этого он использует разреженные точки LiDAR и, по замыслу авторов, может дополнительно учитывать движение робота. Статья EM-ViT на arXiv не содержит независимой проверки метода.
Как относительную глубину переводят в метры
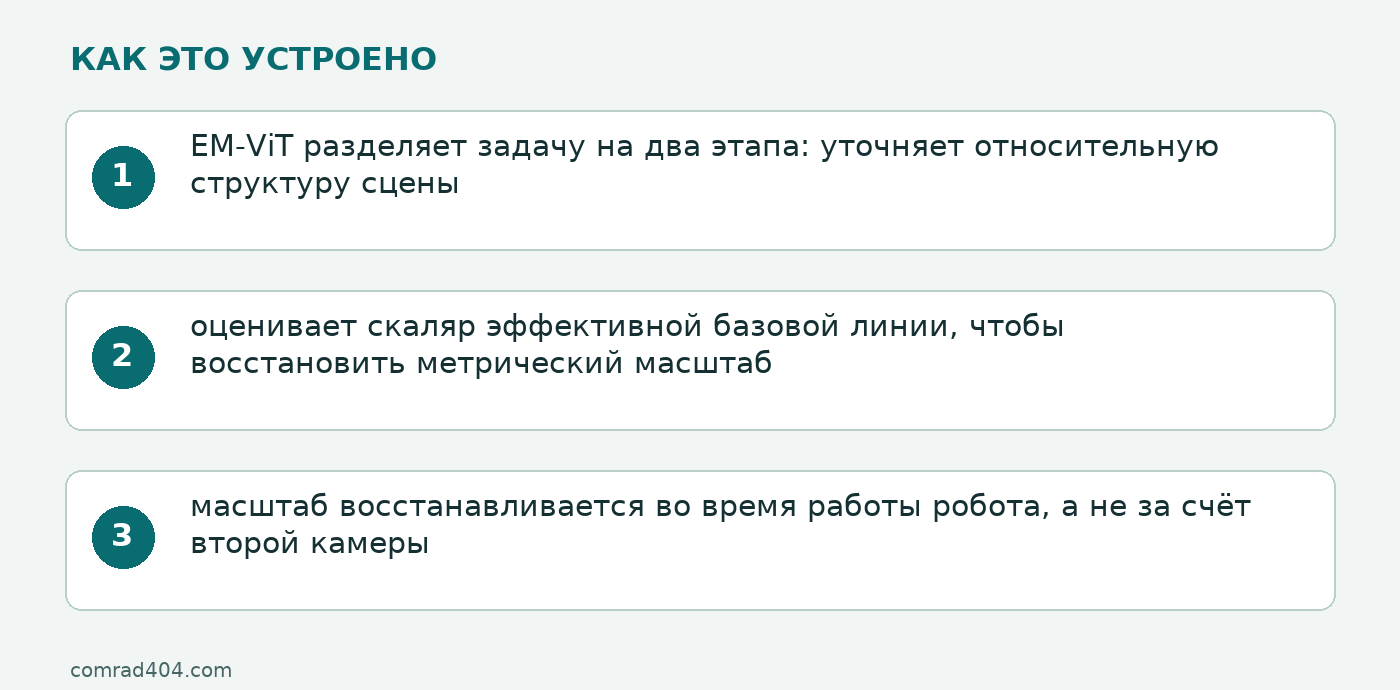
Модели монокулярной глубины могут оценивать, что находится ближе, а что дальше, но такая оценка не обязательно задаёт расстояния в метрах. EM-ViT разделяет задачу на два этапа: уточняет относительную структуру сцены через плотное уточнение disparity и оценивает скаляр эффективной базовой линии, чтобы восстановить метрический масштаб.
Авторы связывают такую декомпозицию с параметризацией стереокамер. При этом исходные оценки в описанном методе поступают с одной камеры: масштаб восстанавливается во время работы робота, а не за счёт второй камеры. Внутренняя функция потерь сопоставляет градиенты и, по словам авторов, помогает сохранять мелкие детали структуры disparity в реальном времени.
Какие данные нужны роботу
Процесс обучения лёгкого Vision Transformer использует разреженные точки LiDAR, а движение робота — ego-motion — может служить дополнительным источником данных. Поэтому метод не получает метрическую глубину только из изображения: ему нужны пространственные опорные измерения LiDAR, тогда как сведения о движении используются опционально.
Практический сценарий — работа в новой или неструктурированной среде, где предварительно обученная модель монокулярной глубины может хуже учитывать особенности сцены. Робот использует наблюдения, собранные во время движения, чтобы адаптировать оценку на месте. Это не означает, что EM-ViT устраняет потребность в LiDAR: разреженные точки участвуют в обучении.
Что авторы сообщают об оценке
Авторы описывают испытания на общедоступных последовательностях, включая KITTI, и заявляют, что их онлайн-конвейер адаптируется к новым сценам быстрее и точнее существующих foundation-моделей монокулярной оценки глубины.
Это вывод авторов статьи. В доступном описании нет числовой таблицы результатов, поэтому нельзя определить величину преимущества или сравнить метод по конкретным метрикам. Независимой проверки в использованных источниках также нет.
Доступность и ограничения
Авторы пишут, что код и дополнительные материалы будут опубликованы позднее. До такой публикации самостоятельное воспроизведение метода по статье ограничено. Для робота EM-ViT предлагает способ адаптировать монокулярную оценку к новой сцене, но описанный подход опирается на разреженные данные LiDAR и опциональное движение робота; приведённое авторами сравнение на последовательностях вроде KITTI не заменяет независимый тест.