JSON Schema как предохранитель для tool calling: проверяем LLM-вызовы в CI
Контрактная проверка отделяет ошибки формата от смысловых сбоев AI-агента. Разбираем, как валидировать имя инструмента и его аргументы, организовать тестовые сценарии...
Тема COMRAD404
Контрактная проверка отделяет ошибки формата от смысловых сбоев AI-агента. Разбираем, как валидировать имя инструмента и его аргументы, организовать тестовые сценарии...
GPT-5.5 используют в корпоративных агентных сценариях Databricks. OpenAI также заявила о рекорде на OfficeQA Pro, но не раскрыла в анонсе...
Разбираем, как работает семантическое кэширование в AI-агентах: какие библиотеки и подходы реально снижают расход токенов, где возникают ложные срабатывания и...
Ошибки в tool calling часто возникают не в бизнес-логике, а на границе между моделью и вашим API. Показываем, как зафиксировать...
Авторы нового препринта показали, что MARCH часто оценивает правильное и неправильное решения одинаково. Два показателя из журналов системы помогают заранее...
Авторы SlideLab предложили систему без дополнительного обучения моделей, которая планирует структуру научного доклада, собирает слайды и сверяет их с исходной...
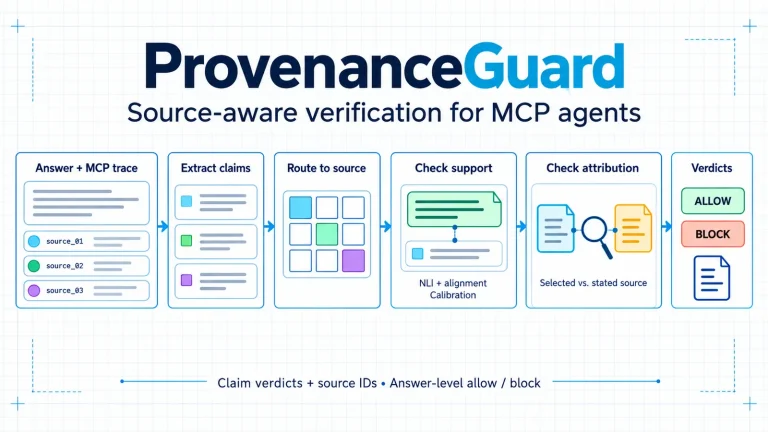
ProvenanceGuard сохраняет связь между утверждениями LLM-агента и данными конкретных MCP-инструментов. В медицинском тесте метод заблокировал 138 из 139 утверждений, которые...
OpenAI выпустила GPT-6.1 Sol для API и Codex, пообещав производительность, близкую к GPT-6 Astra, при заметно меньшей цене. Разбираем тарифы,...
Семантическое кэширование позволяет AI-агенту не переспрашивать LLM при похожих запросах, сокращая время ответа в 3–10 раз и экономя до 60%...
Исследователи представили CLUE — фреймворк, который помогает роботам самостоятельно разрешать неопределённость в неполных инструкциях на естественном языке. В испытаниях на...