COMRAD404

Лента

Новости, инструменты и практика ИИ

Как протестировать tool calling в LLM до продакшена: сценарии, метрики и автоматическая проверка

Практическая методика проверки tool calling в AI-агентах: синтетические сценарии, валидация аргументов, тесты цепочек, обработка ошибок и критерии допуска в продакшен.
OpenAI представила HealthBench: новый бенчмарк для оценки медицинских ИИ-моделей

Компания OpenAI анонсировала HealthBench — открытую систему оценки больших языковых моделей в реальных медицинских сценариях, разработанную при участии более 250 практикующих врачей.

Как оценивать стабильность контекста в LLM-агентах: разбор метрик, уязвимостей к «забыванию» и методов проверки

Разбираем практические методы оценки стабильности контекста у LLM-агентов. Анализируем метрики деградации памяти, проблемы «забывания» в длинных сессиях, бенчмарки и подходы к тестированию пайплайнов перед продакшеном.

Разобраться в теме

За чем вы следите?

Кейс Intercom и OpenAI: три архитектурных принципа масштабирования AI-агентов в поддержке

Команда Intercom поделилась опытом внедрения продакшн-систем на базе языковых моделей OpenAI. Разбираем автоматизированную оценку, модульную архитектуру и логику эскалации для разработчиков.

Воспроизводимость AI-бенчмарков не гарантирует верификации бизнес-заявлений

Аналитик проверил пять AI-проектов XPRIZE: технические результаты воспроизводились, но бизнес-заявления оказались сложнее. Например, “91,2%” зависели от метода агрегации, а “AI управляет бизнесом” скрывал три разных...

Рейтинг COMRAD404

Какая модель подходит для вашей задачи?

Топ-100 моделей: качество, код, скорость и стоимость. С фильтрами и описанием методологии.

Открыть рейтинг

Разбор производительности Claude Code против GPT-6 Codex на задаче миграции TypeScript-проекта

Сравнение двух ведущих AI-агентов для программирования на реальной задаче — миграция 15 000 строк TypeScript с устаревшей библиотеки на современную. Методика тестирования, метрики, ограничения и...

Anthropic запустила обновлённые Projects в Claude Code: мультиагентная координация в облаке

В Claude Code появилась бета-функция Projects — возможность запускать несколько AI-агентов в одном проекте с общей памятью, целями и репозиторием. Координатор распределяет задачи по тредам,...

ИИ-апокалипсис для рабочих мест: глобальный опрос Pew Research подтвердил самые мрачные ожидания

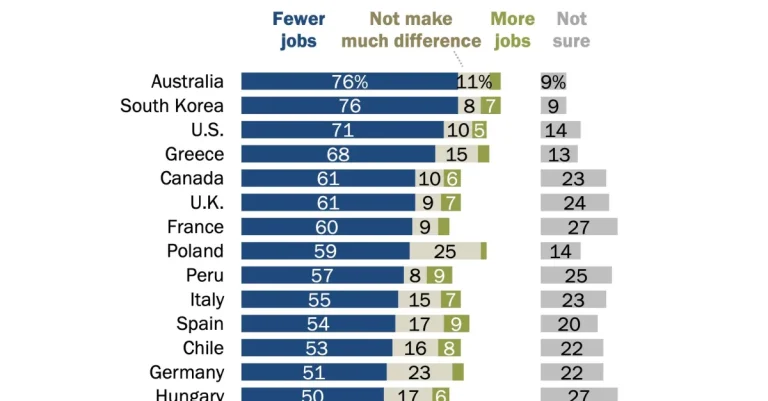
Крупнейшее за последние годы международное исследование Pew Research Centre, охватившее 42 151 респондента в 37 странах, показало: большинство жителей планеты уверены, что искусственный интеллект уничтожит...

Instinct и Muse от Meta получили функцию исходящих звонков

Instinct запускает Concierge для телефонных поручений, а Muse от Meta тестирует звонки компаниям в США. Обе функции доступны ограниченному кругу пользователей, а условия обработки ошибок...

Wolof и арабский: новый параллельный корпус MudawanSn для машинного перевода

Исследователи представили MudawanSn — золотой стандарт параллельного корпуса для пары языков волоф — современный стандартный арабский. 1271 предложение из новостного дискурса Сенегала, четыре бенчмарка моделей...

LLM под микроскопом: как OCR-шум убивает точность извлечения данных из документов

Новый бенчмарк наглядно демонстрирует, что даже лучшие open-source LLM (Gemma, Qwen2.5, DeepSeek) резко теряют качество при работе с реальным OCR. Исследователи выявили типовые ошибки: галлюцинации,...