29 сентября 2026 года исследователь и автор книг по машинному обучению Себастьян Рашка опубликовал в Ahead of AI технический разбор эволюции текстовых классификаторов. Отправной точкой для материала стала популярность Jev — сервиса для быстрой классификации данных с помощью модели общего назначения.
Главный тезис Рашки помещает Jev между двумя привычными классами инструментов. Универсальные GPT-подобные и открытые большие языковые модели способны решать те же задачи, но могут требовать больше времени и вычислительных ресурсов. Специализированный классификатор, обученный на конкретном наборе меток, обычно эффективнее в узком и стабильном сценарии. Jev, по оценке автора, интересен как компромисс: он шире специализированной модели, но сфокусированнее генеративной LLM.
Рашка подчёркивает, что не связан с Jev, не получал бесплатный доступ и не рассматривает публикацию как рекомендацию продукта. Его предположения о внутреннем устройстве системы основаны на наблюдаемом поведении, а не на раскрытой архитектуре. Поэтому материал следует читать как технический анализ и серию экспериментов, а не как независимый аудит сервиса.
От частот слов к моделям последовательностей
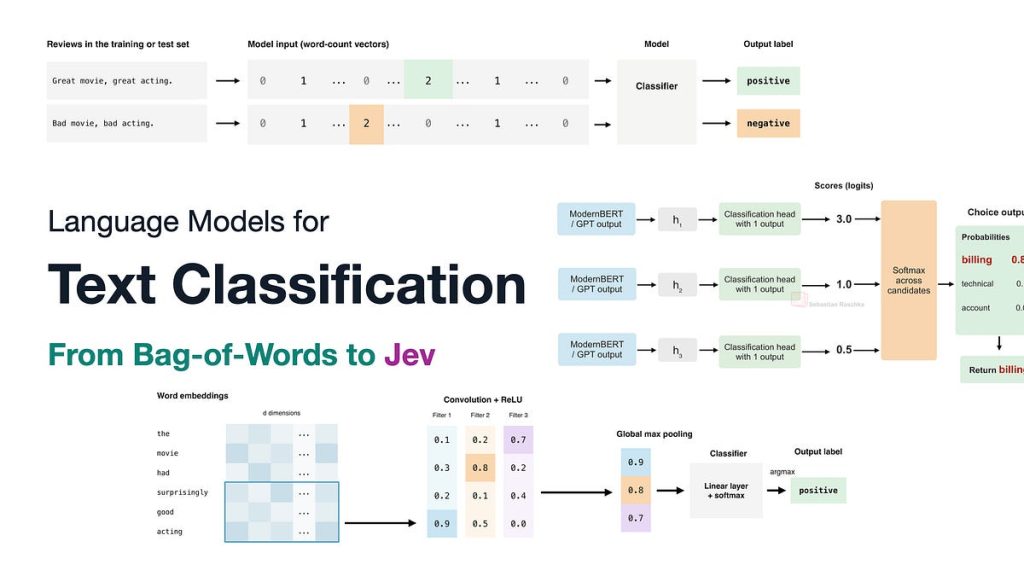
Историческую часть Рашка начинает с bag-of-words — представления, при котором документ преобразуется в вектор частот слов. Каждому элементу словаря отводится отдельная позиция: если словарь содержит 50 000 слов, документ получает вектор той же длины независимо от того, состоит он из десяти слов или из сотен тысяч. Большинство значений в таком векторе остаются нулевыми.
Полученное представление можно передать наивному байесовскому классификатору, логистической регрессии, SVM или другому классическому алгоритму. Такой конвейер сравнительно дёшев, хорошо интерпретируется и по-прежнему подходит для задач, где отдельные слова сильно связаны с меткой: например, для фильтрации спама или рубрикации новостей. Практическая реализация подобного подхода описана и в руководстве scikit-learn по работе с текстовыми данными.
Цена простоты — потеря порядка слов. Фразы «собака кусает человека» и «человек кусает собаку» при базовом bag-of-words состоят из одинаковых признаков, хотя описывают разные события. Частично проблему решают n-граммы, учитывающие пары или более длинные последовательности слов, но они увеличивают словарь и размерность входных данных.
Следующим этапом стали рекуррентные нейронные сети, способные последовательно обрабатывать токены и учитывать порядок. Свёрточные сети для текста предложили более параллельный способ находить локальные шаблоны. Трансформеры перенесли основной акцент на механизм внимания; архитектурный перелом подробно описан в работе Attention Is All You Need, опубликованной в 2017 году.
Как Рашка позиционирует Jev
По оценке Рашки, Jev нельзя корректно описать ни как обычный узкий классификатор, ни как полную замену универсальной LLM. Сервис ориентирован на классификацию, но допускает применение к разным схемам меток без создания отдельной модели для каждого сценария.
Автор формулирует три уровня выбора:
| Подход | Сильная сторона | Основное ограничение |
|---|---|---|
| Bag-of-words и классический классификатор | Низкая стоимость, высокая скорость, прозрачные признаки | Слабый учёт порядка слов и контекста |
| Специализированная нейросеть | Эффективность на стабильной узкой задаче | Нужны размеченные данные и отдельное обучение |
| Универсальная LLM | Гибкие инструкции и широкий набор задач | Более дорогой и медленный инференс |
| Jev в интерпретации Рашки | Классификация общего назначения с упором на эффективность | Внутренняя методология публично не подтверждена |
Это сравнение не доказывает, что Jev всегда дешевле любой LLM или точнее любого специализированного решения. В доступном описании нет универсального результата, который можно было бы перенести на все языки, домены и наборы меток. Производительность также зависит от длины входа, размера пакета, требований к задержке и способа расчёта стоимости.
Рашка признаётся, что сначала считал Jev продуктом, функциональность которого легко воспроизвести самостоятельно, но после знакомства с системой оценил её выше. Это личная оценка автора. Без раскрытия архитектуры нельзя подтвердить его гипотезу о том, какие именно оптимизации обеспечивают наблюдаемую скорость.
Старые методы сохраняют практический смысл
Для разработчиков наиболее полезна не попытка объявить победителя, а границы применимости каждого подхода. Если у команды есть качественная разметка, фиксированный набор категорий и большой поток однотипных запросов, логистическая регрессия, небольшая нейросеть или другой специализированный классификатор могут оказаться рациональнее внешнего API.
Такой вариант особенно уместен, когда важны предсказуемая задержка, локальная обработка данных и контроль стоимости одного запроса. Простую модель легче тестировать на закрытом наборе примеров, а её ошибку можно измерить отдельно по каждому классу.
Jev или универсальная LLM становятся интереснее, если схема категорий часто меняется, размеченных данных мало либо классификатор требуется запустить быстро. В этом случае команда обменивает часть контроля на более короткий путь от текстового описания задачи до работающего прототипа.
Для трансформерного базового решения можно также использовать стандартные модели классификации последовательностей. Общий процесс дообучения и оценки таких моделей приведён в документации Hugging Face Transformers. Это полезная контрольная точка для сравнения с API: она позволяет проверить, оправдывает ли удобство внешнего сервиса разницу в цене и качестве.
Что проверить перед выбором API
Сравнивать Jev с альтернативами лучше на собственных данных, а не на нескольких демонстрационных запросах. Минимальный тест должен включать отложенную выборку с реальными формулировками, редкие классы, неоднозначные примеры и тексты той длины, которая встречается в рабочем потоке.
Одной общей точности недостаточно. Для несбалансированных категорий полезно измерять precision, recall и F1 по каждому классу, а также строить матрицу ошибок. Если предсказанная уверенность используется для автоматического принятия решений, потребуется проверка калибровки: вероятность 0,9 должна соответствовать примерно одинаковой частоте правильных ответов на сопоставимых примерах.
Отдельно следует посчитать полную стоимость: цену запросов, задержку на типичном пакете, расходы на повторные обращения при сбоях и трудозатраты на поддержку собственной модели. Нужна и проверка правил обработки данных, если в запросах присутствует конфиденциальный текст.
Публикация Рашки даёт концептуальную рамку, но не раскрывает устройство Jev и не заменяет независимый бенчмарк. Практический вывод для команды — сравнить сервис как минимум с простым bag-of-words-бейзлайном и одной подходящей трансформерной моделью на одинаковой закрытой выборке. Без такого теста заявления о скорости, дешевизне и универсальности останутся характеристиками конкретной демонстрации, а не подтверждёнными свойствами рабочего решения.