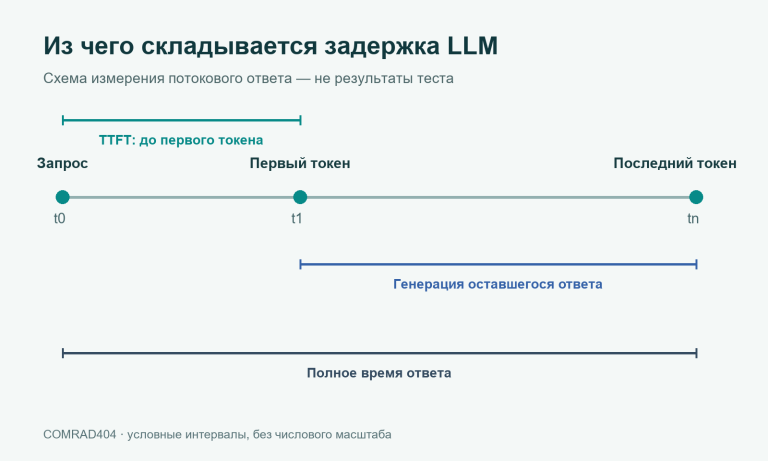
Как измерить задержку LLM: разложите время ответа на этапы
Разбираем, как измерить задержку LLM отдельно для установления соединения, ожидания первого токена и генерации ответа — и сравнить модели на...
Пошаговые инструкции по работе с нейросетями и ИИ-инструментами: установка, настройка, подключение моделей и автоматизация задач.
Разбираем, как измерить задержку LLM отдельно для установления соединения, ожидания первого токена и генерации ответа — и сравнить модели на...
Практический тест reranker для RAG: сравните исходную выдачу и переупорядочивание на размеченных запросах, измерьте Recall@k и MRR и проверьте, оправдывает...
WER показывает долю ошибок в расшифровке, но результат зависит от подготовки эталона. Разбираем, как собрать тест, посчитать метрику на русском...
Разбираем, как сравнить модели эмбеддингов на собственном корпусе: подготовить запросы и эталонные документы, измерить Recall@k и проверить, помогает ли новый...
Агент может правильно отвечать, пока инструменты работают без ошибок. Разбираем, как воспроизводимо проверить тайм-ауты, повторные вызовы и частичное выполнение задачи...
Практический способ проверить воспроизводимость ответов LLM: зафиксировать входные данные, повторить запросы и сравнить результаты до и после смены модели или...
Разбираем, когда повторять запрос к API языковой модели, как настроить экспоненциальную задержку и почему тайм-аут не всегда означает, что генерация...
Структурированный вывод может пройти проверку JSON Schema и всё равно содержать неверные данные. Разбираем, как проверить формат, значения и поведение...
Практический способ проверить RAG-систему отдельно по поиску документов и генерации ответа: набор вопросов, метрики, ручная проверка и разбор ошибок.
Практическая оценка ответов LLM начинается с проверяемой рубрики и набора примеров. Разбираем, как сравнивать модели, снижать влияние субъективности и проверять...
Цена за миллион токенов не показывает полную стоимость AI-функции. Разбираем, как посчитать расходы на запрос с учётом контекста, повторов, маршрутизации...
Проверка цитат RAG должна измерять не только наличие ссылок, но и связь между утверждением, найденным фрагментом и ответом модели. Разбираем...
JSON Schema помогает проверить, соответствует ли ответ модели ожидаемой структуре. Разбираем, что именно ловят контрактные тесты, как написать воспроизводимую проверку...
Позиция модели в лидерборде не гарантирует стабильную работу AI-агента. Разбираем методику Berkeley Function Calling Leaderboard и собираем собственный тест: выбор...
Инструкция по CrewAI v1.15.16: как установить CLI, создать JSON-first crew, выбрать sequential или hierarchical process, назначить задачи агентам и проверить...
Пошагово настройте память для AI-агента через OpenAI Agents SDK: одна session на весь диалог, проверка на двух репликах, ограничения retention,...
Пошагово разбираем, как клонировать собственный голос для озвучки через ElevenLabs, Descript, Resemble AI и OpenVoice: какой путь выбрать, как проверить...
Пошаговая инструкция по апскейлу изображения в Magnific AI через актуальный веб-интерфейс: выбор Creative или Precision, настройка scale, генерация, проверка результата...