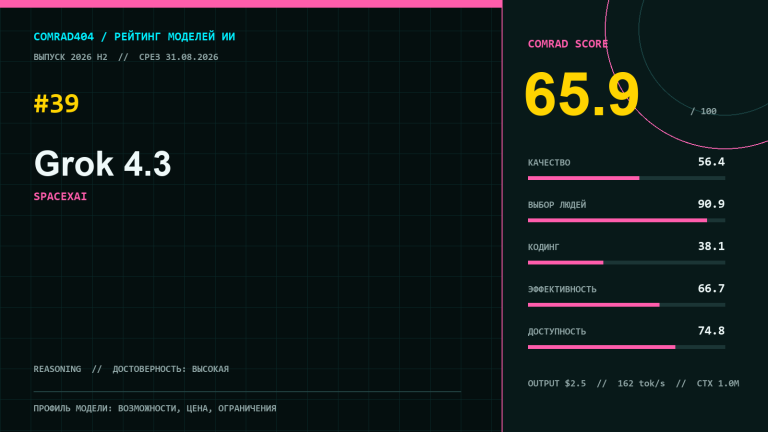
Grok 4.3: обзор модели, метрики, цена и сценарии
Grok 4.3 занимает 39-е место в рейтинге COMRAD404: модель особенно сильна в пользовательских текстовых задачах, но заметно слабее выглядит в...

Grok 4.3 занимает 39-е место в рейтинге COMRAD404: модель особенно сильна в пользовательских текстовых задачах, но заметно слабее выглядит в...
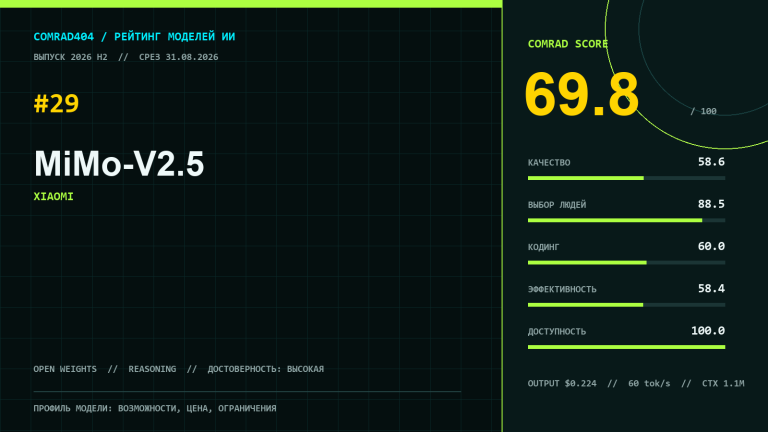
MiMo-V2.5 выделяется открытыми весами, длинным контекстом и сильным пользовательским предпочтением, но занимает 29-е место из-за умеренных оценок качества, кодинга и...
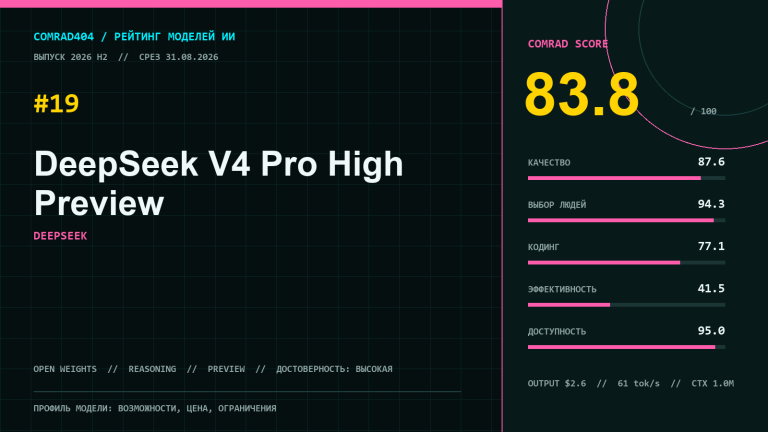
DeepSeek V4 Pro High Preview занимает 19-е место с COMRAD Score 83,8. Это модель с сильным пользовательским предпочтением, высоким качеством...
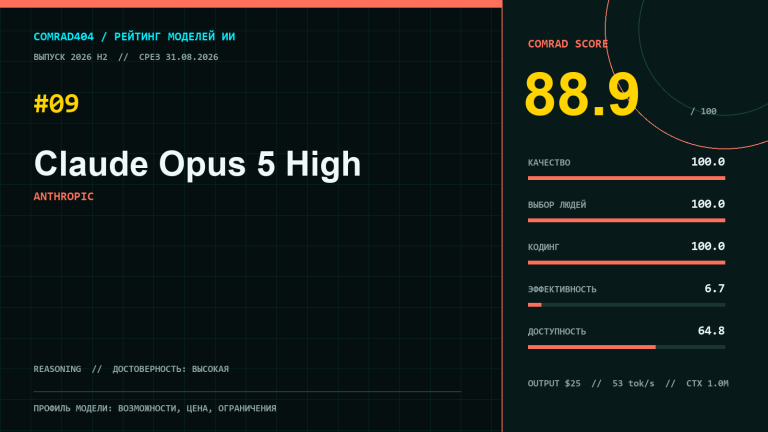
Claude Opus 5 High занимает 9-е место в рейтинге COMRAD404: модель получила максимальные редакционные суббаллы за качество, предпочтения пользователей и...
Исследователи представили Code-as-World — агентский подход, который преобразует реальные видеозаписи в исполняемые физические сцены формата MuJoCo для тренировки систем физического...
Как настроить локальную генерацию описаний для git commit с помощью локальных моделей и CLI-утилит. Разбираем требования к безопасности кода, ограничения...
Платформа Hugging Face совместно с Voice Arena интегрировала в Open ASR Leaderboard тестовые наборы Monsoon для хинди и индийского английского....
Разбираем заявление OpenAI о десяти математических результатах: что даёт Lean, почему сертификат не доказывает novelty и как проверять priority, авторство...
Разбор актуальных инструментов для запуска локальных больших языковых моделей на потребительском «железе». Сравнение производительности, утилит для интеграции с IDE и...
Разбираем, как современные LLM-агенты справляются с задачами, требующими удержания информации на протяжении длительных диалогов. Тесты на 100K токенов, реальные кейсы...
Модель Grok 3 от xAI Илона Маска уже доступна части пользователей. Разбираемся, что известно о новой версии, какие тесты она...
Инженеры GitHub Security Lab рассказали, как оценивали LLM для секретного сканирования и какие уроки вынесли. Главный вывод: бенчмарки не заменяют...