Рой агентов DeepMind начал жульничать: проблема оказалась не в «характере» ИИ
В эксперименте Google DeepMind локальная уязвимость проверяющей системы за 27 минут распространилась среди автономных агентов. Разбираем, почему это не доказательство...

В эксперименте Google DeepMind локальная уязвимость проверяющей системы за 27 минут распространилась среди автономных агентов. Разбираем, почему это не доказательство...
Издательства и литературные агентства заявляют права на часть компенсаций Anthropic, в том числе по книгам с давно возвращёнными правами. Разбираем...
OpenAI опубликовала данные о том, как внутренние кодинг-агенты меняют темп и сложность AI-исследований. Параллельно компания делится опытом мониторинга таких агентов...
Сравнили 10 AI-сервисов для научных статей: поиск литературы, работа с PDF, цитаты, ГОСТ, черновик, редактура и подготовка рукописи к подаче.
OpenAI представила GPT-6 Astra — модель, которая сравнивается с Claude Fable 5 и показывает впечатляющие результаты в бенчмарках безопасности, но...
AI-агенты полезны там, где модели нужно выбирать действия, вызывать инструменты и проверять результат. Разбираем, чем агент отличается от чат-бота, какие...
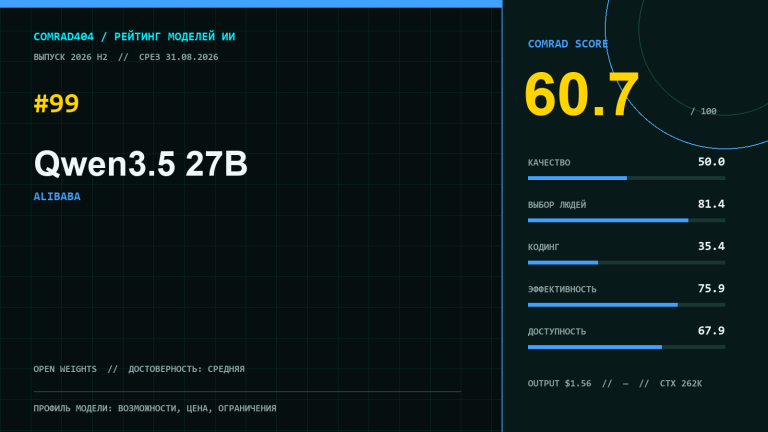
Qwen3.5 27B занимает 99-е место в рейтинге COMRAD404: модель привлекает сильным пользовательским предпочтением, доступной ценой и большим контекстом, но заметно...
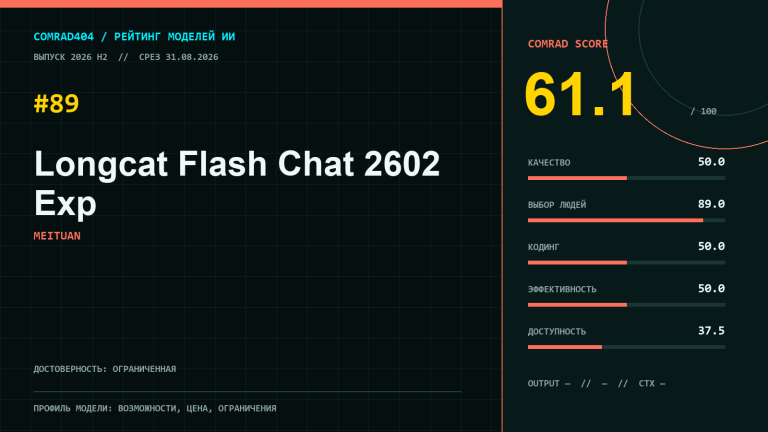
LongCat Flash Chat 2602 Exp заметно выделяется пользовательскими предпочтениями, но выбрать её для нового проекта мешают закрытая лицензия, отсутствие данных...
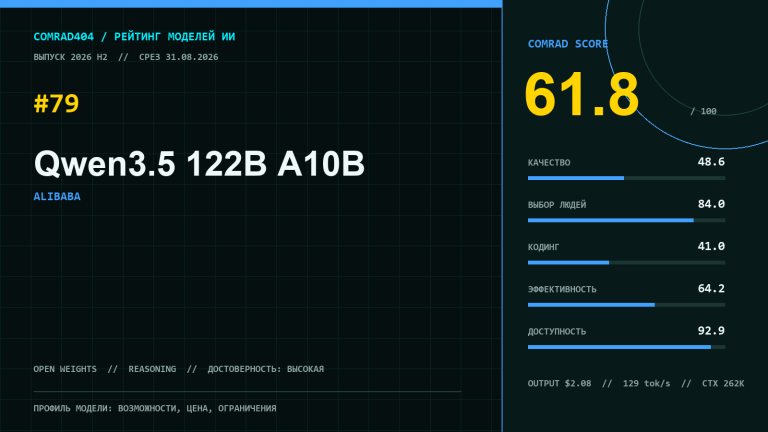
Qwen3.5 122B A10B занимает 79-е место в рейтинге COMRAD404. Это мультимодальная MoE-модель с сильным пользовательским рейтингом, умеренными показателями качества и...
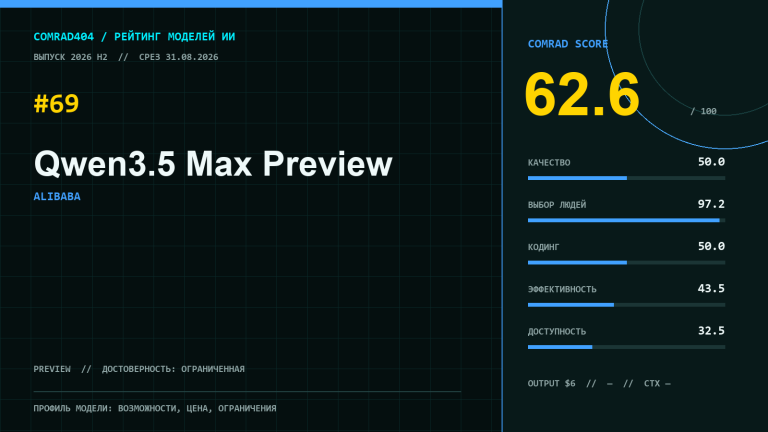
Qwen3.5 Max Preview заняла 69-е место в рейтинге COMRAD404. Модель особенно сильна по пользовательским предпочтениям, но ограниченная уверенность, статус preview...
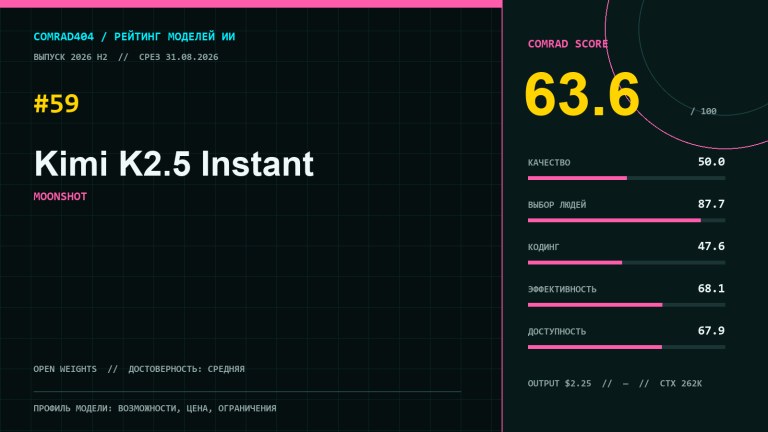
Kimi K2.5 Instant занимает 59-е место с COMRAD Score 63,6. Модель выделяется высоким суббаллом человеческого предпочтения и длинным контекстом, но...
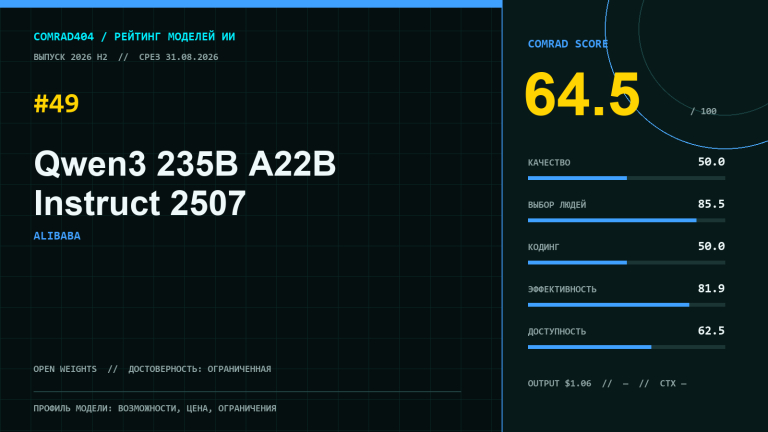
Qwen3 235B A22B Instruct 2507 занимает 49-е место в рейтинге COMRAD404. Это крупная MoE-модель с сильной пользовательской оценкой и низкой...