
Главный результат Orchard — не очередной агент, а попытка стандартизировать среду, в которой таких агентов обучают и проверяют. Microsoft Research предлагает вынести запуск инструментов, песочниц и пользовательских сценариев из конкретного training pipeline в отдельный Kubernetes-сервис. Это важное архитектурное решение: один и тот же слой можно использовать для программирования, работы с браузером и персональных ассистентов, не переписывая инфраструктуру под каждый новый тип задачи.
По данным авторов Orchard, такой подход помог поднять результат открытой модели сопоставимого размера на SWE-bench Verified с 61,4% до 73% с помощью обучения и последующего reranking. В статье на arXiv приведены другие значения для отдельной конфигурации — 64,3% после supervised fine-tuning и 67,5% после SFT с reinforcement learning. Расхождение нельзя замалчивать: вероятно, речь идет о разных версиях эксперимента или протоколах, но публикации не дают оснований складывать эти цифры в одну линейку.
Сильная сторона Orchard поэтому не в заявлении о «новом лучшем агенте». Ее следует искать в воспроизводимой связке из среды, данных, рецептов обучения и методик оценки. Если проект действительно будет удобен для независимых команд, он может снизить главный барьер открытых исследований: необходимость самостоятельно строить тысячи изолированных окружений, синхронизировать их с RL-системой и поддерживать сложные многошаговые harness-сценарии.
Почему агентам недостаточно обычного inference API
Обычная модель получает запрос, формирует ответ и завершает работу. Агент действует иначе: он читает файлы, вызывает инструменты, запускает тесты, открывает веб-страницы, делает несколько ходов подряд и реагирует на промежуточные результаты. Ошибка в одном шаге меняет состояние среды и влияет на последующие решения.
Из этого следуют два требования.
Во-первых, каждый запуск должен происходить в изолированном окружении. Для программного агента это может быть отдельный контейнер с репозиторием, зависимостями, терминалом и тестами. Для браузерного агента — собственный браузер с сохранением состояния вкладок и интерфейса. Для персонального ассистента — набор почтовых, календарных и других инструментов, которые нельзя бездумно смешивать между параллельными экспериментами.
Во-вторых, окружение должно масштабироваться. Обучение с подкреплением требует большого количества rollout — попыток агента решить задачу. Если каждый запуск поднимается вручную, исследователь быстро упирается в операционные расходы: создание песочниц, очистку состояния, сбор логов, маршрутизацию запросов к модели и уничтожение неудачных экземпляров.
Microsoft Research описывает существующий ландшафт как фрагментированный. Одни системы занимаются orchestration и вызовами инструментов, другие — обучением моделей, третьи — оценкой. При этом многие современные агенты работают внутри сложных harness-систем: Claude Code, Codex, OpenClaw и других. Такой harness управляет многошаговым диалогом, памятью, инструментами и внешними сервисами. Если обучать модель в упрощенной подмене, а использовать затем в настоящем harness, возникает разрыв между тренировкой и применением.
Orchard адресует именно этот разрыв. Его центральный компонент, Orchard Env, задуман как тонкий сервис управления окружениями, а не как очередная система, диктующая агенту способ работы.
Orchard Env: инфраструктура вместо монолитного фреймворка
В основе Orchard Env лежит Kubernetes. Сервис создает, запускает, изолирует и удаляет компоненты окружения параллельно; Microsoft заявляет о поддержке тысяч изолированных компонентов. Важна не сама цифра, а модель ответственности: training framework отвечает за обучение, а Orchard Env — за жизненный цикл среды, в которой агент действует.
Это позволяет переиспользовать один слой на разных этапах:
- сбор и дистилляция траекторий;
- supervised fine-tuning;
- rollout для reinforcement learning;
- финальная оценка;
- запуск разных harness-систем и наборов инструментов.
Такая декомпозиция полезна исследовательским группам, которые часто меняют сразу несколько переменных. Можно заменить benchmark, модель, алгоритм RL или harness, сохранив механизм создания песочниц. В традиционном подходе изменение одного компонента нередко требует адаптировать всю цепочку.
Отдельное значение имеет идея harness-agnostic обучения. Orchard использует легковесный proxy, который обслуживает вызовы модели со стороны harness и записывает их как данные для обучения. При этом сама траектория выполняется в отдельном контейнере. Иными словами, исследователь может не имитировать поведение Codex или OpenClaw внутри абстрактного агента, а обучать систему в том окружении, где она затем будет работать.
Это не устраняет все проблемы. Proxy должен корректно обрабатывать многошаговые вызовы, ошибки, тайм-ауты, параллельные процессы и мультимодальные данные. Кроме того, воспроизводимость зависит не только от контейнера, но и от версий браузера, библиотек, внешних API, исходных репозиториев и скрытых тестов. Kubernetes дает управляемость, но не превращает динамичный интернет или чужую codebase в детерминированный эксперимент.
Orchard-SWE: обучение на полезных частях неудачных попыток
Самый детально описанный рецепт Orchard относится к software engineering. В его основе — Mini-SWE-Agent и проверка на SWE-bench Verified, где агент должен разобраться в реальной задаче из GitHub Issues, внести исправления и пройти скрытые тесты.
Для обучения Microsoft Research заявляет о дистилляции 107 тысяч взаимодействий от двух open-weight-моделей — MiniMax-M2.5 и Qwen3.5-397B. Здесь важна не только величина набора, но и способ обработки неудачных траекторий.
Обычная схема может отбросить попытку, если итоговый patch не решил задачу. Orchard использует credit-assignment SFT: из незавершенной траектории сохраняются продуктивные сегменты. Например, агент мог правильно найти нужный файл, воспроизвести ошибку и сформулировать направление исправления, но ошибиться на последнем шаге. Такая попытка не равна успешному решению, однако содержит полезный сигнал.
Дальше применяется reinforcement learning с проблемой разреженной награды. В SWE-bench итоговая обратная связь часто сводится к тому, прошел ли patch скрытые тесты. Между началом работы и финальным результатом могут быть десятки команд, чтение исходников и промежуточных проверок, но система получает мало информации о качестве каждого отдельного шага.
Для повышения плотности сигнала авторы описывают несколько методов:
- Balanced Adaptive Rollout, который должен эффективнее распределять попытки при редких успешных результатах;
- on-policy distillation, где более сильная teacher-модель оценивает решения агента пошагово;
- process reward model, оценивающая не только финальный patch, но и процесс — воспроизведение бага, написание теста, проверку исправления и сохранение прежнего поведения;
- value model, обученная на прошлых траекториях и используемая для выбора между несколькими кандидатами.
Последний элемент особенно интересен с практической точки зрения. По данным Microsoft Research, для reranking использовалась компактная value model на 4 млрд параметров, обученная на траекториях из 20 предыдущих экспериментов. Агент генерирует несколько решений, после чего отдельная модель выбирает наиболее перспективное.
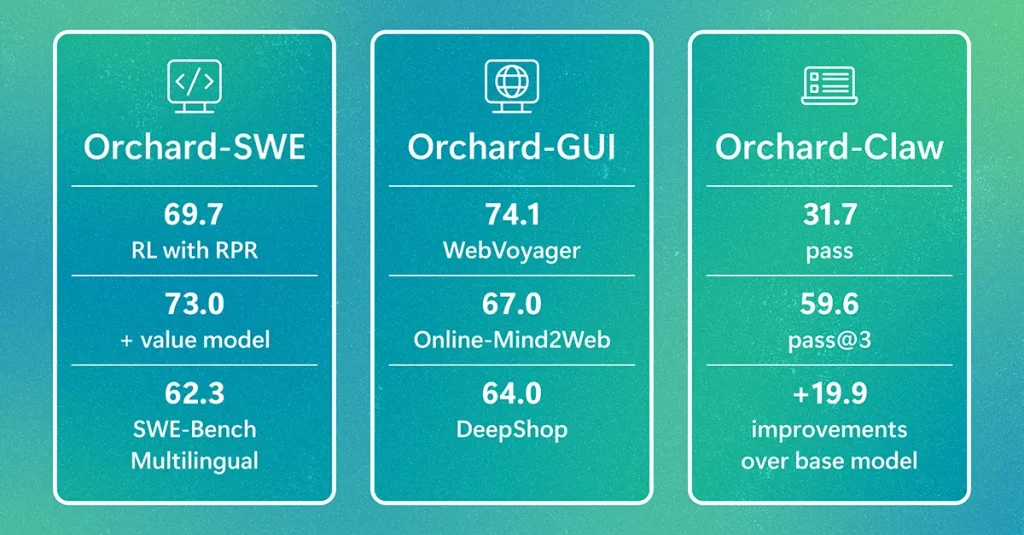
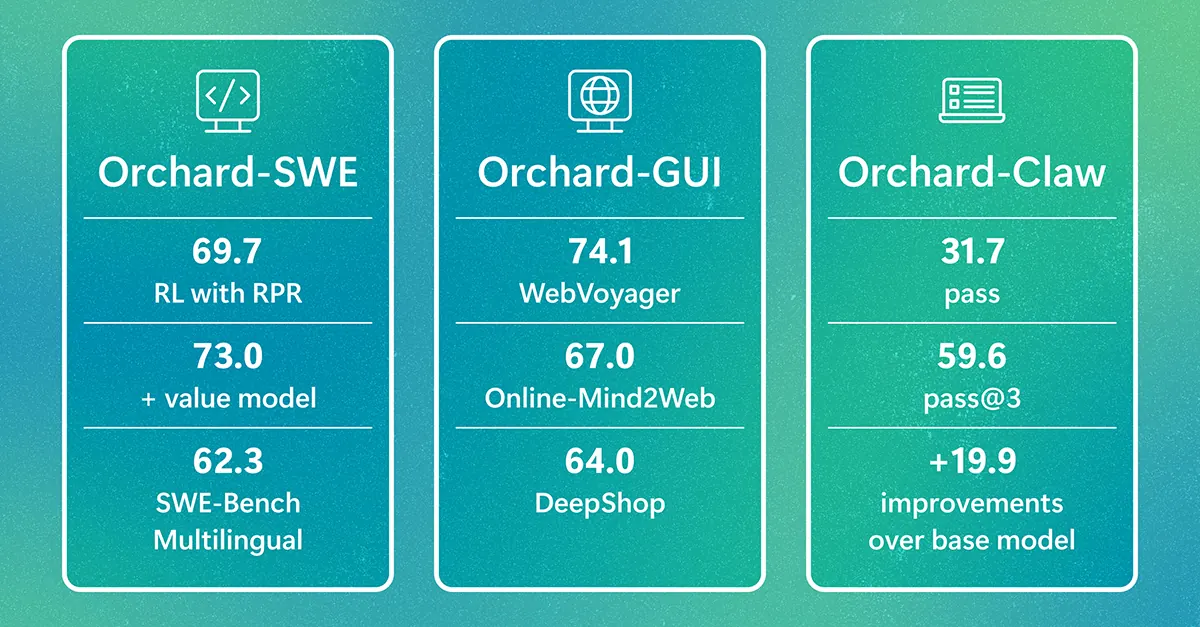
В блоге Microsoft указана последовательность от 61,4% базового результата до 69,1% после Balanced Adaptive Rollout, 69,7% после методов плотной награды и 73% после reranking. В arXiv-версии Orchard приведена другая конфигурация: Qwen3-30B-A3B-Thinking достигает 64,3% после SFT и 67,5% после SFT+RL. Поэтому корректная формулировка выглядит так: авторы показывают значительный прирост в нескольких экспериментальных конфигурациях, но опубликованные материалы не позволяют напрямую сравнить все этапы как единый строго контролируемый ablation study.
Есть и более фундаментальное ограничение SWE-bench. Прохождение скрытых тестов — сильный, но узкий критерий. Он не гарантирует, что patch оптимален по архитектуре, понятен сопровождающей команде или не создает долгосрочный технический долг. Более того, результат может зависеть от выбора задач, версии benchmark и состава использованных моделей. Для инженерной практики нужны дополнительные проверки: качество кода, стабильность на новых репозиториях, безопасность изменений и способность восстанавливаться после неверного действия.
Orchard-GUI: небольшие данные, но сложная проверка
Браузерный агент сталкивается не с текстовым репозиторием, а с визуальным интерфейсом. Ему нужно распознавать расположение элементов, учитывать динамическое состояние страницы, работать с формами и выполнять задачу, сформулированную на естественном языке.
Для Orchard-GUI Microsoft Research описывает vision-language-модель на 4 млрд параметров. На этапе обучения использовались 400 дистиллированных демонстраций и 2200 открытых задач. Авторы сообщают следующие показатели:
- 74,1% на WebVoyager;
- 67,0% на Online-Mind2Web;
- 64,0% на DeepShop;
- среднее значение — 68,4%.
Эти цифры выглядят убедительно именно на фоне заявленного объема supervision. Но слово «задача» здесь не равно универсальному опыту работы в интернете. Результат зависит от сайтов, доступных инструментов, политики повторных попыток и того, насколько тестовые сценарии похожи на обучающие.
В браузерных benchmark особенно легко получить скрытое преимущество за счет деталей окружения. Версия браузера, задержки сети, начальное состояние аккаунта, разрешение экрана и доступность конкретных элементов могут заметно изменить сложность задания. Поэтому перенос результата Orchard-GUI на произвольные корпоративные веб-приложения пока не доказан.
Зато сам принцип повторного использования среды остается ценным. Если исследователь может подключить новый benchmark без переписывания менеджера контейнеров, он быстрее проверит гипотезу и заметит, где улучшение относится к модели, а где — к особенностям конкретного теста.
Orchard-Claw и влияние harness на результат
Третий рецепт, Orchard-Claw, нацелен на персональных ассистентов и workflows с электронной почтой, календарем и другими инструментами. В arXiv-описании говорится о 200 синтетических задачах и результате 59,6% pass@3 на Claw-Eval. При использовании более сильного ZeroClaw harness показатель, по данным авторов, повышается до 73,9% pass@3.
Эта часть особенно хорошо показывает, почему инфраструктура не является нейтральной оболочкой. Один и тот же базовый агент может демонстрировать разные результаты в зависимости от harness. Он определяет, как организованы повторные вызовы, какие инструменты доступны, как передается контекст и каким образом система реагирует на ошибки.
Но одновременно это усложняет интерпретацию benchmark. Улучшение до 73,9% нельзя автоматически считать заслугой одной модели или одного обучения: в конфигурации меняется harness. В данном случае правильнее говорить о результате связки «модель плюс ZeroClaw», а не о чистом качестве Orchard-Claw.
Соседняя работа OpenForge RL из предоставленного пакета рассматривает близкую задачу — обучение harness-native-агентов через proxy и Kubernetes-оркестрацию. В ней авторы также сообщают, что выбор harness существенно влияет на сложность обучения, а reinforcement learning улучшает надежность, покрытие инструментов и завершение многошаговых планов. При этом восстановление после ошибок остается слабым местом.
Это не независимое подтверждение результатов Orchard: работы используют схожую архитектурную идею и не заменяют повторение экспериментов сторонней командой. Однако наблюдение важно как контекст. Переносимость между harness может быть не только преимуществом, но и новым источником вариативности.
Что именно открывает Orchard — и чего не открывает
Открытая инфраструктура может сократить стоимость входа в исследования, но не делает эксперименты бесплатными. Для Orchard нужны Kubernetes-кластер, вычислительные ресурсы для параллельных rollout, хранилище траекторий, изоляция сетевого доступа и система контроля секретов. В сценариях с браузером или почтой добавляются вопросы конфиденциальности и безопасного доступа к внешним сервисам.
Практический эффект можно разложить на четыре уровня.
Первый — операционный. Команде не нужно каждый раз с нуля проектировать запуск и удаление окружений.
Второй — методологический. Данные, рецепты обучения и оценку можно повторно применять в разных доменах.
Третий — исследовательский. Появляется возможность обучать агента внутри реального harness, а не в упрощенной копии.
Четвертый — сравнительный. Общая инфраструктура теоретически упрощает честное сопоставление разных моделей и алгоритмов.
Но открытие кода, данных и evaluation methods само по себе не гарантирует воспроизводимость. Нужно опубликовать точные версии моделей, параметры генерации, seed, состав задач, ограничения по времени и числу попыток, конфигурацию harness и правила обработки неудачных rollout. Без этого benchmark остается скорее заявлением о верхней границе, достигнутой авторами, чем готовым независимым стандартом.
Отдельная проблема — безопасность. Агент, который умеет менять код, открывать сайты или работать с почтой, обладает реальным воздействием на среду. Изоляция контейнеров снижает риск, но не решает его полностью. Необходимы ограничения сетевого доступа, минимальные права, очистка секретов, журналирование действий и проверка того, что тестовый агент не может выйти за пределы сценария.
Как проверять Orchard без веры в один показатель
Для команды, которая рассматривает Orchard как основу собственного исследования, разумен поэтапный тест.
Сначала следует запустить одну и ту же базовую модель в двух режимах: внутри Orchard Env и в существующей локальной среде. Сравнивать нужно не только процент успешных задач, но и время подготовки rollout, долю технических сбоев, расход вычислений, число повторных запусков и полноту логов.
Затем стоит провести ablation study:
базовая модель без дополнительного обучения;
модель после SFT;
3. SFT плюс RL;
4. RL с плотной наградой;
5. несколько кандидатов с reranking.
Для каждой ступени должны сохраняться одинаковые задачи, лимиты, harness и правила оценки. Иначе нельзя понять, что именно дало прирост.
Следующий тест — переносимость. Обучение на одном наборе репозиториев нужно проверять на новых проектах; браузерные сценарии — на сайтах, не представленных в демонстрациях; персонального ассистента — на новых комбинациях инструментов. Важно измерять не только pass rate, но и типы ошибок: неверный выбор инструмента, потеря контекста, преждевременная остановка, повреждение состояния и неспособность откатиться.
Наконец, нужно проверить качество против более сильного внешнего judge или человеческой оценки. В software engineering прохождение тестов не заменяет code review. В браузерных задачах формально успешное действие может сопровождаться лишними кликами или небезопасным поведением. В задачах ассистента pass@3 не говорит, насколько надежно агент обращается с чувствительными данными.
Такой протокол не опровергает заявленные Microsoft результаты. Он проверяет другое: сохраняется ли преимущество Orchard за пределами тех условий, в которых его получили авторы.
Вердикт: важнее слой среды, чем очередной «самый умный» агент
Orchard представляет интерес как инфраструктурная гипотеза: агентное обучение следует строить вокруг повторно используемой среды, а не встраивать управление окружением в каждый отдельный training stack. Это кажется более долговечной идеей, чем конкретные проценты на одном поколении benchmark.
Наиболее убедительно выглядят три решения: обработка полезных фрагментов неудачных траекторий, обучение внутри настоящих harness и отделение жизненного цикла контейнеров от алгоритмов обучения. Вместе они могут сделать эксперименты дешевле по времени и доступнее для групп, которые не располагают закрытой инфраструктурой крупных лабораторий.
Слабое место — интерпретация результатов. В материалах Microsoft Research и arXiv присутствуют разные показатели для Orchard-SWE; данные по Orchard-GUI и Orchard-Claw требуют учета особенностей конкретных benchmark и harness; независимой репликации в предоставленном пакете нет. Поэтому Orchard пока стоит воспринимать не как доказательство того, что небольшая модель уже сравнялась с frontier-системами, а как набор инструментов для проверки, насколько далеко ее можно продвинуть при правильной организации обучения.
Вывод изменится, если сторонние команды воспроизведут результаты на тех же конфигурациях, покажут перенос на новые домены и опубликуют стоимость полного эксперимента. Если же прирост резко исчезнет при смене harness, репозиториев или сайтов, это будет означать, что Orchard эффективен прежде всего как тщательно настроенный исследовательский стенд.
На текущем этапе проект важен именно потому, что переносит разговор об агентном ИИ с уровня демонстраций на уровень инженерии. Для автономных систем мало научиться хорошо отвечать. Нужно надежно запускать тысячи попыток, изолировать их, записывать каждое действие, обучаться на частичных успехах и проверять поведение в среде, где агент действительно будет работать. Orchard предлагает для этого открытую основу — но ее главные обещания еще предстоит проверять не по рекламной траектории, а по воспроизводимым экспериментам.