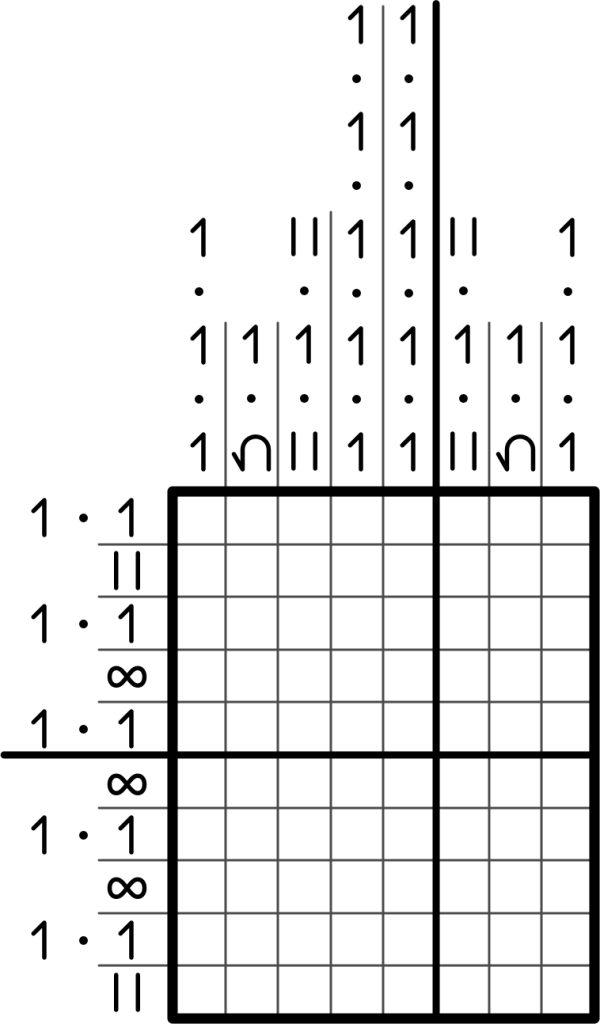
В Nonobench v1.2 сравнили 43 языковые модели на нонограммах — японских кроссвордах, где картинку восстанавливают по числам в строках и столбцах. По опубликованному автором теста описанию, DeepSeek V4 Pro набрала 83% на основном наборе и делит четвёртое место. В новом режиме Hard ни одна из протестированных моделей с открытыми весами не решила ни одной задачи из десяти размером 20×20.
Что изменили в тесте
Обновление учитывает замечания к предыдущей версии. Усилие рассуждения теперь указывается для каждого запуска, а промпты и ответы доступны публично. Кроме того, задачи Hard требуют отвечать по строкам: такой формат должен снижать вероятность ошибки при подсчёте символов в длинной строке.
Это важно для интерпретации результатов. Тест проверяет не только способность модели рассуждать о логике задачи, но и то, насколько надёжно она выдаёт ответ в требуемом формате. Ошибка в подсчёте или записи может испортить результат даже при верном ходе решения.
Результаты и границы сравнения
Автор сообщает, что GPT-6 Astra решила все 30 задач основного набора 15×15 — это первый идеальный результат в опубликованных прогонах Nonobench. DeepSeek V4 Pro показала 83%, а DeepSeek V4.1 Flash — 77%; для последней автор указывает общую стоимость запуска $0,84.
В Hard проверили десять случайных нонограмм 20×20, у каждой — одно решение. Лучший результат, согласно посту, у Opus 5.5: 8 из 10. Все открытые модели получили 0 из 10. Это результат именно данной выборки и конфигурации теста, а не доказательство того, что открытые модели в принципе неспособны решать задачи такого размера.
Практический смысл
Nonobench даёт разработчикам наглядный пример того, как модели справляются с многошаговой логической задачей и точным структурированным выводом. Публикация промптов и ответов позволяет изучать отдельные ошибки, а не ограничиваться итоговой таблицей.
Но один бенчмарк не даёт основания напрямую переносить рейтинг на программирование, агентные сценарии или другие виды рассуждений. Результаты зависят от набора головоломок, параметров запуска и правил оценки. Кроме того, автор отмечает, что пока тест запускается только через API и локальный запуск недоступен.
Источники:
— Пост о Nonobench v1.2 в Reddit r/LocalLLaMA
— Сайт Nonobench