
Microsoft Research в партнёрстве с научной группой опубликовала в журнале Nature статью, описывающую RetroChimera — фреймворк для машинно-обучаемого ретросинтеза малых молекул. В слепом тесте докторанты-химики отдали предпочтение реакциям, предложенным RetroChimera, перед предсказаниями предшествующих моделей и даже перед реакциями из тестовой выборки. Исходный код опубликован на GitHub под лицензией MIT; веса модели доступны через Microsoft Foundry.
Планирование синтеза — ключевой этап при разработке лекарств, новых материалов и агрохимикатов. Если вычислительная химия уже научилась генерировать миллионы перспективных структур, то обратная задача — «как это собрать из доступных реагентов» — остаётся ручным, медленным и дорогим этапом. RetroChimera пытается автоматизировать именно эту часть цикла «дизайн — синтез — тест».
Что изменилось
Что такое ретросинтез и почему он сложен
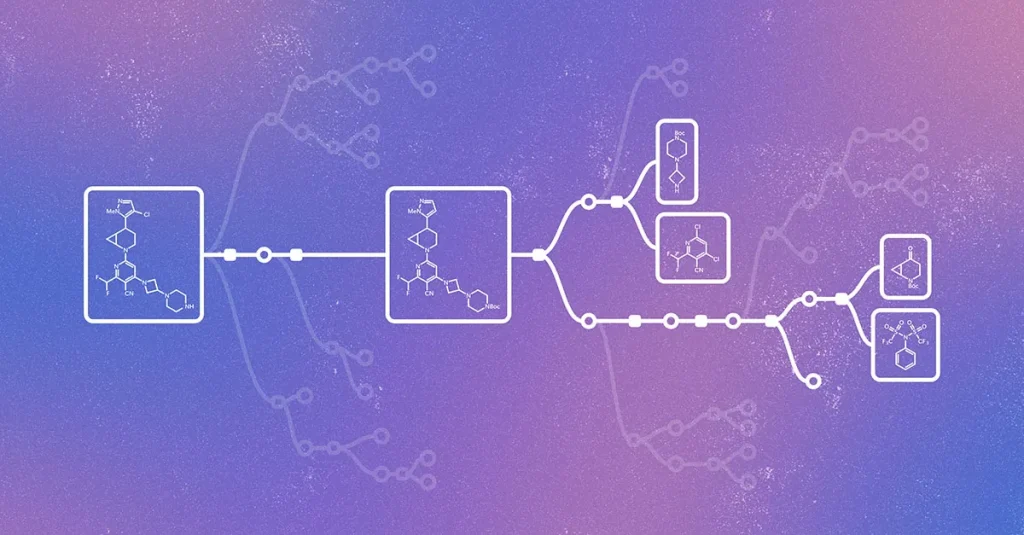
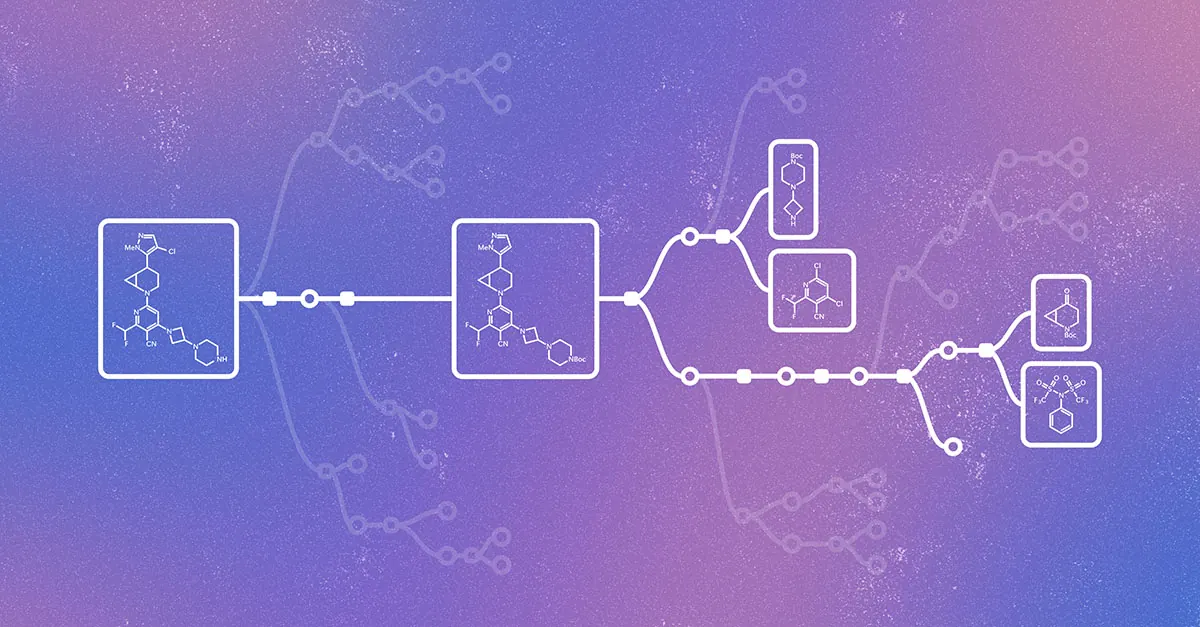
Ретросинтез — это стратегия, при которой целевую молекулу мысленно «разбирают» на более простые предшественники, двигаясь от конечного продукта к коммерчески доступным строительным блокам. Каждый шаг — это выбор одной из тысяч возможных реакций. Число комбинаций быстро превышает возможности полного перебора, и система должна не только знать «ходы», но и уметь выстраивать многошаговую стратегию.
Существующие модели делятся на два класса. De-novo модели, такие как трансформеры, генерируют предшественники напрямую — они гибки, но склонны к галлюцинациям. Шаблонные модели, основанные на графовых нейросетях, выбирают реакцию из библиотеки проверенных шаблонов — они точнее, но ограничены покрытием обучающего набора. RetroChimera построена на том, что эти подходы не конкурируют, а дополняют друг друга.
Кого это касается
Как устроен RetroChimera
Фреймворк объединяет две новых модели, разработанные в Microsoft Research:
R-SMILES 2 — трансформерная модель, работающая со строковым представлением молекул (SMILES). Она предсказывает продукты реакции без ограничения на шаблоны, что даёт ей преимущество в редких или сильно изменяющих структуру реакциях. Однако качество падает, когда нужно точно локализовать изменение.
NeuralLoc — графовая нейросеть, которая кодирует и целевую молекулу, и шаблоны реакций как графы. Она выбирает подходящий шаблон и определяет атомы, участвующие в разрыве связей. NeuralLoc точна на локальных, хорошо известных превращениях, но может пропускать необычные пути.
RetroChimera использует обучаемую стратегию ансамблирования: каждая модель присваивает предсказанному набору реагентов взвешенный голос, зависящий от ранга. Если обе модели предлагают одну и ту же реакцию, голоса суммируются. Таким образом, система автоматически адаптируется к типу реакции — отдавая предпочтение более гибкой или более точной модели в зависимости от контекста.
Результаты: победа над литературой
В серии экспериментов RetroChimera сравнивали с предшествующими подходами на нескольких датасетах, включая крупнейший из доступных — USPTO (патентные реакции США). Модель стабильно превосходила как каждую из составляющих по отдельности, так и существующие бенчмарки, включая GraphRetro, LocalRetro и трансформерные решения.
Наиболее показательный результат — слепой тест с участием семи докторантов-химиков. Им показывали целевую молекулу, разбитую на фрагменты разными методами, без указания источника. Химики последовательно выбирали разбиение, предложенное RetroChimera, как более реалистичное — даже если альтернативой была реакция из реальной литературной записи. Авторы подчёркивают, что это не просто метрика top-k accuracy, а практическая проверка на соответствие экспертному знанию.
Доступность и практическое значение
RetroChimera доступна на GitHub с MIT-лицензией. Для загрузки обученных весов необходимо обратиться к инструкции в репозитории; модель также можно запустить через Microsoft Foundry. Это означает, что любой исследователь или разработчик может интегрировать её в свои пайплайны — от локального скрипта до корпоративной платформы.
Для практиков важно: RetroChimera не решает задачу планирования многошагового синтеза целиком. Она предсказывает только один шаг ретросинтеза. Для полного пути нужна дополнительная поисковая стратегия — например, дерево поиска с отсечениями. Однако, как отмечают авторы, качество каждого отдельного шага является критическим ограничением для любого многошагового планировщика. Улучшение базового предсказателя напрямую повышает качество конечных маршрутов.
Ограничения и что дальше
Пока RetroChimera обучена на патентных данных, которые имеют свои смещения: они отражают реакции, которые авторы патентов сочли достойными упоминания, а не всё пространство возможной химии. Перенос на внутренние датасеты фармкомпаний, как показано в статье, возможен, но требует дообучения или тонкой настройки.
Кроме того, модель не оценивает практическую выполнимость реакции — выход, время, стоимость реагентов, безопасность. Это остаётся задачей для последующих модулей или экспертной оценки.
Авторы рассчитывают, что открытый код и приглашение к экспериментам позволят сообществу быстро выявить слабые места модели, особенно на редких или нестандартных классах реакций. Учитывая, что RetroChimera уже прошла рецензирование в Nature и показала предпочтение со стороны живых химиков, это один из самых серьёзных кандидатов на роль стандартного предиктора ретросинтеза в ближайшие годы.
Что стоит проверить самостоятельно
Исходный код на GitHub позволяет воспроизвести основные эксперименты на открытых датасетах. Для тех, кто работает в drug discovery или материаловедении, имеет смысл протестировать модель на своих целевых молекулах — особенно на структурах, которые плохо покрываются существующими шаблонными системами. Microsoft Foundry предоставляет облачный доступ без необходимости локальной настройки.
Статья в Nature доступна по ссылке в блоге Microsoft Research; сопроводительный материал содержит полные метрики и описание архитектуры.