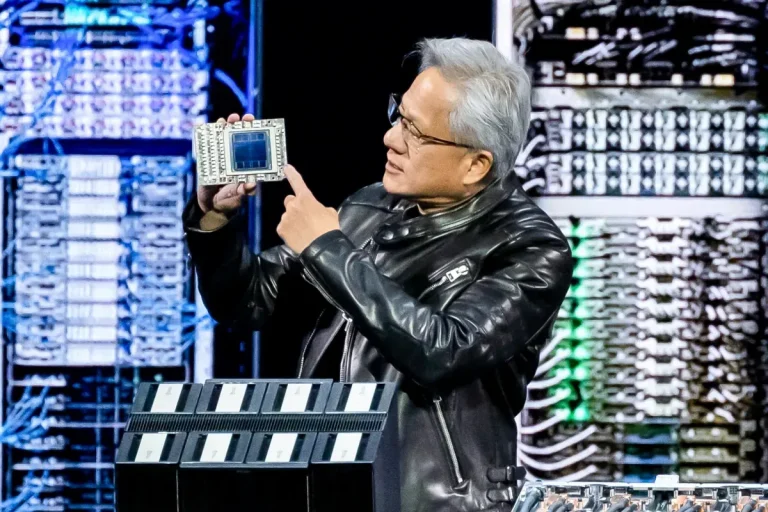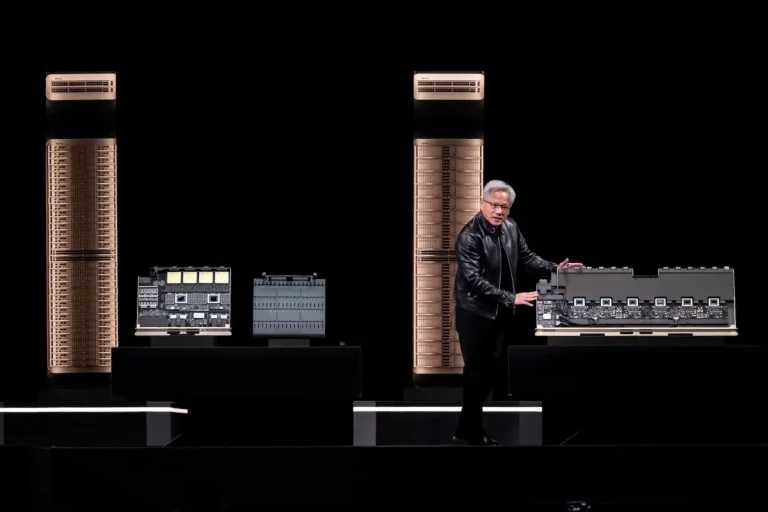
NVIDIA смещает акцент с GPU на оркестрацию данных: что показала архитектура Vera Rubin
После отчета за второй квартал 2026 года инвесторы пересматривают оценку NVIDIA: ключевым фактором становится не сырая мощность GPU, а эффективность...
Тема COMRAD404
После отчета за второй квартал 2026 года инвесторы пересматривают оценку NVIDIA: ключевым фактором становится не сырая мощность GPU, а эффективность...
Облачный инфраструктурный провайдер Lambda привлек $1 миллиард в рамках нового раунда частного долга. Средства пойдут на закупку чипов Nvidia, которые...
Компания Modular открыла исходный код компилятора и инструментария языка Mojo, переведя их на лицензию Apache 2. Проект окончательно отошел от...
Разбор запуска локальных LLM на потребительском «железе»: обзор актуальных утилит, требования к видеокартам и оперативной памяти, а также реальные сценарии...
Инженеры Dharma AI опубликовали в блоге Hugging Face детальное описание аллокатора GPU, который на том же оборудовании и тех же...
ИИ-редактор кода Cursor официально вошёл в состав SpaceX. TechCrunch сообщает о закрытии сделки, в рамках которой у SpaceX была опция...
Стартап Kog, вышедший из скрытого режима в мае 2026 года, утверждает, что может кардинально ускорить инференс больших языковых моделей на...
Nvidia привлекла Apollo, BlackRock и KKR к финансированию ИИ-дата-центров на сумму до $500 млрд, пообещав покрывать до 25% потерь при...
TileLang — Python-фреймворк на основе TVM, упрощающий написание эффективных GPU-ядер для GEMM, Softmax и FlashAttention с автоматической оптимизацией под архитектуру.
Акции Nvidia падают на фоне роста цен на чипы памяти, поскольку производители памяти, такие как Micron, становятся новым "бутылочным горлышком"...