Tessary отслеживает сбои ИИ-агентов по всем production-трейсам
Открытый проект Tessary сочетает дешёвые классификаторы для первичного поиска проблем и отдельные агенты для анализа причин. Систему можно развернуть самостоятельно...
Тема COMRAD404
Открытый проект Tessary сочетает дешёвые классификаторы для первичного поиска проблем и отдельные агенты для анализа причин. Систему можно развернуть самостоятельно...
Сервис Velu оценивает страницы документации по 23 проверкам: от llms.txt и Markdown-версий до серверного рендеринга, HTTP-кодов и доступности без авторизации.
Джек Дэймон выложил в открытый доступ Lacuna — инструмент, который внедряет языковую модель в любое текстовое поле Mac через фигурные...
Liquid Inference описывает маркетплейс, где провайдеры конкурируют за запросы к моделям, а маршрутизатор подбирает вариант под заданный уровень качества и...
Авторы исследования внедрили небольшую дообученную модель для анализа уроков английского. По их оценке, она точнее отвечала на тестах, чем модели...
Исследователи проверили, как небольшие LLM-агенты работают с явным ограничением по времени, и выяснили, что соблюдать бюджет они могут, а вот...
Инструмент с открытым кодом Fakegreen анализирует изменения агентов в Git-дифе и находит типичные уловки: пропуск тестов, ослабление проверок, заглушки в...
На Cliphouse запущен тест, сравнивающий способность больших языковых моделей создавать код для анимированной графики. Бенчмарк проверяет стоимость, время и надёжность...
В GitHub-репозитории собраны AI-ассистенты для кода, терминальные агенты, архитектурные схемы и исследовательские работы. Это обзорная карта инструментов, а не сравнительный...
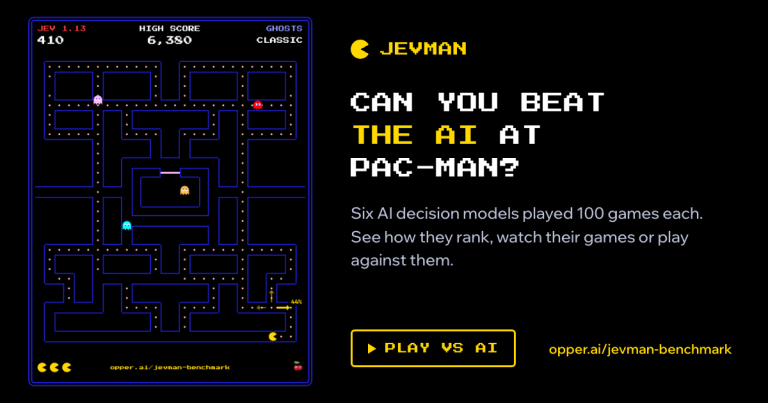
Opper.ai запустила Jevman — аркадный бенчмарк, где модели принятия решений соревнуются в Pac-Man. Шесть моделей сыграли по 100 игр, результаты...