

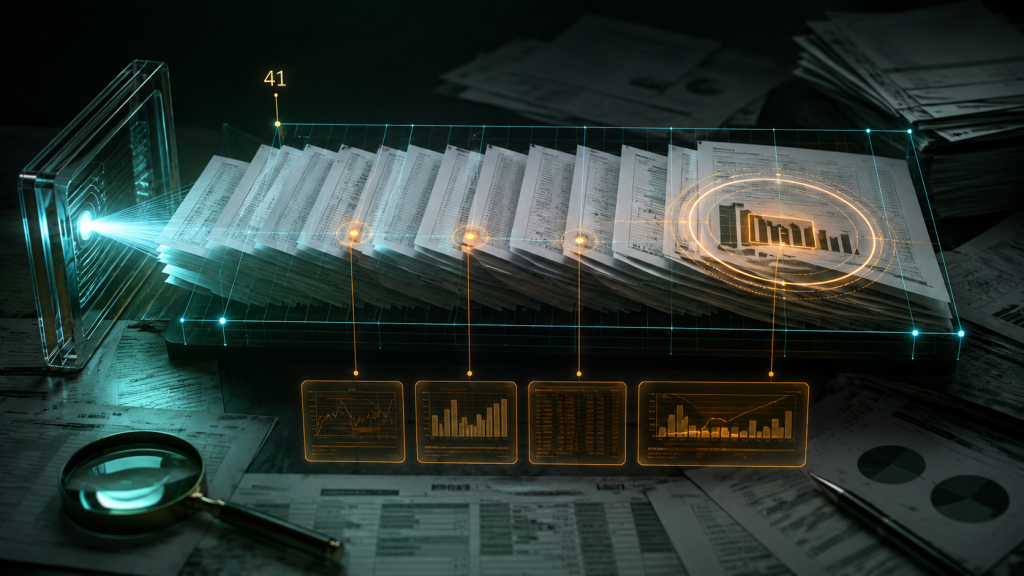
Платформа Legora прогнала GPT-6 Astra через реальную по форме, но контролируемую задачу: сверку финансовой отчётности по 41 документу. Агент завершил проход за несколько минут и нашёл все четыре заранее внесённые ошибки, включая расхождение на £500 000 в примечании о выручке. Самое важное здесь не скорость чтения, а способность сохранить связи между десятками документов и оставить специалисту журнал каждой проверки.
Кейс опубликован OpenAI совместно с клиентом, поэтому цифры нельзя считать независимым аудитом модели. Однако Legora сообщила не только сильный результат, но и показатель, который охлаждает хайп: в выбранном workflow прирост относительно предыдущей модели составил почти 40%, а в среднем по всем заданиям внутреннего бенчмарка BAR — около 3%.
Что произошло
Financial-statement tie-out — это построчная сверка черновой отчётности с оборотно-сальдовой ведомостью, консолидационным графиком и данными прошлого года. Человеку такая работа может занять вечер или несколько дней. Ошибка опасна не только величиной: она может прятаться в примечании, сноске или несогласованной версии таблицы.
Legora загрузила в один запуск агента 41 документ. Система сравнила балансы с подтверждающими графиками, отметила разрывы и сохранила запись по каждому пункту. В тестовые данные заранее внесли четыре ошибки. Astra нашла все четыре, сохранила проверки, которые предыдущая модель выполняла правильно, и, по данным компании, провела примерно на 50 проверок больше.
Почему это обсуждают
Юридические и финансовые задачи долго считались неудобными для агентов: цена пропущенной цифры высока, документы велики, а правильный ответ должен сопровождаться доказуемым маршрутом. Здесь модель не просто выдала резюме, а сформировала проверяемый первый проход. Специалист может открыть конкретное расхождение и решить, является ли оно ошибкой, допустимым округлением или особенностью раскрытия.
Такой формат меняет экономику внедрения. AI не обязан заменять профессиональное суждение, чтобы окупиться. Если система снимает механическое сопоставление строк, а человек тратит время на исключения, ценность появляется даже при обязательной финальной проверке. Для регулируемой отрасли это реалистичнее обещания полностью автономного «AI-юриста».
Одновременно разница между 40% в одном сценарии и 3% по всей батарее показывает, насколько опасно переносить локальный успех на продукт целиком. Модель может резко улучшить работу с длинной финансовой связностью и почти не изменить другие юридические операции.
Что подтверждено
- В одном запуске агент обработал 41 документ и, по данным Legora, завершил работу за минуты.
- Найдены четыре из четырёх заранее заложенных ошибок, включая разрыв на £500 000.
- В узком сценарии финансовой сверки Legora измерила почти 40% улучшения относительно предыдущей модели.
- Средний прирост по всем заданиям Legora Benchmark for Agentic Reasoning составил около 3%.
- Финальное решение сознательно оставлено юридическому или финансовому специалисту.
Утверждения относятся к системе Legora, где модель окружена интерфейсом, правилами и инструментами компании. Они не означают, что загрузка 41 файла в обычный чат даст тот же результат.
Что пока не ясно
Legora не опубликовала полный набор документов, точную методику BAR, промпты и логи всех прогонов. Не указаны число повторов, доля ложных тревог, стоимость сессии и время экспертной проверки ответа. Четыре намеренно внесённые ошибки — полезный контроль, но слишком малая выборка для оценки редких отказов.
До производственного использования нужны проверки на документах с плохим сканированием, конфликтующими версиями, нестандартными таблицами и неполными приложениями. Особенно важно измерять не только recall — сколько ошибок найдено, — но и precision: сколько отмеченных проблем окажутся настоящими. Десятки ложных тревог способны вернуть человеку всю сэкономленную работу.
Безопасная схема остаётся консервативной: доступ только к копиям, журнал источников для каждого числа, запрет на отправку и изменение документов, обязательное подтверждение специалиста и выборочная двойная проверка.
Где смотреть
Все приведённые показатели и видео находятся в официальном кейсе OpenAI и Legora. Возможности модели и ограничения API — в карточке GPT-6 Astra для разработчиков.
Для сравнения с другими ранними тестами откройте наш экспертный обзор Astra. Главный вывод для финансового отдела: пилотировать стоит конкретный процесс с известными ошибками и человеческой приёмкой, а не абстрактную «работу с документами».