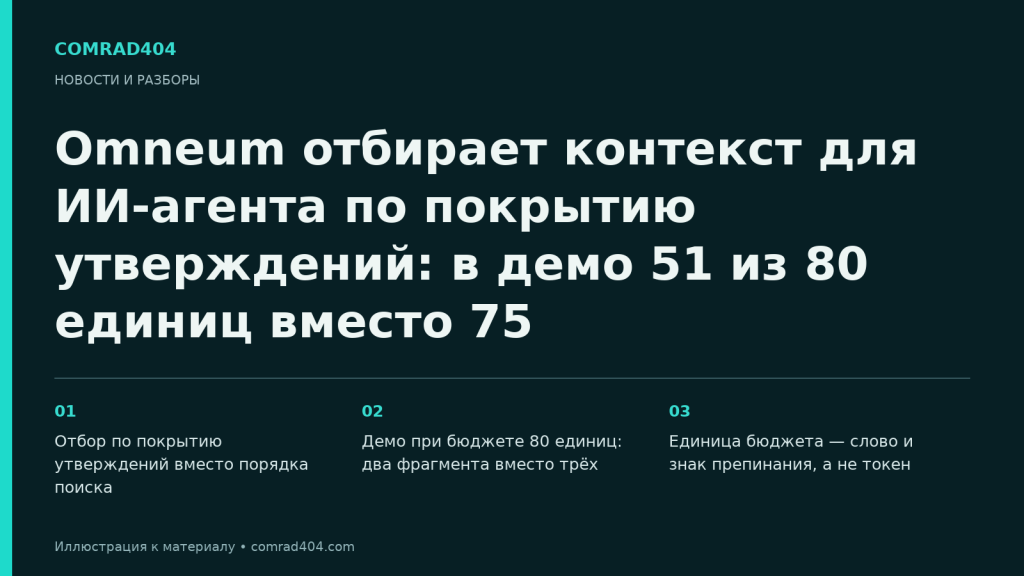
Проект Omneum на GitHub описывает локальный инструмент, который решает, какие найденные фрагменты попадут в контекст ИИ-агента. Отличие от обычной выдачи поиска в том, что отбор идёт не по порядку результатов, а по тому, сколько разных утверждений вопроса закрывает каждый фрагмент при заданном лимите. В примере из README такой отбор потребовал 51 единицу бюджета из 80 против 75 у упаковки в порядке поиска и закрыл четыре утверждения из четырёх вместо двух. Наводка на проект — пост в разделе Show HN на Hacker News, датированный 30 октября 2026 года; дата публикации README не указана, поэтому саму разработку по ней датировать нельзя.
Отбор по покрытию утверждений вместо порядка поиска
В README контекстная реконструкция описана как выбор исходных извлечённых пассажей сразу по двум условиям: релевантность вопросу и прирост покрытия утверждений в рамках бюджета контекста. Практический смысл в том, что модель получает не первые N найденных кусков, а набор, закрывающий больше разных утверждений при том же лимите.
Среди других заявленных возможностей — text-blind evaluation, то есть оценка по структурированным наблюдениям без чтения строк исходного текста и без вызова отдельного судьи на базе языковой модели. Рядом описан graph inference: итеративный расчёт надёжности источников и поддержки утверждений по двудольному графу с учётом общих первоисточников и зависимостей между источниками.
Демо при бюджете 80 единиц: два фрагмента вместо трёх
Пример в README задаёт пять извлечённых фрагментов, четыре различных утверждения и общий бюджет контекста 80 единиц, после чего сравнивает две упаковки при одном лимите: в порядке поиска (Raw RAG) и по покрытию утверждений (Omneum).
| Показатель | Raw RAG | Omneum |
|---|---|---|
| Сохранено фрагментов | 3 | 2 |
| Покрытие утверждений | 2 из 4 | 4 из 4 |
| Израсходовано бюджета | 75 из 80 | 51 из 80 |
Упаковка в порядке поиска заняла 75 единиц и закрыла два утверждения из четырёх; Omneum оставил два фрагмента, закрыл все четыре и израсходовал 51 единицу. README формулирует это как экономию 32% ёмкости контекста: 24 единицы из 75. Команда запуска примера указана в README — python -m examples.context_quality_demo.before_after после клонирования репозитория. Приведённые числа — вывод этого примера, а не независимое измерение.
Единица бюджета — слово и знак препинания, а не токен
Главная оговорка к цифрам — единица измерения. В списке возможностей README говорит о token budget, но сам демонстрационный пример, по указанию README, считает бюджет счётчиком слов и знаков препинания из SDK. Значит 51 из 80 — не токены конкретной модели и не оплаченный объём запроса: при другом токенизаторе те же два фрагмента дадут другое соотношение.
Остальные ограничения в одном месте: это один демонстрационный прогон, опубликованный вместе с проектом, а не независимая оценка. Он не измеряет качество итоговых ответов модели и не переносится автоматически на другие наборы данных, вопросы или структуры утверждений. Доступное описание даёт механизм отбора и числа одного примера — оснований говорить о массовом применении или универсальном улучшении качества ответов нет.