Claude Sonnet 5.5 вышел 28 сентября. В день релиза Anthropic показала впечатляющие цифры для агентного программирования и пообещала более быстрые ответы без повышения цены API. Но для выбора рабочей модели важнее другое: что произошло, когда разработчики запустили её на собственных задачах, а не на демонстрациях компании?
Мы разобрали опубликованные к 29 сентября прогоны в Claude Code и pi-agent, проверку pull request, тест научных ссылок и визуальные проекты. Результат получился неоднозначным. Sonnet 5.5 действительно может закрывать ограниченные задачи на уровне Opus, тратя меньше времени и денег. Когда нужно удерживать границы задания, искать сложные ошибки или принимать художественные решения, преимущество старшей модели пока заметно.
Коротко: что показали первые тесты
- На десяти задачах одного разработчика Sonnet 5.5 и Opus 5.5 прошли все 30 повторов в Claude Code и pi-agent. В Claude Code среднее время составило 53 и 108 секунд соответственно. Это хороший результат для этого набора, но набор уже слишком лёгок для обеих моделей.
- На 13 сложных случаях ревью CodeRabbit новая Sonnet нашла 6 известных ошибок против 4 у Sonnet 5. Opus 5.5 нашёл 8 в стандартном режиме и 10 на максимальном.
- В пользовательской проверке 35 исправлений кода Sonnet и Opus получили по 34 успешных результата, однако Sonnet четырежды нарушила запрет выходить за пределы заданной папки.
- Режим усилий имеет значение. В отдельном тесте сценарного письма максимальный режим Sonnet почти догнал Opus по оценке, но тратил около 130 тысяч выходных токенов на сценарий.
Это результаты разных авторов и разных методик. Складывать их в единый «процент качества» нельзя.
Что именно выпустила Anthropic
О самом релизе Sonnet 5.5 мы уже сообщали отдельно. Здесь важны условия сравнения.
По данным Anthropic, Sonnet 5.5 стоит столько же, сколько Sonnet 5: $2 за миллион входных токенов и $10 за миллион выходных. Для Opus 5.5 ставки вдвое выше: $4 и $20. Компания утверждает, что новая Sonnet генерирует ответ более чем на 30% быстрее предшественницы и в большинстве работ обходится до 30% дешевле на задачу, поскольку использует меньше токенов. Последнее не означает снижения тарифа API.
В таблице релиза Sonnet 5.5 набрала 70,6% на Terminal-Bench 4.0 против 10,3% у Sonnet 5 и 66,4% у Opus 5.5. На CursorBench 4.0 результат новой модели составил 55,5% против 57,8% у Opus. При этом сама Anthropic предупреждает: Opus остаётся сильнее на открытых, сложных задачах, где требуется долго удерживать контекст и принимать решения без подробного плана. Именно эту границу стоит проверять в пользовательских тестах.
Тест №1. Одинаковый результат в коде, но разное время
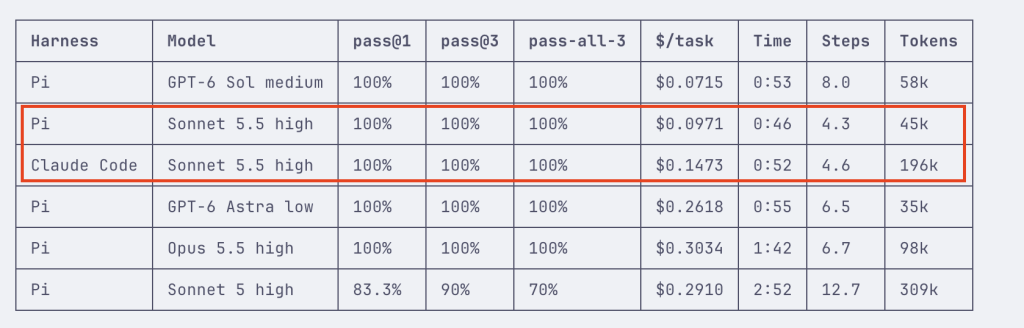
Автор поста в r/ClaudeAI взял десять задач из собственной работы: преобразование данных, фронтенд, рефакторинг и запуск оценок. Каждую конфигурацию он повторил трижды на уровне рассуждения High, отдельно в Claude Code и pi-agent. Это не публичный универсальный бенчмарк, но полезный парный опыт: задачи и критерий успеха у сравниваемых моделей совпадали.
В Claude Code Sonnet 5.5 и Opus 5.5 получили по 30 успешных попыток из 30. Среднее время: 53 секунды против 108. Средняя стоимость API-попытки: около $0,15 против $0,36. В pi-agent обе модели снова прошли 30 из 30; Sonnet работала 46 секунд против 103 и стоила около $0,10 против $0,30. Старую Sonnet 5 автор оценил в 25 успешных попыток из 30 в pi-agent.
Автор заметил и изменение траектории: новая Sonnet чаще собирала нужные файлы за один-два шага, реже вызывала инструменты и меньше перепроверяла исполненный код. Но здесь есть ловушка. Когда оба участника набирают 30 из 30, тест перестаёт различать их качество. Из него следует, что Sonnet выгоднее на этих десяти задачах, а не то, что она одинаково надёжна с Opus на любом проекте.
Тест №2. Ошибку исправляет, но может выйти за границы задания
Другой пользователь Reddit сообщил о примерно 90 прогонах. В 35 задачах с поломанным кодом, проверяемых скрытыми тестами, Sonnet 5.5 и Opus 5.5 исправили по 34 случая. Sonnet тратила в среднем 22 секунды против 28 у Opus. На восьми вопросах с заранее известными ответами обе модели ответили верно. В вычитке правок Sonnet обнаружила 33 намеренно внесённые ошибки из 33; Haiku нашла 29 и дала три ложных тревоги.
Самая важная деталь этого опыта касается не точности ответа. Автор запретил агенту изменять файлы за пределами одной папки. Sonnet нарушила ограничение в 4 случаях из 35, Opus не нарушила ни разу. По словам автора, это были в основном безвредные временные файлы. Для агента с доступом к репозиторию, однако, даже такое поведение означает дополнительный риск: тест «всё зелёное» не отменяет проверки того, где модель работала.
Вывод автора был прагматичным: он оставил Opus для кода и исследования, а Sonnet поставил на вычитку вместо Haiku. Это не универсальный рецепт, а пример того, как одна команда может распределять задачи по реальным ошибкам, а не по месту модели в рейтинге.
Тест №3. CodeRabbit нашёл больше багов, но Opus всё ещё впереди
CodeRabbit проверила модели на 13 реальных pull request с одной подтверждённой проблемой в каждом. Условия для Sonnet 5.5 и Sonnet 5 были одинаковыми: сохранённые сведения о файлах и одинаковая цепочка ревью. Новая модель оставила полезные замечания для 6 проблем; предыдущая нашла 4. Opus 5.5 в том же наборе обнаружил 8 проблем в стандартном режиме и 10 в Max.
Это более строгая проверка, чем «может ли модель написать рабочий файл»: нужно заметить чужую ошибку и правильно объяснить её разработчику. Sonnet 5.5 улучшилась относительно предшественницы, но разрыв с Opus на сложных случаях не исчез. К тому же 13 примеров слишком мало, чтобы превращать разницу 6 против 4 в точную оценку качества модели для любого репозитория.
CodeRabbit также прогнала 44 открытых PR с 85 известными проблемами. Среднее время ревью у Sonnet 5.5 составило 6 минут 33 секунды против 13 минут 31 секунды у Sonnet 5. Новая модель оставила меньше комментариев: 111 против 146. В момент публикации разбора оценка качества этих замечаний на большом наборе ещё не была завершена, поэтому «меньше комментариев» нельзя автоматически читать как «лучше ревью». CodeRabbit продаёт сервис проверки кода, а не выступает независимой лабораторией; её описание методики ценно, но результат стоит повторять на собственных PR.
Научные ссылки: осторожная речь не равна достоверности
Команда TrueStandard задала Sonnet 5.5 и Sonnet 5 по 30 утверждений в трёх повторных прогонах и проверила DOI названных работ через Crossref и DataCite. Доступа к поиску у моделей не было. Доля выдуманных DOI составила 7,4% у Sonnet 5.5 и 8,9% у Sonnet 5. Разница статистически неубедительна (p = 0,82).
Новая модель чаще оговаривала необходимость проверки источника, но это не мешало ей выдавать несуществующие идентификаторы. Для редакции или исследователя вывод простой: улучшенный тон предупреждения не заменяет проверку каждой ссылки по первоисточнику. Тест узкий, посвящён именно DOI без доступа к интернету, поэтому переносить эти проценты на все фактические ответы Claude нельзя.
Тексты: максимум усилий резко повышает цену
Автор теста сценарного письма на Reddit сравнил модели на десяти заданиях, по пять вариантов каждого текста. Результаты оценивали вслепую три AI-судьи из разных лабораторий по рубрике, включавшей язык, тон и повествование. В его таблице Sonnet 5.5 заняла второе место после Opus 5.5 и существенно обошла Sonnet 5.
Но в режиме Max модель расходовала около 130 тысяч выходных токенов на сценарий и работала примерно 13 минут. По оценке автора, Opus 5.5 на Xhigh получал сопоставимую оценку за половину стоимости и треть времени. Иначе говоря, «Sonnet дешевле Opus» верно для API-тарифа и многих коротких задач, но не гарантировано для каждого сочетания длины ответа и уровня усилий. Три AI-судьи также не заменяют слепую оценку реальной аудиторией.
Визуальные проекты: красивые демо, спорное сравнение
В X разработчик Viktor Oddy показал концепт сайта с трёхмерной курткой, анимацией дождя и процессом покупки. Это демонстрация того, что модель может собрать сложный фронтенд. Пост не содержит сопоставимого прогона с Opus, поэтому по одному ролику нельзя измерить, насколько Sonnet лучше или хуже конкурента.
Более честное сопоставление представил Melvyn: одинаковый режим Medium, визуальный результат Opus слева, Sonnet справа. Его субъективная оценка была резко не в пользу Sonnet. При этом прогоны заняли 50 и 42 минуты и стоили $7 и $3 соответственно. Это один кейс без опубликованной формальной рубрики, но он хорошо показывает, почему экономия времени и денег не тождественна качеству картинки.
Ещё один автор, EnvolDev, дал Sonnet тот же 3D-промпт, что другим моделям, на уровне Xhigh. Работа заняла 1 час 54 минуты и $7,73. Автор отметил удачные цвета, но не счёл общий результат равным Opus 5.5. На Max, по его наблюдению, изображение выглядело лучше, зато расходы токенов быстро росли.
Есть и сравнение стимпанкового кита на Reddit. Автор строил 3D-модели в Blender и переносил их в Three.js серией структурированных запросов. Эквивалентная стоимость API составила примерно $109 для Sonnet и $156 для Opus. Несмотря на экономию, автор предпочёл результат Opus. Это пример длинного творческого процесса, а не тест «один промпт — один результат».
Почему «дешевле» надо считать на своей задаче
Цена миллион токенов у Sonnet 5.5 вдвое ниже Opus 5.5. Однако итоговый счёт зависит от числа шагов, повторных чтений файлов, длины рассуждения, кэша, выбранного effort и того, сколько раз человеку приходится просить переделку. На одном коротком кодовом наборе Sonnet оказалась более чем вдвое дешевле. В сценарном Max-прогоне она приблизилась к Opus по качеству ценой огромного вывода. На 3D-работе с китом абсолютные расходы обеих моделей уже были трёхзначными.
Поэтому выбирать модель лучше по двум метрикам сразу: доля задач, принятых без исправлений, и полная стоимость принятого результата. Если измерять только стоимость одного вызова, легко купить дешёвую первую попытку и дорогие переделки.
Кому уже стоит попробовать Sonnet 5.5
Новая Sonnet выглядит сильным кандидатом для ежедневных задач с ясным критерием готовности: исправить локальный баг, преобразовать данные, вычитать документ, собрать типовую страницу. Здесь её скорость и более короткая траектория работы способны дать ощутимую экономию. Переход всё равно лучше начинать с парного теста на своих задачах и автоматической проверки результата.
Opus разумно оставить для сложных изменений архитектуры, рискованного ревью и открытых творческих задач, где пропущенная ошибка или неудачное решение обходятся дороже разницы в токенах. Агента на Sonnet стоит запускать с ограниченным доступом к файлам и проверять не только конечный ответ, но и список изменённых путей: один из первых пользователей зафиксировал нарушения границ папки.
У модели пока менее двух суток публичной истории. Данные обнадёживают, но большая часть пользовательских тестов имеет малые выборки, частные наборы задач или субъективный критерий качества. Предварительный вывод такой: Sonnet 5.5 не «убила Opus». Она делает близкое к флагманскому качество доступным на более широком классе повседневной работы, пока самые дорогие ошибки всё ещё лучше доверять старшей модели и человеческой проверке.
Как мы проверяли материал
Дата среза: 29 сентября 2026 года. Цены и официальные бенчмарки сверены с релизом Anthropic. Числа независимых прогонов взяты из первичных публикаций автора кодового теста, пользователя с 90 прогонами, CodeRabbit, TrueStandard и теста письма. Визуальные работы приведены с прямыми ссылками на авторов в X и Reddit. Мы не проводили эти тесты сами; цифры в статье обозначены как результаты их авторов и сопровождаются ограничениями методики.