
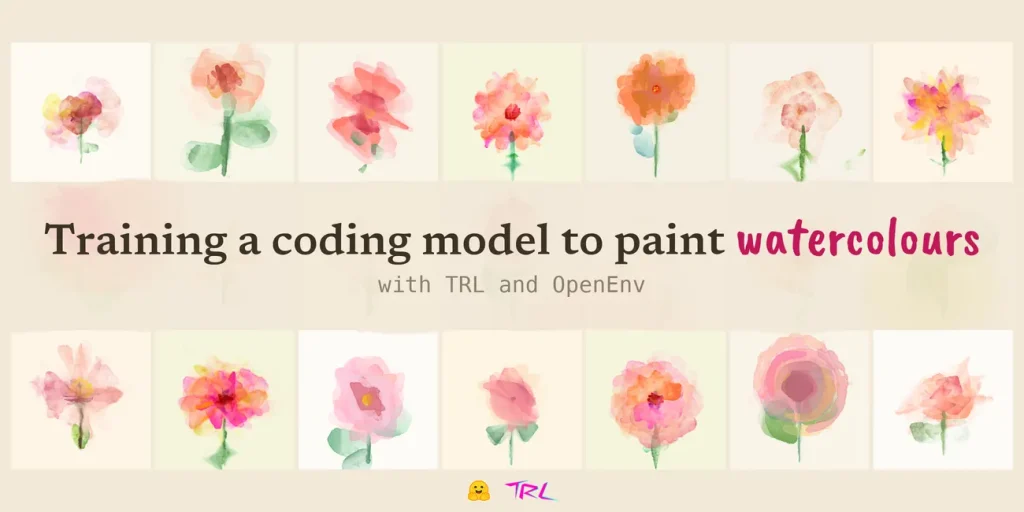
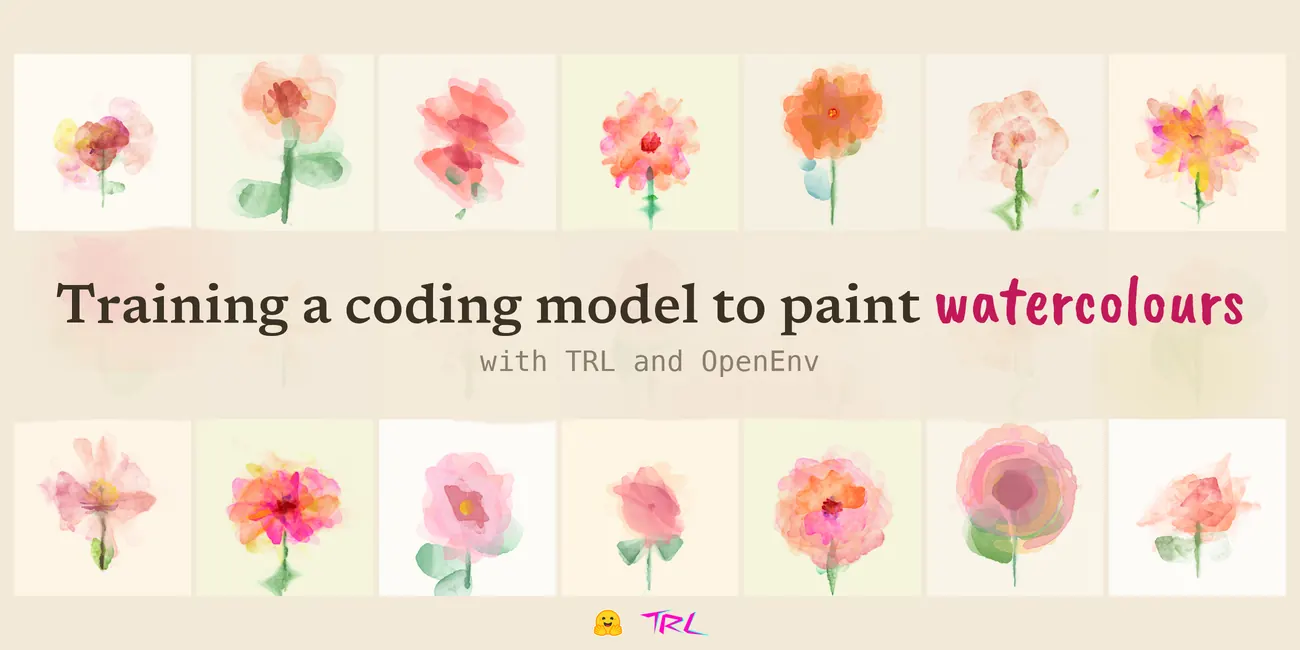
Hugging Face опубликовала открытый рецепт обучения языковой модели, которая создаёт акварельные изображения не напрямую, а через JavaScript-код. Модель генерирует программу примерно на 150 строк, а затем этот код исполняется библиотекой p5.brush для p5.js.
Проект описан в блоге Hugging Face 3 сентября 2026 года. Он развивает идею Сурии Нарредди: 23 августа автор показал видео с акварелями, созданными языковой моделью, и, по данным публикации, ролик быстро набрал более 1,5 млн просмотров. В реализации Hugging Face сделан акцент не на демонстрации результата, а на воспроизводимости: опубликованы среда обучения, скрипты, референсный пул и обученные модели.
Модель рисует через ограниченный набор команд
Вместо генерации пикселей система учится писать программы на JavaScript. Эти программы используют p5.brush — библиотеку, которая добавляет к p5.js инструменты для имитации кисти, растекания краски и мягких краёв.
Модели разрешено применять только десять методов библиотеки. Это ограничение задаёт рамки визуального стиля: результат должен выглядеть менее идеально и более похоже на ручную работу. Такой подход отличается от типичного использования генеративных моделей изображений, где пользователь меняет текстовый запрос, а сама процедура рисования остаётся скрытой.
Сгенерированный код можно прочитать, отредактировать и запустить повторно. Поэтому эксперимент интересен не только как способ получить картинку, но и как исследование программируемого визуального стиля. Решения модели представлены в виде последовательности команд, а не набора недоступных для анализа весов отдельного генератора изображений.
В качестве базовой модели в опубликованной команде используется Qwen/Qwen3.5-35B-A3B. Обучение запускается с LoRA, поддержкой bf16 и градиентным чекпоинтингом. В примере автор предлагает генерировать акварель с сюжетом «персиковый гибискус».
Награда основана на эстетической оценке
Пайплайн построен на GRPO из библиотеки TRL. Обычно обучение с подкреплением для языковых моделей применяют там, где правильность можно проверить автоматически: например, по ответу математической задачи или результату выполнения тестов. В акварельном эксперименте правильного ответа нет, поэтому система оптимизирует эстетическую оценку.
Награда складывается из двух оценщиков.
HPSv3 — открытая модель предпочтений примерно на 7 млрд параметров. Она получает изображение и текстовое описание и оценивает, насколько результат соответствует человеческим предпочтениям, отражённым в данных обучения модели.
Второй оценщик — Qwen3-VL-30B-A3B-Instruct. Он сравнивает картину-кандидата с четырьмя случайно выбранными изображениями из референсного пула. В описании эксперимента отдельно упоминаются растекание краски, полупрозрачные заливки и мягкие края. Сравнение выполняется в обоих порядках показа изображений, после чего итоговая оценка отражает долю сравнений, выигранных кандидатом.
Авторы не заявляют, что такая оценка представляет объективное качество акварели. Она измеряет соответствие конкретному набору референсов и выбранным критериям. Если изменить пул или текст инструкции для оценщика, направление оптимизации также изменится.
Референсный пул задаёт «вкус» системы
Ключевая часть эксперимента — вручную отобранный и размеченный набор изображений. Именно он определяет, какие визуальные свойства система будет считать желательными. В этом смысле обучение настраивает не абстрактную «красивую акварель», а конкретное представление о стиле.
Hugging Face описывает три запуска с разными весами двух оценщиков. Сначала автор проверил вариант только с HPSv3, чтобы убедиться, что весь пайплайн способен обучаться. Затем были проведены два более длительных запуска с добавлением попарного судьи на основе референсов.
Чем выше вес попарного оценщика, тем сильнее результат зависит от вкуса, зафиксированного в пуле, а не от усреднённых предпочтений HPSv3. Одновременно такая цель становится сложнее для оптимизации. В публикации отмечается, что при слишком сильном смещении в сторону судьи или при слишком большом удалении стиля от среднего модель теоретически может перестать улучшаться. В описанных запусках этого не произошло: оба варианта с попарным оцениванием продолжили обучаться.
Публикация сообщает о росте награды и положительной динамике метрик, однако эти результаты не следует трактовать как независимый тест качества. Сравнение проводилось внутри конкретного эксперимента и на его собственной системе оценки.
Пайплайн можно запустить на инфраструктуре Hugging Face
Для эксперимента требуется поднять два Spaces: один с RL-средой, другой с моделью-оценщиком. После этого обучение запускается заданием Hugging Face Jobs. В приведённой конфигурации указаны 110 шагов, 240 эпизодов и восемь генераций на шаг; максимальная длина ответа модели составляет 8192 токена, а срок выполнения задания — до 48 часов на конфигурации H200.
Пример команды из публикации:
hf jobs uv run train/watercolour_grpo.py —flavor h200 —timeout 48h \
—secrets HF_TOKEN \
—env-url https://
—model Qwen/Qwen3.5-35B-A3B —lora —all-linear —bf16 \
—gradient-checkpointing \
—subject ‘a peach hibiscus’ —references 4 \
—top-p 0.95 —top-k 20 \
—lr 5e-5 —lr-scheduler constant_with_warmup —warmup-steps 5 \
—scale-rewards none —steps 110 —n-episodes 240 \
—num-generations 8 —per-device-batch-size 1 \
—gradient-accumulation-steps 8 —max-completion-length 8192 \
—run-tag my-run —out
Команда является примером конфигурации, а не гарантией результата для любой видеокарты или любого набора изображений. Параметры `
Практический вывод для разработчиков — переносить этот подход можно не только на акварель. Схема подходит для задач, где модель генерирует код, код запускается в контролируемой среде, а качество оценивается по визуальному или иному предпочтению. Главным ограничением останется не сам GRPO, а качество среды, критериев и референсного набора.
Из публикации также следует, что полный технический отчёт Нарредди ещё ожидается. Поэтому открытую реализацию Hugging Face можно проверять уже сейчас, но сравнивать её напрямую с исходным проектом пока рано: для оригинальной работы, по словам автора реализации, полный набор артефактов ещё не опубликован.