Авторы препринта, датированного 14 октября и появившегося в ленте arXiv 16 октября 2026 года, представили RealtimeBench — набор из 180 задач в шести типах игр. Он показывает, как меняется результат ИИ-агентов, когда игра продолжается во время обдумывания ответа, а не ждёт модель.
RealtimeBench проверяет игровых ИИ-агентов на ходу
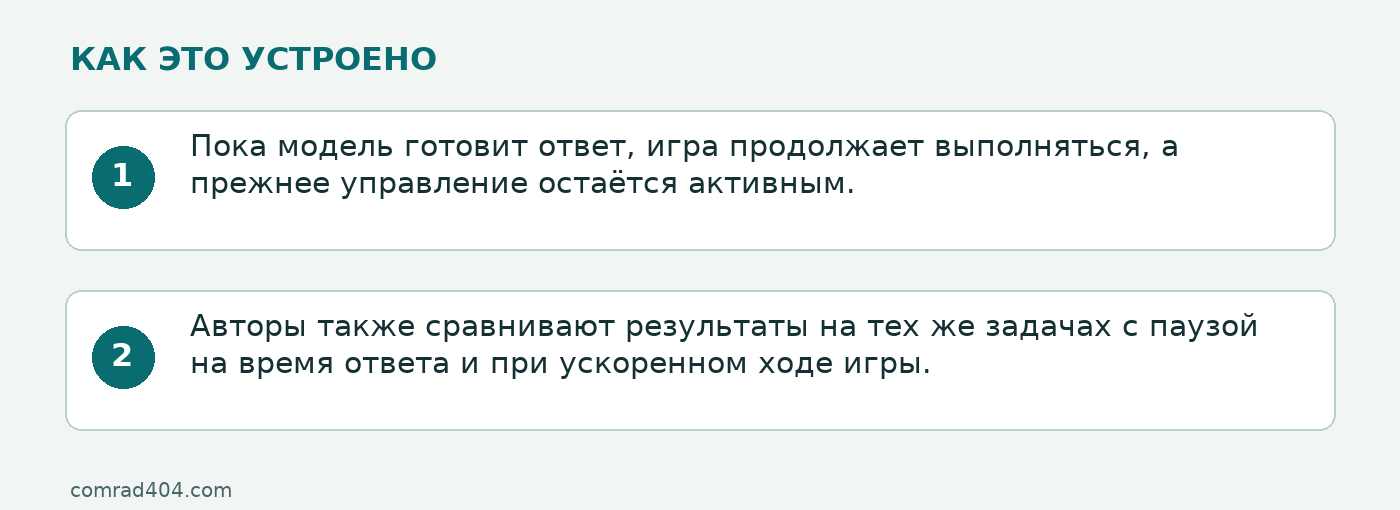
В испытаниях, включающих Mario, Snake и Tetris, агент получает текстовое описание текущего состояния и выбирает допустимое действие. Пока модель готовит ответ, игра продолжает выполняться, а прежнее управление остаётся активным. Авторы также сравнивают результаты на тех же задачах с паузой на время ответа и при ускоренном ходе игры. Описание RealtimeBench на arXiv.
Почему пауза меняет сравнение
Если игра стоит, у медленной модели есть больше времени рассуждать, не теряя игрового состояния. В испытаниях авторов GPT-6.1-sol отвечала примерно за 19 секунд и при паузе превосходила более быструю Jev в пяти из шести типов игр. Когда игра продолжалась во время ожидания, средние результаты составили 1,51 у GPT-6.1-sol и 13,51 у Jev.
Сравнение показывает, что результат при остановленной игре не обязательно сохраняется, когда действия нужно принимать на ходу. Оно относится к моделям, задачам и протоколу этого исследования, а не устанавливает универсальный рейтинг игровых агентов.
TORSI обучает быстрого агента между попытками
Авторы предложили TORSI, чтобы улучшать быстрого агента, не вызывая медленного учителя во время игры. Учитель разбирает ошибки и проверяет возможные исправления в паузах между попытками, затем передаёт ученику инструкции для следующих эпизодов. Обновления сохраняют, если они повышают результат на проверке.
После двух раундов обучения средний тестовый результат Jev вырос с 13,51 до 24,19 по шкале прогресса от 0 до 100; авторы сообщили об улучшении во всех шести типах игр. По их словам, инструкции также повысили средние результаты ещё трёх моделей без дополнительной перенастройки.
Что ограничивает выводы
RealtimeBench измеряет прогресс на созданных авторами 180 задачах в шести типах игр. Результаты представлены в препринте и не являются независимой проверкой: их нельзя считать гарантией такого же эффекта в других играх или для всех игровых ИИ-агентов.