PHiT обучает промежуточные состояния thought-токенов на семантических целях, построенных из историй взаимодействий с товарами. Ниже — последовательность метода, описанная авторами препринта, и граница между этой схемой и инструкцией для запуска: имеющихся подтверждённых сведений недостаточно, чтобы указать команды, точную агрегацию кодировок или параметры обучения.
Источник метода — версия 1 препринта arXiv от 6 ноября 2026 года. Оригинальная статья PHiT на arXiv.
Что нужно для реализации
В методе используются истории взаимодействий с товарами, закэшированные разреженные кодировки товаров и отдельные thought-токены из словаря модели. Авторы агрегируют кодировки истории, чтобы построить семантические цели, а затем обучают контекстные состояния токенов по этим целям.
Это перечисление компонентов метода, а не спецификация входных файлов. До запуска нужно извлечь из полного текста статьи и приложений совместимые определения кодировок, процедуру агрегации, настройки обучения и протокол оценки. Не подменяйте недостающие детали самостоятельно выбранными значениями и не считайте такую реализацию точным воспроизведением эксперимента.
Шаг 1. Подготовьте цели из истории товаров
-
Подготовьте истории взаимодействий, которые будут входом рекомендательной модели.
-
Получите и закэшируйте разреженные кодировки соответствующих товаров в соответствии с реализацией из статьи.
-
Свяжите кодировки с историями и агрегируйте их по опубликованной процедуре, чтобы получить семантические цели для обучения.
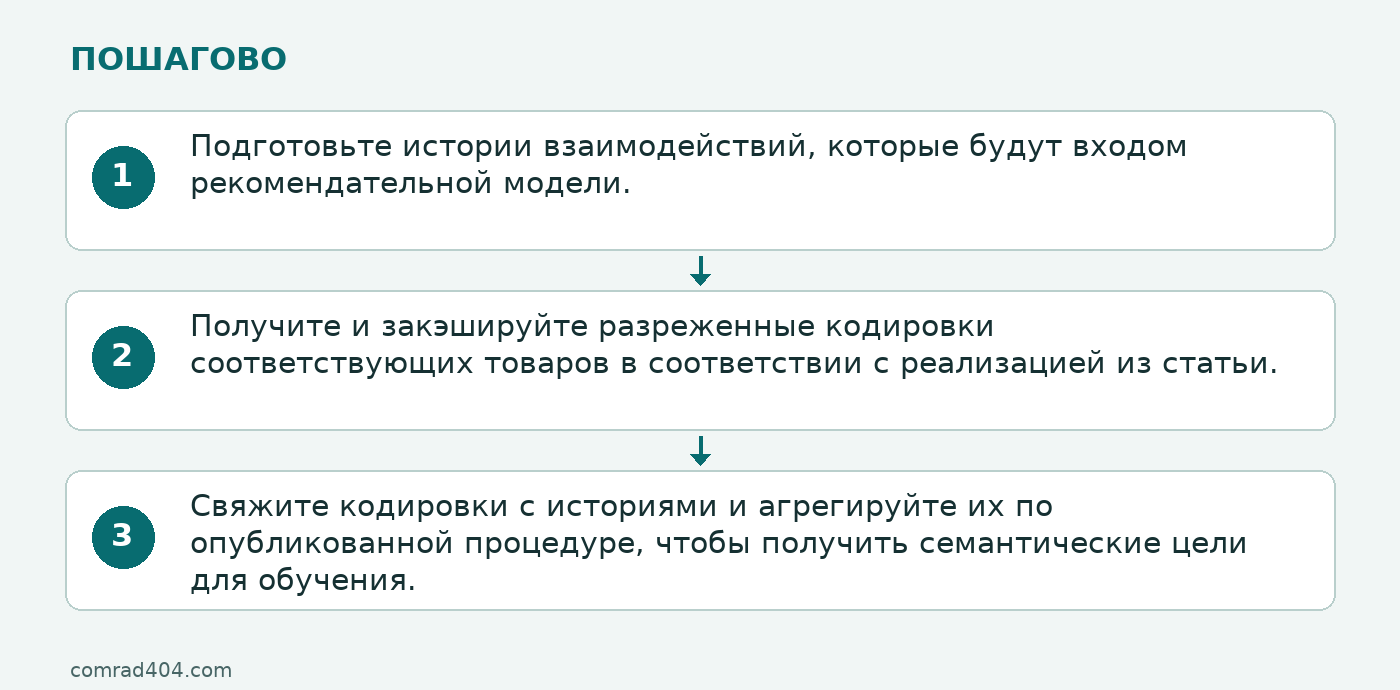
Ожидаемый результат этого этапа — цели, извлечённые из наблюдавшихся историй товаров. В отличие от обучения на учительских цепочках рассуждений, описанный источник супервизии — не сгенерированные отдельной моделью CoT-трассы.
Подтверждённое описание метода не задаёт точную формулу агрегирования, формат кэша или команды подготовки данных. Поэтому эти шаги нельзя превратить в исполняемый скрипт без обращения к конкретным параметрам и процедурам статьи.
Шаг 2. Обучите контекстные состояния thought-токенов
-
Используйте отдельные токены словаря, предназначенные для промежуточных thought-состояний.
-
Свяжите примеры историй с построенными для них семантическими целями.
-
Обучайте контекстные состояния thought-токенов по этим целям согласно настройкам метода.
Важно не смешивать входные токены с целью обучения: авторы описывают супервизию контекстных состояний токенов. Из имеющихся сведений нельзя восстановить точную функцию потерь, способ выбора токенов или гиперпараметры. До реализации найдите их в полном описании эксперимента и приложениях; не заменяйте пробелы догадками.
Шаг 3. Подайте thought-токены одним prefill
-
Сформируйте вход для предсказания следующего товара с историей и предусмотренными методом thought-токенами.
-
Передайте все thought-токены вместе как обычные входные ID в одном causal prefill.
-
Используйте модель для предсказания следующего товара и оценивайте его по выбранному протоколу.
Авторы описывают совместную подачу токенов в одном prefill; метод не требует рекуррентной передачи финального скрытого состояния от одного шага к следующему. Точный формат последовательности и параметры предсказания в доступном подтверждённом описании не указаны.
Что означает сообщение о четырёх бенчмарках
Авторы сообщают, что при supervised fine-tuning без дополнительного обучения PHiT превзошёл сравниваемые базовые модели на четырёх бенчмарках рекомендаций. Это результат, заявленный в препринте. Подтверждённые здесь сведения не содержат названий наборов данных, чисел таблицы или величины выигрыша, поэтому приводить их нельзя. Для сопоставления результатов нужны сами таблицы статьи и опубликованный протокол оценки.
Независимая проверка и журнал собственного запуска в материалах отсутствуют. Заявленный авторами результат сам по себе не гарантирует таких же показателей на других данных, модели или конфигурации.
Характерная ошибка: добавить рекуррентную передачу состояний
Если реализация передаёт финальное скрытое состояние от одного thought-шага к следующему, она расходится с описанным авторами вычислительным интерфейсом. Сверьте порядок входных токенов с методом: все thought-токены должны подаваться вместе в одном causal prefill. Если же реализация генерирует для обучения учительские CoT-трассы, проверьте источник целей: в PHiT они строятся из агрегированных кодировок наблюдавшихся историй товаров.
Исправление этой ошибки не подтверждает точность всего эксперимента: отдельно нужны точные настройки данных, обучения и оценки. Без них можно описать общий механизм PHiT, но нельзя заявлять о воспроизведённом результате.
Граница инструкции
Препринт подтверждает основные этапы метода: цели из историй товаров, обучение контекстных состояний thought-токенов и совместную подачу токенов в одном prefill. Однако изложение этих этапов не заменяет спецификацию запуска. Самостоятельный запуск не проводился; для практического воспроизведения используйте согласованные параметры из полного текста статьи и приложений.