Dory 1.0 4B описана в tutorial как модель с общим блоком средних слоёв, который применяется от одного до четырёх раз на токен. По утверждению автора, дополнительные проходы увеличивают вычисления на токен, не добавляя параметров. Это описание автора, а не результат независимого теста. Tutorial MarkTechPost о запуске Dory через llama.cpp.
Что известно о модели и процедуре
Автор tutorial сообщает, что использует ветку llama.cpp, закреплённую в model card NVIDIA, и GGUF-файл размером 3,7 ГБ. В доступном тексте нет точного коммита, ссылки на GGUF и команд сборки и запуска. Поэтому по имеющимся данным нельзя дать исполняемую последовательность команд, не подставляя неподтверждённые значения.
Практический вывод для подготовки: до сборки нужны точная ссылка на репозиторий и ref, указанный NVIDIA, URL конкретного GGUF и инструкции выбранного backend. Сам tutorial упоминает CPU, CUDA и Metal, но приведённые сведения не устанавливают, какая конфигурация подойдёт конкретной машине.
Как подготовить совместимое окружение
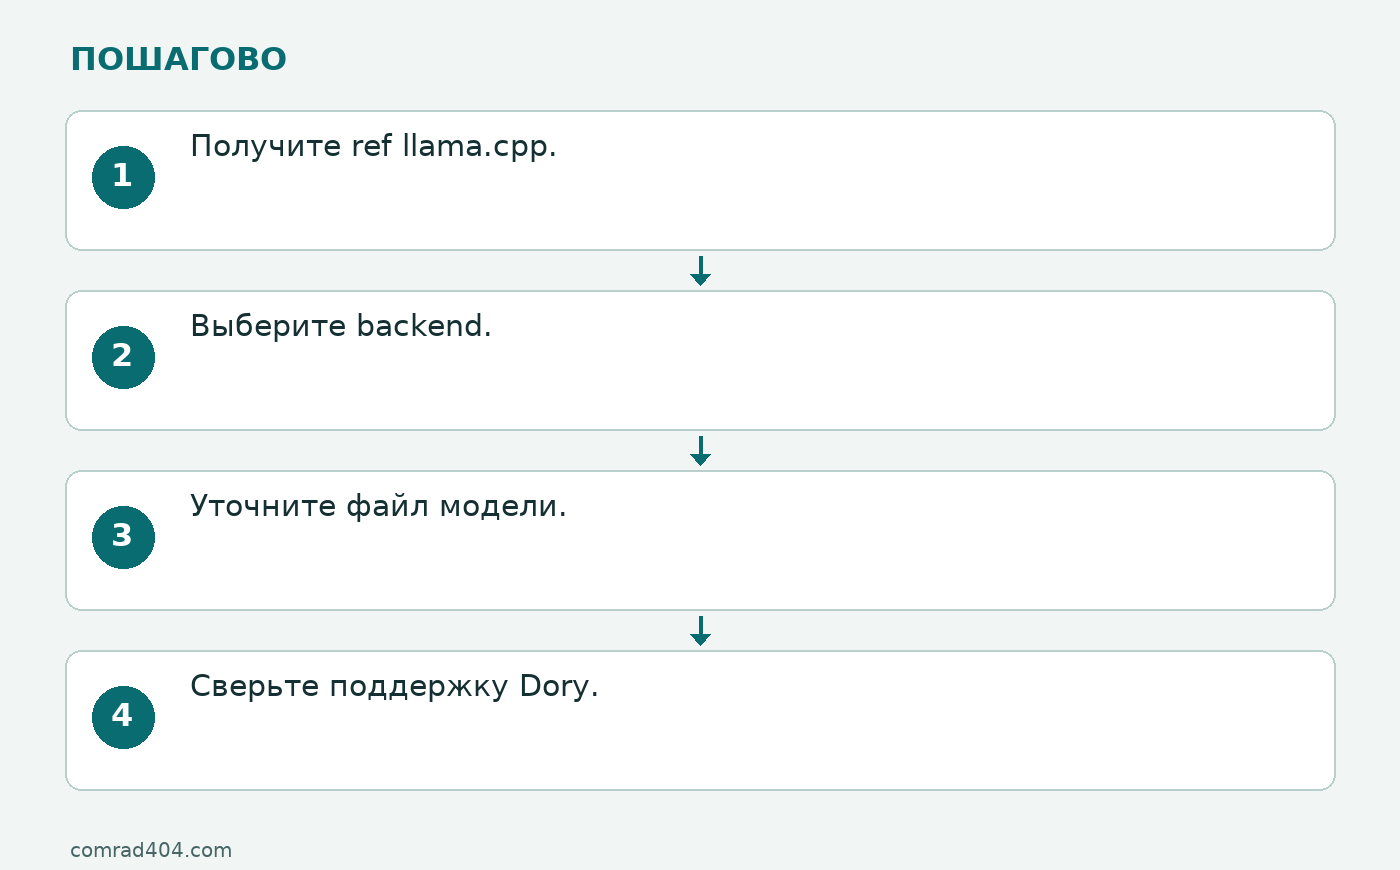
Используйте этот порядок как перечень необходимых исходных данных, а не как готовые команды: их точные значения в доступном материале отсутствуют.
- Получите ref llama.cpp. Возьмите ветку или коммит из model card Dory; не подменяйте его произвольной актуальной версией.
- Выберите backend. Определите, нужна ли сборка для CPU, CUDA или Metal, и найдите соответствующие параметры именно для закреплённого ref.
- Уточните файл модели. Получите точный URL GGUF и требования к нему из model card. Tutorial называет размер 3,7 ГБ, но доступные сведения не содержат контрольной суммы или имени файла.
- Сверьте поддержку Dory. Убедитесь по документации закреплённой версии, что она распознаёт архитектуру модели и предоставляет настройку loop.
Без этих значений нельзя надёжно составить команды clone, сборки, скачивания или запуска. Подстановка вымышленных флагов особенно рискованна для экспериментальной ветки: ошибка «неизвестный параметр» может означать несовместимый бинарник, а не неисправность GGUF.
Как спланировать сравнение loop 1–4
В tutorial описаны четыре значения loop — 1, 2, 3 и 4. Для содержательного сравнения меняйте только это значение, сохраняя одинаковыми запросы, настройки генерации и backend. Точный параметр командной строки в доступном фрагменте не приведён, поэтому его следует брать из документации именно закреплённой версии, а не угадывать.
- Для каждого значения loop сохраните использованный запрос и полный ответ.
- Запишите скорость декодирования и потребление памяти, а также настройки кэширования.
- Если сравниваете качество, используйте один и тот же набор задач для всех четырёх режимов.
- Сохраняйте конфигурацию каждой серии, чтобы отличать эффект loop от различий окружения.
Автор tutorial говорит, что измеряет скорость декодирования при каждом значении loop, проверяет влияние более дешёвого кэша последнего прохода и проводит парную оценку GSM8K по точности, длине ответа и времени на решённый вопрос. Численные результаты в доступном тексте не приведены; это описание заявленной процедуры, а не готовые показатели модели и не тест редакции.
Что считать результатом и как разбирать ошибку
Полезный итог сравнения — четыре записи, в которых указаны loop count, версия сборки, backend, параметры генерации, ответы и измеренные на конкретной машине скорость и память. Эти наблюдения характеризуют только выполненную конфигурацию; они не устанавливают универсальную скорость или требования Dory.
- Параметр loop не распознаётся. Сверьте ref и документацию запущенного бинарника с model card. Не переносите флаг из другой версии llama.cpp.
- Архитектура GGUF не поддерживается. Сначала проверьте, что используется требуемая ветка; доступные сведения не содержат точных команд или диагностических сообщений, позволяющих установить причину иначе.
- Серии дают несопоставимые результаты. Повторите сравнение с одинаковыми запросами и настройками, меняя только loop count; отдельно фиксируйте режим кэша.
Границы доступной инструкции
Источник описывает план сборки закреплённой ветки, загрузки GGUF и оценки четырёх режимов, но предоставленные данные не позволяют восстановить точные команды, ref, URL модели или флаг loop. Поэтому здесь нет готового исполняемого рецепта и нельзя утверждать, что сборка либо запуск прошли успешно. До получения этих значений практическая часть ограничивается подготовкой параметров и планом сопоставимого измерения.
Редакционного локального запуска и журнала измерений нет. Независимые результаты скорости, памяти и GSM8K в доступных данных также отсутствуют.