Как мигрировать с OpenAI API на Anthropic API
Пошаговая инструкция по миграции с OpenAI API на Anthropic API: сначала быстрый smoke-тест через OpenAI SDK compatibility, затем переход на...
Пошаговые инструкции по работе с нейросетями и ИИ-инструментами: установка, настройка, подключение моделей и автоматизация задач.
Пошаговая инструкция по миграции с OpenAI API на Anthropic API: сначала быстрый smoke-тест через OpenAI SDK compatibility, затем переход на...
Официального one-click импорта между ChatGPT и Claude в проверенных источниках нет. Рабочий путь — экспортировать данные ChatGPT, вручную извлечь инструкции...
Пошаговая инструкция по настройке fallback при сбое API: как поставить retries перед fallback, исключить unsafe HTTP-методы из автоповторов, включить telemetry...
Пошаговый план для продакшена: включить tracing, логировать request ID и safety_identifier, сравнивать когорты по latency/error/cost, считать faithfulness и hallucination и...
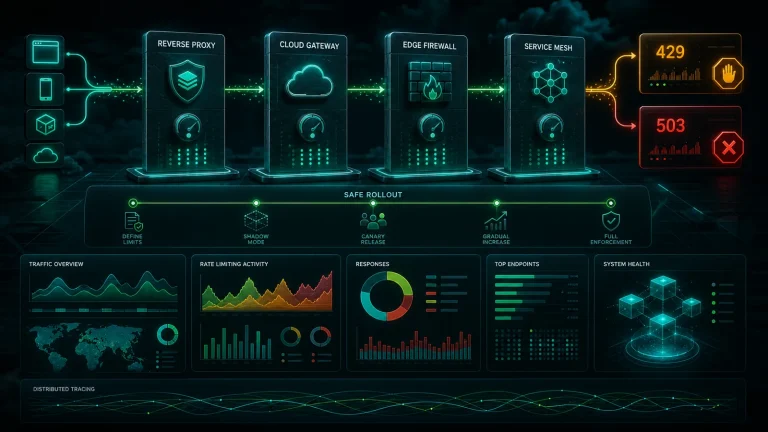
Пошаговая инструкция по настройке rate limiting для API в NGINX, AWS API Gateway, Cloudflare и Envoy: как выбрать точку ограничения,...
Пошаговая инструкция по анонимизации текста и документов перед отправкой в AI: когда выбирать локальный Presidio, а когда Azure, Google или...
Пошаговая инструкция, как проверить модель на bias: определить тип вреда, сравнить overall и by_group, учесть пересечения групп, задать порог и...
Пошаговая инструкция, как собрать воспроизводимую оценку качества генерации: выбрать OpenAI Evals, Promptfoo или LM Evaluation Harness, задать кейсы, проверки, пороги...
Пошаговая инструкция по red teaming модели или LLM-приложения: как задать цель, собрать команду, провести ручные тесты, проверить ASR и повторить...
Пошаговая инструкция по базовой настройке guardrails для AI-приложения на NVIDIA NeMo Guardrails: установка, input/output rails, проверка через check() и роль...
Пошаговая инструкция: как запустить локальный HTTP inference-сервер через Replicate Cog, проверить его через /health-check и /predictions и при необходимости создать...
Пошаговая инструкция по Jan.ai Desktop: установка на macOS, Windows или Linux, загрузка локальной модели через Hub, выбор совместимого варианта и...
Пошагово разбираем три официальных пути запуска модели на CPU без GPU: PyTorch + Transformers, llama.cpp и Ollama, с проверкой, что...
Пошаговая инструкция по настройке Text Generation WebUI: какой официальный способ установки выбрать, куда положить GGUF, как запустить локальный интерфейс на...
Инструкция по локальному развёртыванию vLLM для быстрого inference: установка через uv, запуск OpenAI-совместимого сервера, проверка /v1/models и /metrics, типовые ошибки...
Пошагово разбираем три официальных маршрута квантования модели: GGUF через llama.cpp, GPTQ/GGUF через GPTQModel и AWQ через AutoAWQ, плюс обязательную проверку...
Пошагово разбираем, как собрать или установить llama.cpp, подготовить GGUF-модель, запустить её через CLI или локальный OpenAI-совместимый server и проверить, что...
Пошаговая инструкция по настройке observability для AI-агентов с LangSmith: переменные окружения, региональный endpoint, LangChain/LangGraph, OpenTelemetry, проверка traces и ограничения.