Mantis передаёт агенту веб-страницу как короткий нумерованный текст, а не как скриншот. В сравнении, опубликованном авторами проекта, этот способ требовал меньше входных токенов и вызовов, чем дерево доступности Playwright MCP, для двух моделей на конкретных наборах задач. Точность при этом была близкой, но результат не доказывает, что Mantis ускорит любую браузерную автоматизацию.
Как Mantis представляет веб-страницу агенту
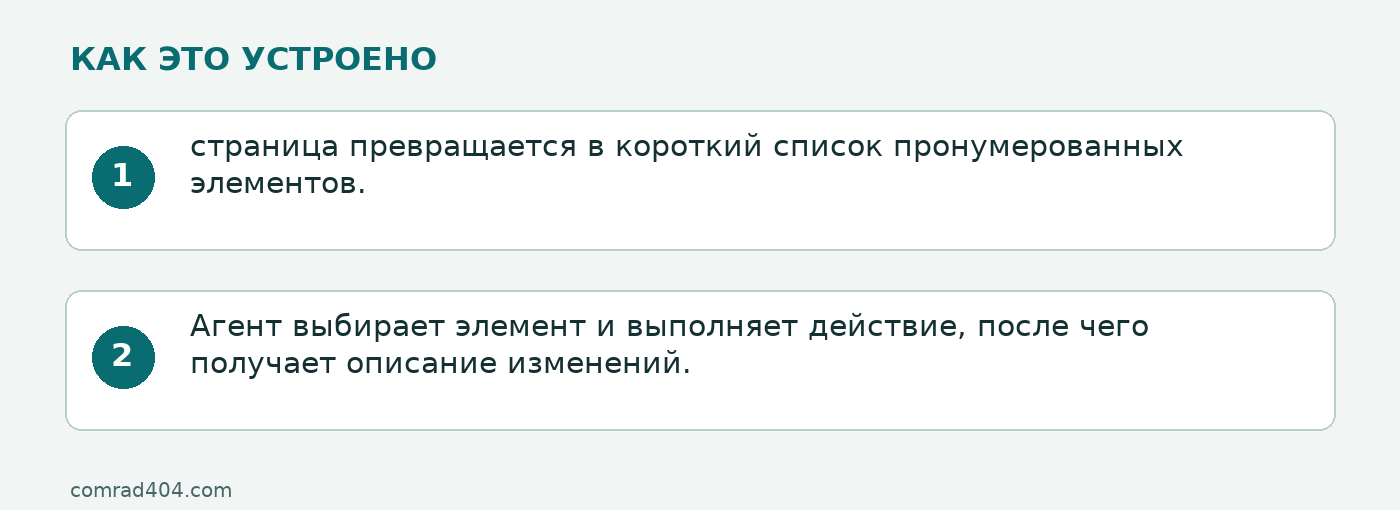
По описанию проекта, страница превращается в короткий список пронумерованных элементов. Агент выбирает элемент и выполняет действие, после чего получает описание изменений. Так устроен описанный авторами способ передавать модели состояние страницы вместо скриншота или дерева доступности. Описание Mantis и результаты бенчмарка авторов.
Mantis работает как MCP-сервер с Claude Code, Codex, Cursor или собственным агентом. Авторы включили в бенчмарк чтение страниц, навигацию и заполнение форм на публичных сайтах. README не приводит отдельного разбора конкретной формы: результаты относятся к набору задач, а не к проверке одного универсального сценария.
Длинные задачи: меньше ресурсов при близкой точности
В длинном наборе точность считали по 14 задачам с проверяемым ответом и 42 запускам на каждую комбинацию модели и способа навигации. Медианы токенов, вызовов и времени рассчитаны по 16 задачам и 48 запускам на ячейку. Поэтому показатели точности и ресурсов относятся к разному числу задач.
Для Luna Mantis дал 35 правильных запусков из 42 против 34 у дерева доступности Playwright MCP. Медиана входных токенов составила 244 тыс. против 345 тыс., вызовов инструмента — 17 против 24, времени — 42 против 66 секунд. Для Haiku точность совпала: 40 из 42 в обоих вариантах; Mantis показал 268 тыс. токенов против 506 тыс., 19 вызовов против 30 и 54 секунды против 85.
В этих результатах сокращение токенов и вызовов соседствует с близким числом правильных запусков. Однако разница в один запуск не доказывает равную надёжность методов за пределами этих моделей и задач.
Короткие задачи: экономия токенов и вызовов
Короткий набор включал 30 задач и 90 запусков на ячейку. Для дерева доступности и скриншотов авторы использовали более ранний прогон, поэтому разницу во времени следует считать ориентировочной, а не строго сопоставимой.
С Luna Mantis решил 88 задач из 90, дерево доступности — 86. Медиана входных токенов составила 64 тыс. против 99 тыс., вызовов — 3 против 4, времени — 16 секунд против 31. Для Haiku результаты точности составили 90 из 90 у Mantis и 88 из 90 у дерева; медианы — 38 тыс. против 88 тыс. токенов, 3 против 5 вызовов и 19 против 30 секунд.
Сравнение со скриншотами неоднозначно. Для Luna скриншоты дали на два правильных запуска больше, но потребовали больше токенов и времени; для Haiku скриншоты использовали меньше токенов, чем Mantis. Текстовое представление, таким образом, не лидировало по каждому показателю и для каждой модели.
Что показывают цифры и чего они не доказывают
По сводке авторов, в длинных задачах Mantis потребовал на 29–47% меньше входных токенов и на 29–37% меньше вызовов, а время было примерно на треть меньше. В коротких задачах авторы сообщают о равной или лучшей точности относительно дерева доступности и снижении входных токенов на 35–57%. Это результаты собственного бенчмарка проекта; независимых тестов среди доступных источников нет.
Правильность оценивали детерминированными ключами по финальному состоянию страницы. Две длинные задачи с iframe или вкладками исключили из подсчёта точности, поскольку не смогли оценить их таким способом. Авторы также сообщают, что некоторые задания заменяли после получения результатов. Вместе с использованием более раннего прогона для коротких задач это ограничивает сопоставимость и переносимость цифр на другие сайты и сценарии.
Ограничения для браузерной автоматизации
Результаты относятся к чтению страниц, навигации и заполнению форм на публичных сайтах. Они не показывают, как инструмент справляется с любыми сайтами и действиями. В частности, Mantis не поддерживает ввод через canvas: Canvas, WebGL, карты и рисовалки описываются как canvas, без инструмента координатного клика или рисования. Страницы с авторизацией и антибот-защитой могут потребовать участия человека через ask_human; для этого нужен дисплей.
README описывает подключение к отдельному профилю Chrome с сохранёнными входами пользователя. В этом режиме инструмент работает с реальными вкладками, поэтому ошибка может затронуть личные или рабочие данные. Бенчмарк не служит основанием для автономного запуска в такой сессии: действия требуют контроля.
Когда сравнение полезно на практике
Если ваши задачи похожи на публичные сценарии чтения, переходов и заполнения стандартных форм из теста, результаты авторов дают повод оценить Mantis как вариант с меньшим расходом токенов и числом вызовов. Для решения о внедрении сравните методы на собственных задачах и проверяйте правильность конечного состояния, а не только скорость. Для процессов с canvas, сложными вкладками или защищёнными сессиями приведённые цифры ответа о надёжности не дают.