В сравнении авторов статьи UIBK-Embedding-v1 получила 59,79 nDCG@10 на BEIR — на 2,57 пункта больше, чем LateOn. При одинаковой длине документов разница составила 2,10 пункта. Эти результаты помогают сравнить модели в условиях описанного бенчмарка, но не предсказывают качество на произвольном корпусе.
Архитектура и интеграция
UIBK-Embedding-v1 — англоязычный энкодер с 179 млн параметров. По описанию авторов, за один проход он формирует плотное представление и токенные векторы, а затем объединяет их оценки с помощью MaxSim. LateOn в статье выступает как модель для сравнения; авторы называют её сильнейшей моделью своего размера.
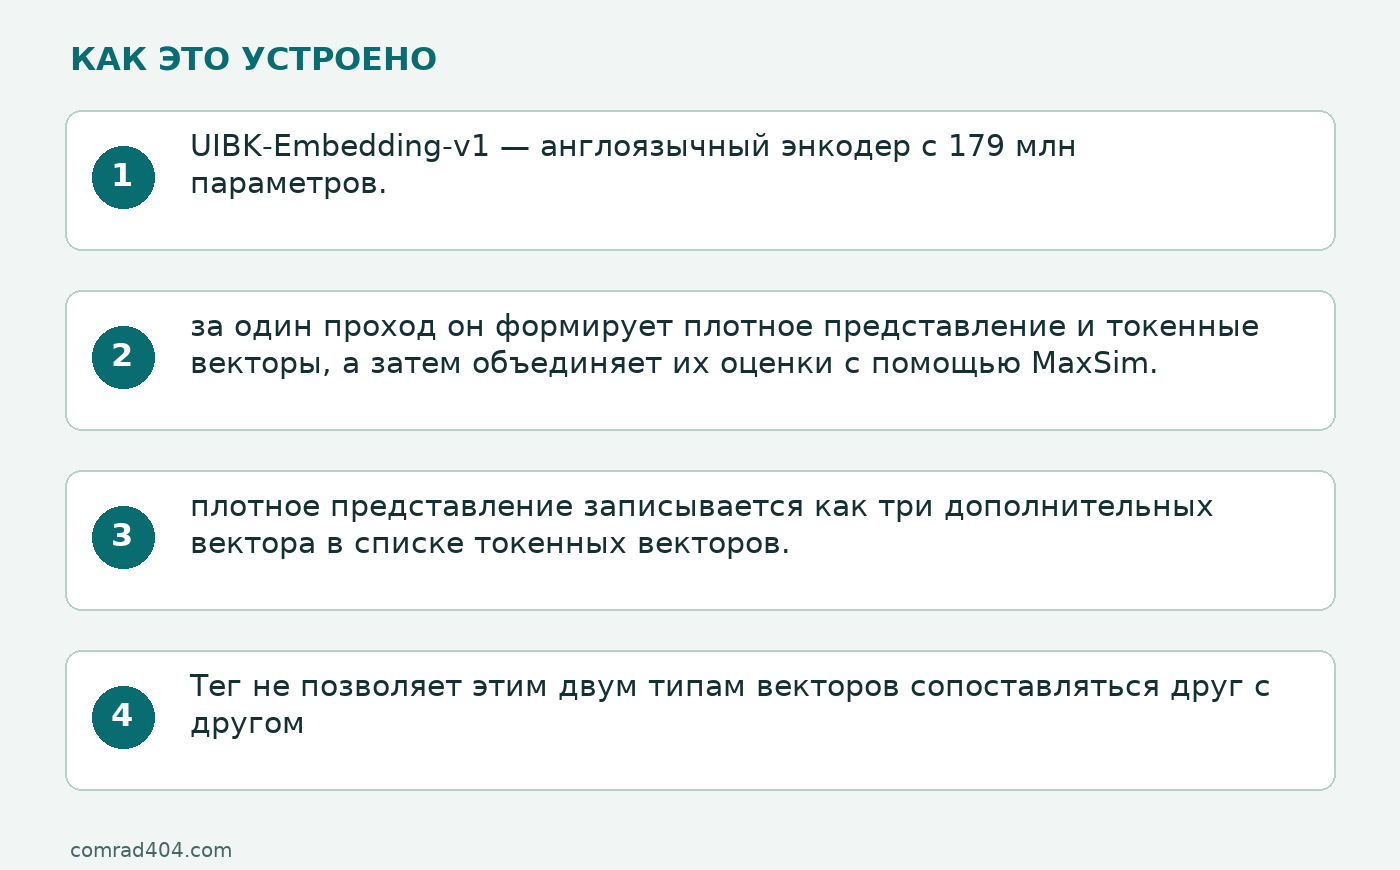
В UIBK-Embedding-v1 плотное представление записывается как три дополнительных вектора в списке токенных векторов. Тег не позволяет этим двум типам векторов сопоставляться друг с другом, чтобы MaxSim мог объединить токенный сигнал и взвешенное плотное сходство. Авторы сообщают, что модель сохраняется в формате ColBERT и запускается с PLAID через PyLate без изменений индексатора и оценщика. Это описание заявленной интеграции, а не независимая проверка совместимости.
Сравнение по одинаковым критериям
В таблице сведены показатели и характеристики, которые авторы приводят для BEIR. Все результаты бенчмарка ниже — опубликованные авторами статьи, а не независимые измерения редакции.
| Критерий | UIBK-Embedding-v1 | LateOn |
|---|---|---|
| Размер и позиционирование | 179 млн параметров | Авторы называют модель сильнейшей в её классе размера; число параметров в доступном сравнении не указано |
| BEIR, nDCG@10 | 59,79 | На 2,57 пункта ниже UIBK-Embedding-v1 в сравнении авторов |
| Одинаковая длина документов | На 2,10 пункта выше LateOn | На 2,10 пункта ниже UIBK-Embedding-v1 |
| 15 наборов BEIR | Авторы сообщают преимущество на всех 15 | В сравнении авторов уступает на всех 15 |
| Очищенная версия BEIR | Среднее 61,55; преимущество на 8 из 12 наборов | Среднее 60,36 |
| Эксплуатационные затраты на целевом корпусе | В статье не приведено сопоставимого замера | В статье не приведено сопоставимого замера |
Сравнение при одинаковой длине документов уменьшает влияние одного параметра входа, но не уравнивает все условия поиска. Таблица не сообщает о задержке, объёме индекса, стоимости его построения и обновления или потреблении памяти. Поэтому по ней нельзя заключить, какая модель дешевле или быстрее в конкретной системе.
Что показывает очищенный BEIR
На версии BEIR, очищенной от пересечений, авторы сообщают средние оценки 61,55 для UIBK-Embedding-v1 и 60,36 для LateOn. Преимущество первой модели сохраняется на 8 из 12 наборов, а не на каждом из них. Это дополнительный результат в пользу UIBK-Embedding-v1 в опубликованной оценке, но не гарантия аналогичного разрыва на других данных.
Авторы также пишут, что среди 156 моделей с полными результатами BEIR в репозитории MTEB выше оценивались только модели с числом параметров не менее 1,5 млрд. Это вывод по указанной ими выборке и не заменяет прямого сопоставления всех доступных вариантов для конкретной задачи.
Что можно заключить об объединении сигналов
Замысел UIBK-Embedding-v1 — совместить плотный семантический сигнал с токенным поиском точных сущностей и фраз в одном энкодере. По объяснению авторов, такой подход может заменить связку из двух моделей, двух индексов и этапа объединения оценок. Однако опубликованные показатели BEIR сами по себе не показывают, насколько изменятся затраты на хранение, индексирование и поиск в конкретной инфраструктуре.
Авторы описывают общую часть из 18 слоёв и отдельные верхние четыре слоя для каждой головы; оценку дополнительно обучали с использованием cross-encoder. Эти детали объясняют устройство модели, но доступный источник не содержит независимого редакционного теста на пользовательском корпусе или замеров в конкретной поисковой системе.
Кому подходит каждая модель
Если важны опубликованные результаты BEIR и объединение плотного и токенного представлений в одном энкодере, UIBK-Embedding-v1 — обоснованный кандидат для первичной оценки. Если команда уже использует LateOn, цифры статьи недостаточны, чтобы решить, окупится ли миграция: нужны одинаковые запросы и документы, а также собственные измерения качества, задержки, размера индекса и ресурсов.
Итог ограничен данными исследования: авторы сообщают о преимуществе UIBK-Embedding-v1 над LateOn на BEIR, в том числе при одинаковой длине документов. Выбор для реальной поисковой задачи требует отдельного сопоставления на целевых данных.