В рекомендациях с разным объёмом истории взаимодействий один и тот же дорогой реранкер может быть полезен одним пользователям и ухудшать результат для других. В препринте CascadeRec сопоставлены равномерное применение дорогого уровня и каскад, который распределяет вычисления по запросам. Авторы описывают офлайн-оценку на MovieLens-1M и Amazon-Electronics, а также производственный A/B-эксперимент; это результаты их работы, не независимый сравнительный тест. Препринт CascadeRec на arXiv.
Два режима LLM-реранжирования
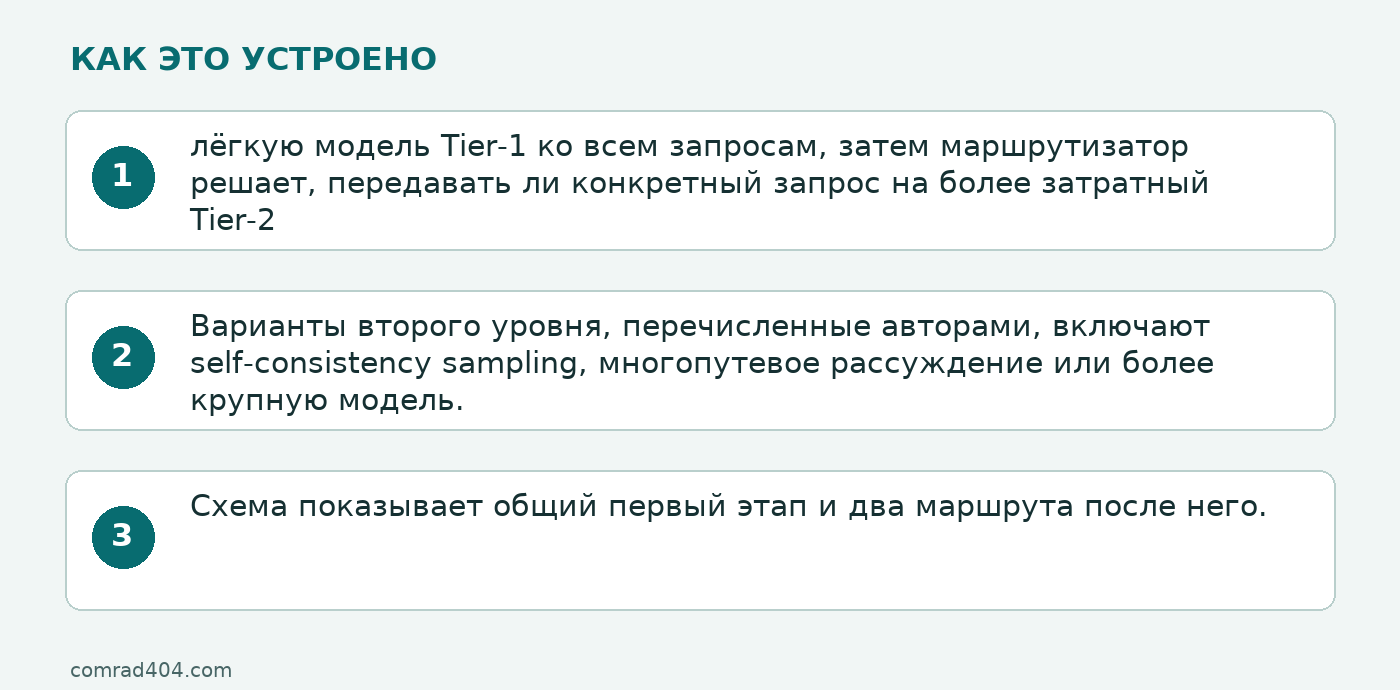
При равномерном подходе каждый запрос проходит дорогой этап реранжирования. CascadeRec сначала применяет лёгкую модель Tier-1 ко всем запросам, затем маршрутизатор решает, передавать ли конкретный запрос на более затратный Tier-2. Варианты второго уровня, перечисленные авторами, включают self-consistency sampling, многопутевое рассуждение или более крупную модель. Различие между подходами — не только в модели, но и в правиле распределения вычислений.
Каскад не означает, что дорогой уровень всегда отключён для пользователей с короткой историей: маршрутизатор выбирает запросы для эскалации, а подходящие сегменты, по выводу авторов, зависят от домена. Схема показывает общий первый этап и два маршрута после него.
Сравнение по одинаковым критериям
| Критерий | CascadeRec | Дорогой уровень для каждого запроса |
|---|---|---|
| Обработка запроса | Лёгкий Tier-1 для всех; маршрутизатор может направить запрос на Tier-2. | Дорогая процедура применяется ко всем запросам. |
| Распределение вычислений | Зависит от решения маршрутизатора и выбранной процедуры второго уровня. | Дорогие вычисления расходуются на каждый запрос. |
| Стоимость в производственном эксперименте | Авторы сообщают о снижении стоимости инференса примерно на 10% относительно равномерного применения дорогого уровня. | Служит базой сравнения в этом эксперименте; абсолютные затраты не приведены. |
| Задержка и качество в производственном эксперименте | Авторы называют влияние на задержку минимальным и сообщают, что на момент публикации не наблюдали деградации качества. | Сопоставимые численные значения задержки и качества не приведены. |
| Офлайн-результат для короткой истории | Эскалация сама по себе не гарантирует улучшения; результат зависит от сегмента и домена. | В описанных авторами экспериментах NDCG@10 снижалась, максимум — на 30% в сегментах с редкой историей. |
| Офлайн-результат для самой длинной истории | Маршрутизатор может направить подходящие запросы на дорогой уровень. | Единственный отмеченный авторами статистически значимый прирост — +27% в сегменте с самой длинной историей в MovieLens. |
Производственный результат и офлайн-метрики получены в разных условиях и не составляют единой шкалы качества. Около 10% — относительная экономия, сообщённая авторами для конкретного A/B-эксперимента, а не прогноз для другого сервиса. Архитектура и результаты в препринте.
Что показала офлайн-оценка
Авторы исследовали MovieLens-1M и Amazon-Electronics. В их сегментном анализе равномерное применение LLM-реранжирования снижало NDCG@10 для пользователей с короткой историей взаимодействий — максимум на 30% в описанных экспериментах. Единственный отмеченный статистически значимый прирост они обнаружили для пользователей с самой длинной историей в MovieLens: +27%. Это результат конкретного набора данных и сегмента, а не обещание такого же эффекта в других рекомендательных системах.
На Amazon с Mistral, сообщают авторы, дополнительные вычисления для пользователей, которым равномерное реранжирование вредило, усиливали потерю качества: это наблюдалось при self-consistency и многопутевом рассуждении. Авторы связывают это с тем, что при малом количестве свидетельств о предпочтениях дополнительным рассуждениям модели не на чем основываться. Это объяснение и результат конкретного эксперимента, а не правило для всех моделей и доменов.
NDCG@10 оценивает качество ранжирования в верхней части списка. Выводы относятся к двум публичным наборам данных и описанным авторами сегментам; переносить величину эффекта на другие домены, модели и правила построения рекомендаций без собственной оценки нельзя. Офлайн-оценка на MovieLens-1M и Amazon-Electronics.
Производственный результат и его пределы
Авторы сообщают, что CascadeRec работала более месяца в производственном A/B-эксперименте у неназванного крупного поставщика SaaS для финансового планирования и анализа. По сравнению с равномерным использованием дорогого уровня система снизила стоимость инференса примерно на 10%; влияние на задержку авторы назвали минимальным, а ухудшения качества на момент публикации не наблюдали. Это заявление авторов о конкретной системе, а не независимый тест.
Данные арендаторов производственного сервиса не опубликованы. Поэтому препринт не позволяет независимо перепроверить состав запросов, абсолютную стоимость, задержки или сегментные показатели качества в этой среде. Офлайн-оценка на публичных наборах дополняет производственный эксперимент, но не раскрывает его данные и не подтверждает тот же эффект для других компаний. Описание производственного эксперимента в препринте.
Кому подходит каждый подход
Каскад стоит рассматривать, если у аудитории различается объём истории, дорогой этап заметно влияет на бюджет, а команда может оценивать маршрутизацию и качество отдельно по сегментам. Его практический смысл — не запускать наиболее затратную процедуру автоматически для каждого запроса. Опубликованные авторами примерно 10% экономии не следует использовать как прогноз для другой системы.
Равномерный дорогой уровень может быть удобной исходной точкой, если поток запросов однороден или команде нужен единый режим для сравнения качества. Но препринт не подтверждает, что дорогой реранкер улучшает результат для всех пользователей: в офлайн-оценке авторы сообщают об ухудшении для короткой истории, а в эксперименте на Amazon с Mistral дополнительные вычисления усиливали потерю качества в затронутой группе.
Выбор зависит от распределения истории взаимодействий, цены инференса и допустимого качества по сегментам. Для неоднородной аудитории сравнивать каскад с равномерным режимом имеет смысл на собственных данных, отдельно отслеживая стоимость, задержку и качество. Для однородного потока равномерный режим проще использовать как отправную точку, но он не гарантирует выигрыша качества. Препринт даёт основания оценивать адаптивную маршрутизацию, но не устанавливает универсального победителя.