Если ошибка появляется на одном из шагов LLM-агента, повторный запуск всей цепочки может тратить ресурсы на неизменившиеся действия и затруднять сравнение вариантов. Agentfork описывает способ записать вызовы модели и инструментов, воспроизвести предшествующие выбранному шагу действия из кэша и проверить несколько вариантов этого шага. Практический вопрос здесь не только в том, прошёл ли тест один ответ, но и в том, повторяется ли нужное свойство в серии запусков.
Что именно воспроизводит Agentfork
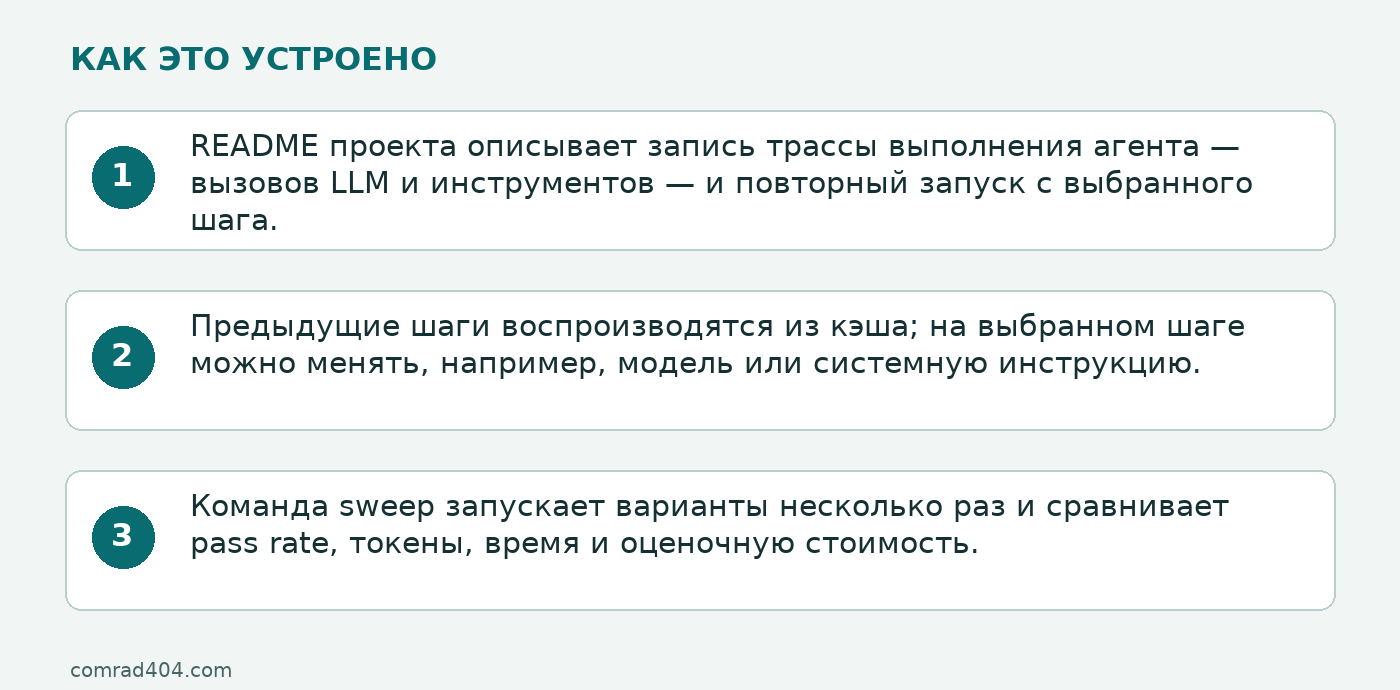
README проекта описывает запись трассы выполнения агента — вызовов LLM и инструментов — и повторный запуск с выбранного шага. Предыдущие шаги воспроизводятся из кэша; на выбранном шаге можно менять, например, модель или системную инструкцию. Команда sweep запускает варианты несколько раз и сравнивает pass rate, токены, время и оценочную стоимость. Документация также описывает сохранение запуска как pytest-теста: он воспроизводит шаги из кэша и сообщает, если изменились входы шагов, их количество или финальный вывод.
Такой подход полезен, когда нужно проверить гипотезу о месте ошибки. Допустим, агент уже получил заказ через API, но неверно представил сумму в ответе. Повтор с более позднего шага позволяет сосредоточить эксперимент на этой части трассы, не повторяя неизменившиеся действия. Однако выбор шага сам по себе не доказывает, что причина найдена: если ошибка возникла раньше или зависит от взаимодействия нескольких шагов, эксперимент может не охватить важное условие.
Метод разделяет воспроизведение записанных шагов и новые варианты выбранного шага. Поэтому его вывод относится к заданной трассе и условиям теста, а не автоматически ко всем входам агента или изменчивым внешним системам.
Пример: сумма возврата в центах
В примере README агент получает из API заказа значение amount: 4999 и валюту USD. Автор проекта поясняет, что сумма задана в центах: ноутбук стоит 49,99 доллара, но агент сообщает о возврате 4 999 долларов. Для проверки вариантов используется текстовый критерий --expect, ожидающий строку 49.99 в финальном ответе.
По таблице README исходный вариант прошёл этот критерий в 0 из 1 запусков. Для gpt-4o-mini указано 0 прохождений из 3, и для gpt-4o — тоже 0 из 3. Значит, в этой демонстрации замена модели не исправила именно проверяемый текстовый результат.
| Вариант | Запуски | Прошли —expect | Токены | Время | Оценка стоимости |
|---|---|---|---|---|---|
| Исходный | 1 | 0 | 446 | 1,7 с | $0,0001 |
| Модель gpt-4o-mini | 3 | 0 | 446 | 1,4 с | $0,0001 за запуск |
| Модель gpt-4o | 3 | 0 | 394 | 1,2 с | $0,0015 за запуск |
| Изменённая системная инструкция № 1 | 3 | 0 | 445 | 1,2 с | $0,0001 за запуск |
| Изменённая системная инструкция № 2 | 3 | 3 | 457 | 1,2 с | $0,0001 за запуск |
Значения в таблице приведены в демонстрации автора проекта, а не получены в независимом тестировании. Вариант системной инструкции № 2 добавляет правило делить сумму в центах на 100; он прошёл текстовый критерий во всех трёх запусках. Это конкретный результат на примере README, а не подтверждение того, что инструкция сработает для других заказов или условий.
Таблица и описание демонстрации опубликованы в README Agentfork.
Что означает pass rate — и чего он не означает
В примере pass rate показывает долю запусков, в финальном тексте которых найден фрагмент, заданный через --expect. Поэтому результат 3 из 3 означает, что строка 49.99 встретилась в трёх ответах. Он не проверяет, правильно ли проведена транзакция, соответствует ли сумма записи в базе, разрешён ли возврат и не произошло ли повторное списание.
Повторы помогают не принимать единичный удачный ответ за устойчивое исправление, но три запуска — небольшая серия. По ней нельзя оценить надёжность на разнообразных запросах или сделать статистический вывод о работе в производственной среде. Для практической проверки нужно отдельно покрывать важные условия задачи и побочные эффекты, а не ограничиваться наличием фразы в ответе.
README сообщает, что стоимость оценивается по токенам исходного выполнения начиная с выбранного шага и тарифам модели. В демонстрационной таблице для gpt-4o указано $0,0015 за запуск, а для соседних вариантов — $0,0001 за запуск. Это оценка проекта, а не счёт провайдера и не независимое измерение фактических расходов. Она полезна для сопоставления вариантов в рамках принятого расчёта, но не заменяет сведения о реальном использовании API.
Как использовать повторы при отладке
Сначала записывают выполнение, чтобы сохранить последовательность вызовов и получить исходную трассу. Затем находят шаг, на котором впервые появляется расхождение, и формулируют проверяемую гипотезу: например, что инструкция не объясняет преобразование центов в доллары. Этот выбор нужно считать гипотезой, а не доказанной локализацией причины.
Далее сравнивают варианты, меняя на выбранном шаге один существенный параметр за раз — например, формулировку системной инструкции или модель. Серия повторов позволяет увидеть, повторяется ли результат по заданному критерию. В примере Agentfork смена модели не прошла проверку, тогда как второе изменение инструкции прошло её в 3 из 3 запусков. Это полезная подсказка для отладки: сначала проверить точечное изменение на одной и той же трассе, прежде чем объяснять ошибку недостаточной мощностью модели.
Критерий следует выбирать в соответствии с задачей. Для ответа о возврате наличие суммы в тексте может быть одним тестом, но его нужно дополнить проверками фактического состояния заказа и допустимых сумм. Для регрессионной проверки README предлагает сохранять запуск как pytest-тест; описанное сравнение фиксирует изменения входов шагов, числа шагов или финального вывода. Эти проверки дополняют друг друга: текстовый критерий проверяет требуемое свойство ответа, а тест трассы — соответствие сохранённому выполнению.
Совместимость и пределы применения
README утверждает, что Agentfork работает локально и данные не покидают машину. Это заявление документации проекта, а не результат независимого аудита сетевого поведения. Перед использованием с чувствительными трассами разработчику важно учитывать это различие и оценивать приложение в собственном окружении.
В README также указано, что потоковые модели с параметром streaming=True и OpenAI Responses API пока не записываются. Это ограничивает применение инструмента в сценариях, построенных на этих интерфейсах. Кроме того, доступная демонстрация ограничена одним примером, текстовым критерием и небольшим числом повторов; независимых тестов эффективности метода в рабочих сценариях здесь нет.
Agentfork помогает сравнить варианты на записанном выполнении и увидеть, повторяется ли заданный результат. Но сила вывода зависит от выбора шага, критерия и охвата входных условий: 3 из 3 подтверждает только прохождение конкретной текстовой проверки в трёх запусках, а не полную корректность LLM-агента.