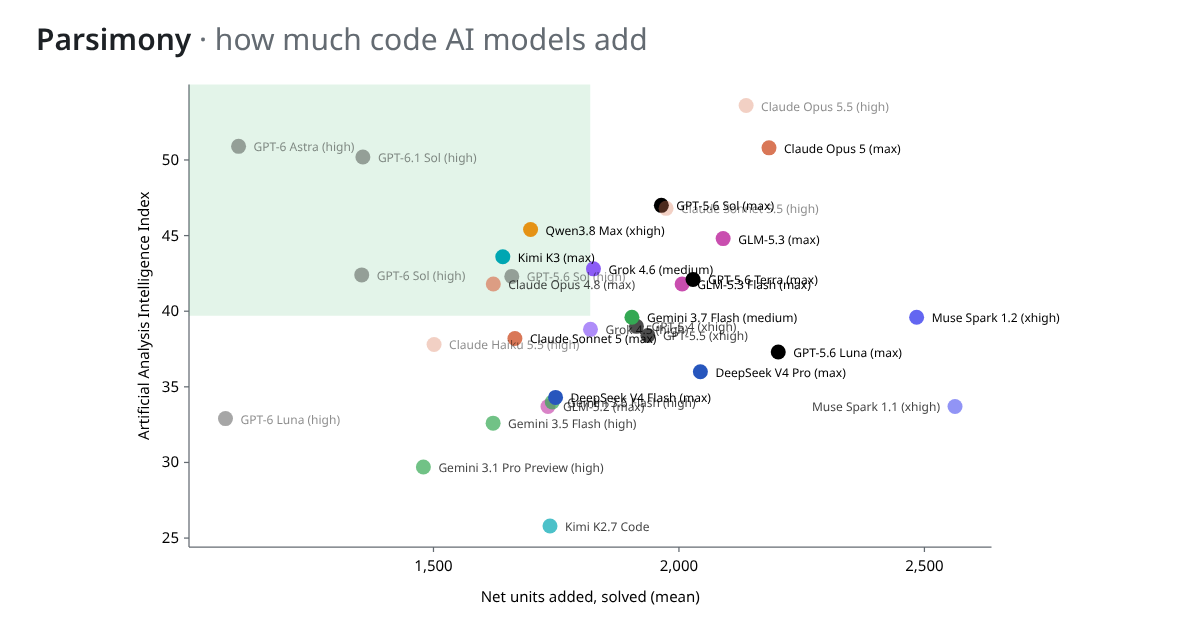
Parsimony — открытый бенчмарк, который сравнивает модели по тому, сколько кода они добавляют при решении задач разработки. Проект опубликован на сайте parsimony.lasu.dev; его автор предлагает дополнить привычные показатели вроде успешности и стоимости отдельной метрикой — чистым объёмом изменений.
Как считается объём
Вместо строк кода Parsimony считает «единицы кода»: синтаксические элементы вроде операторов, вызовов, сравнений, имён и литералов. Это снижает влияние форматирования и плотности записи. Удалённые элементы вычитаются из добавленных, поэтому метрика отражает чистое изменение, а не только размер нового кода.
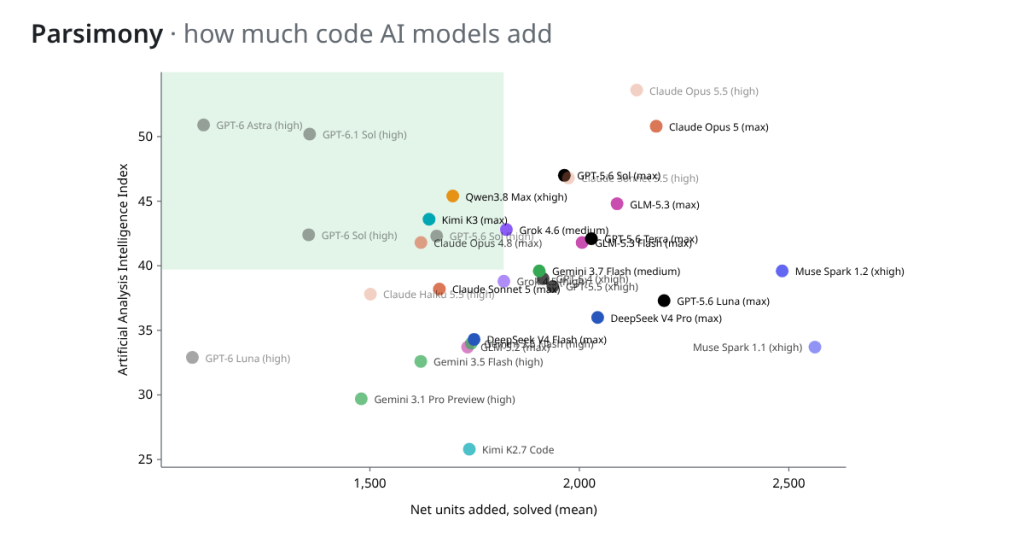
Для сравнения используются патчи, опубликованные в DeepSWE, SWE-bench Verified и SWE-bench Live. Согласно описанию проекта, модели ранжируются по среднему числу чистых единиц в решённых задачах; отдельный показатель также учитывает неудачные попытки. Число «измеренных» решений показывает, для скольких попыток удалось получить данные. Успешность берётся из SWE-bench Verified, но тесты самим Parsimony повторно не запускаются.
Что показывают результаты
Задача бенчмарка — добавить к оценке моделей ещё один ракурс: сколько синтаксического материала сопровождает решение. В долгосрочных проектах большой патч может быть неудобен для проверки и сопровождения, даже если задача решена. Однако число единиц само по себе не говорит, что код избыточен: более крупное изменение иногда необходимо для корректного решения.
На графике есть и собственные прогоны автора для некоторых моделей — от трёх до десяти задач DeepSWE на Python. Они показаны бледными маркерами и не включены в рейтинг: это небольшая выборка, проверенная на тестах конкретных задач, а не опубликованные результаты соответствующих бенчмарков. Автор также отмечает, что свежие модели без публичных патчей нельзя полноценно сопоставить с остальными.
Ограничения и применение
Parsimony не заменяет оценку корректности, читаемости или сопровождения. Меньшее число единиц не доказывает, что решение лучше, а опубликованное описание не сообщает о независимой проверке методики. Результат зависит от доступных патчей, состава задач и условий запуска; сравнивать цифры разумно только с учётом этих различий.
Практическая ценность проекта — в постановке вопроса, который часто теряется за точностью решения и стоимостью токенов: насколько большим оказалось изменение в кодовой базе. Для команд это может быть полезным дополнительным сигналом при сравнении моделей, но не самостоятельным критерием выбора. Автор приглашает присылать данные из других бенчмарков, чтобы расширять сравнение.