Исследователи из Carnegie Mellon University, New York University, Stanford University и MIT представили Ataraxos — систему, которая выиграла у одного из сильнейших игроков в Stratego, Пима Неймейера, 15 партий из 20. В статье, опубликованной в Nature, авторы называют это первым случаем сверхчеловеческой игры ИИ в Stratego. По их оценке, обучение Ataraxos стоило менее $8 000 в пересчёте на цены 2025 года.
Результат интересен не только победой над чемпионом: Stratego требует принимать решения, не зная расстановки фигур соперника. Авторы показывают, как сочетание самоигры, моделирования вероятных скрытых состояний и дополнительных вычислений во время выбора хода помогает работать с такой неопределённостью. Однако цифры стоимости не основаны на прямом повторении эксперимента DeepMind, поэтому сравнение ресурсов следует трактовать как оценку исследователей, а не как независимый бок о бок тест двух систем.
Серия против Пима Неймейера
Матч провели в формате из 20 партий за три недели. Неймейер выиграл одну, четыре завершились вничью, а остальные 15 выиграл Ataraxos. В пересчёте с учётом ничьих авторы указывают эффективную долю побед 85%.
Неймейер — многократный чемпион мира и Нидерландов. По данным материала The Decoder, он четырежды выигрывал чемпионат мира, 15 раз становился чемпионом Нидерландов и более 600 недель занимал первое место в мировом рейтинге. Важно, что речь идёт об одной серии против одного игрока, а не о доказательстве превосходства ИИ над всеми возможными стратегиями и соперниками.
Участнику дали время подготовиться, а матчи распределили на несколько недель, чтобы снизить влияние усталости. Неймейер мог приспосабливаться к игре системы по ходу серии; Ataraxos, по описанию эксперимента, не адаптировался непосредственно к стилю соперника. Авторы считают это структурным преимуществом человека, но результат всё равно остаётся конкретным турнирным тестом, а не универсальной оценкой игровых способностей.
Почему Stratego сложно для алгоритмов
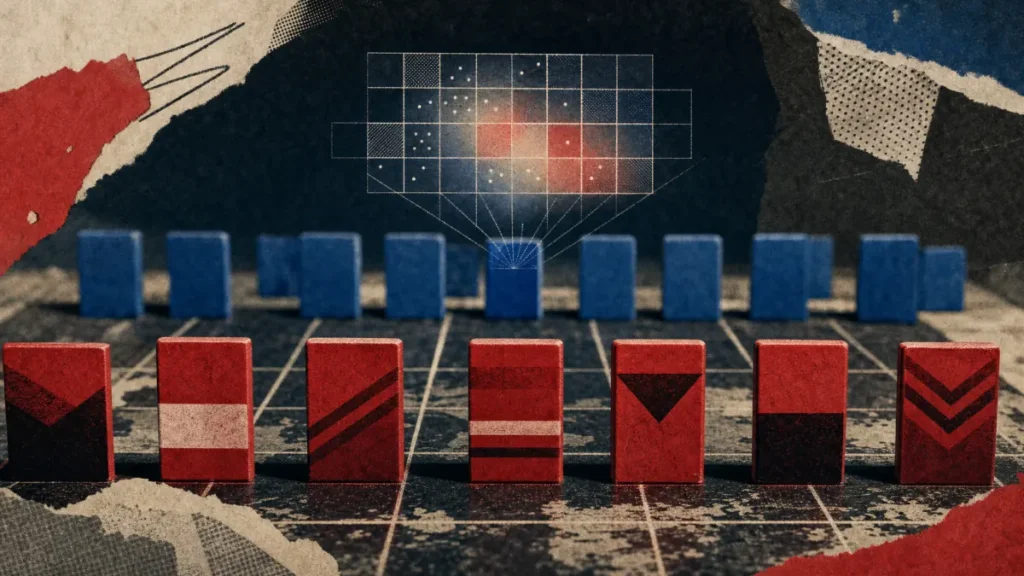
В Stratego каждый игрок тайно расставляет 40 фигур. Их ранги и особые свойства скрыты от противника до столкновения, поэтому выбор хода зависит от предположений о невидимых элементах позиции. Авторы статьи оценивают число возможных стартовых расстановок более чем в 10³³.
Это усложняет применение методов, которые хорошо показали себя в играх с неполной информацией, но ограниченным числом скрытых вариантов. Ataraxos обучается без партий, сыгранных людьми: система играет сама с собой и учится на полученных траекториях. В описании авторов важную роль играет регуляризация — механизм, который не даёт обучению слишком рано закрепиться на предсказуемой стратегии. Для игры с блефом и скрытой информацией такая предсказуемость может стать уязвимостью.
Дополнительно система использует сеть оценки убеждений: она прогнозирует, какие фигуры могут находиться на скрытых клетках. Перед ходом Ataraxos формирует возможные варианты состояния и оценивает кандидатов, выполняя дополнительный шаг обучения для конкретного решения. Это не означает, что система узнаёт истинную расстановку: она работает с оценками и гипотезами.
Что известно о вычислительной стоимости
По данным статьи и пересказу The Decoder, Ataraxos обучали неделю на 16 графических процессорах Nvidia H100, а затем ещё четыре дня на четырёх GPU обучали сеть оценки скрытых состояний. Авторы оценивают общую стоимость менее чем в $8 000 по ценам 2025 года.
Для сравнения они приводят DeepNash от Google DeepMind. Согласно статье, DeepNash обучался на 1 024 TPU в течение двух-трёх месяцев; авторы Ataraxos оценивают стоимость такого объёма вычислений в $3–4,5 млн по ценам 2025 года. В пересказе исследования также говорится, что Ataraxos потребовал примерно в 500 раз меньше вычислений, в 30 раз меньше партий самоигры и в 100 раз меньше обучающих примеров.
Эти значения не следует воспринимать как результат прямого сравнения систем на одинаковом оборудовании и при одинаковом протоколе. Авторы Ataraxos сообщили, что предложили организовать такое сравнение, но, по их словам, код DeepNash больше не работал. Следовательно, оценки стоимости опираются на сведения о прежнем обучении и расчёты авторов новой работы, а не на повторный запуск обеих систем в контролируемых одинаковых условиях.
Где ещё проверяли подход
Исследователи сообщают и о результатах в других играх. В варианте Barrage Stratego их система выиграла четыре серии по 50 партий у трёх из четырёх высокорейтинговых игроков. В карточной игре Hanabi команда заявляет о новых результатах в нескольких вариантах, а в двухигроковой версии — о меньших затратах вычислений по сравнению с прежней системой-лидером. В китайской карточной игре Dou dizhu Ataraxos, согласно статье, превзошёл системы PerfectDou и DouZero.
Такие результаты расширяют проверку за пределы одной серии в Stratego, но не доказывают, что тот же подход автоматически даст преимущество в любой задаче с неполной информацией. В статье авторы связывают переносимость метода с наличием быстрого и точного симулятора. Это существенное ограничение для практических применений: разработчику нужно не только построить алгоритм, но и формализовать среду так, чтобы симуляция надёжно отражала реальные правила и последствия действий.
Что проверить разработчикам игровых агентов
Для оценки подобных систем полезно разделять четыре вещи: качество симулятора, силу соперников, цену обучения и устойчивость стратегии. Победа в отдельном матче не показывает, как агент поведёт себя против разнообразных тактик; низкая расчётная стоимость также не гарантирует сопоставимой эффективности в другой среде.
В материалах исследования, пересказанных The Decoder, нет прямого сопоставительного теста Ataraxos и DeepNash на общей инфраструктуре. Поэтому практический вывод для команд, создающих агентов, уже и конкретнее: самоигра и моделирование скрытых состояний могут быть полезны там, где правила можно точно симулировать, но перенос результатов нужно проверять отдельными сериями против разных соперников и с опубликованными условиями эксперимента.
При чтении статьи стоит сверить протокол матчей, способ расчёта стоимости и метрики для дополнительных игр. Именно эти детали позволяют понять, где заканчивается подтверждённый результат — победа в серии и эксперименты в нескольких играх — и начинается более широкая гипотеза авторов о применении метода к задачам с неполной информацией.