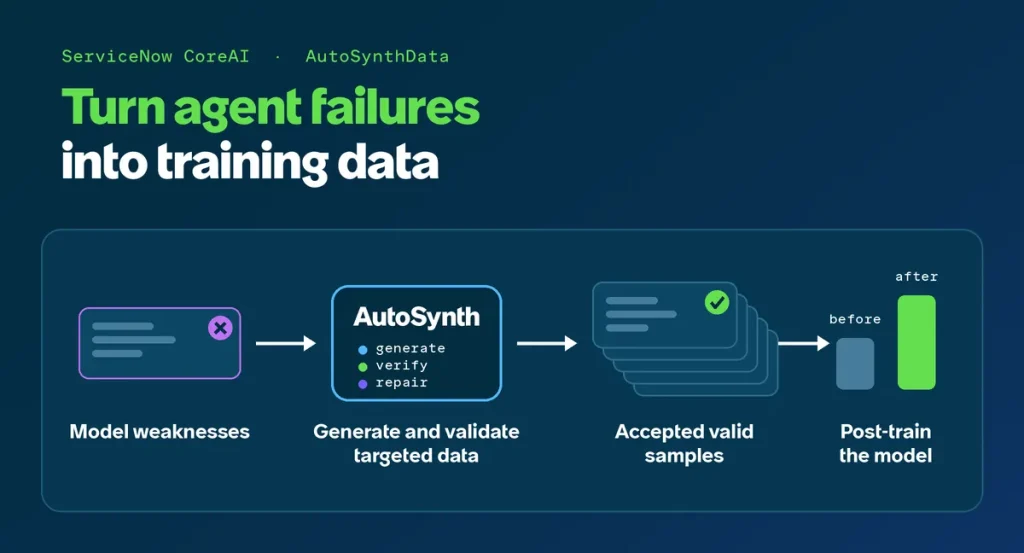
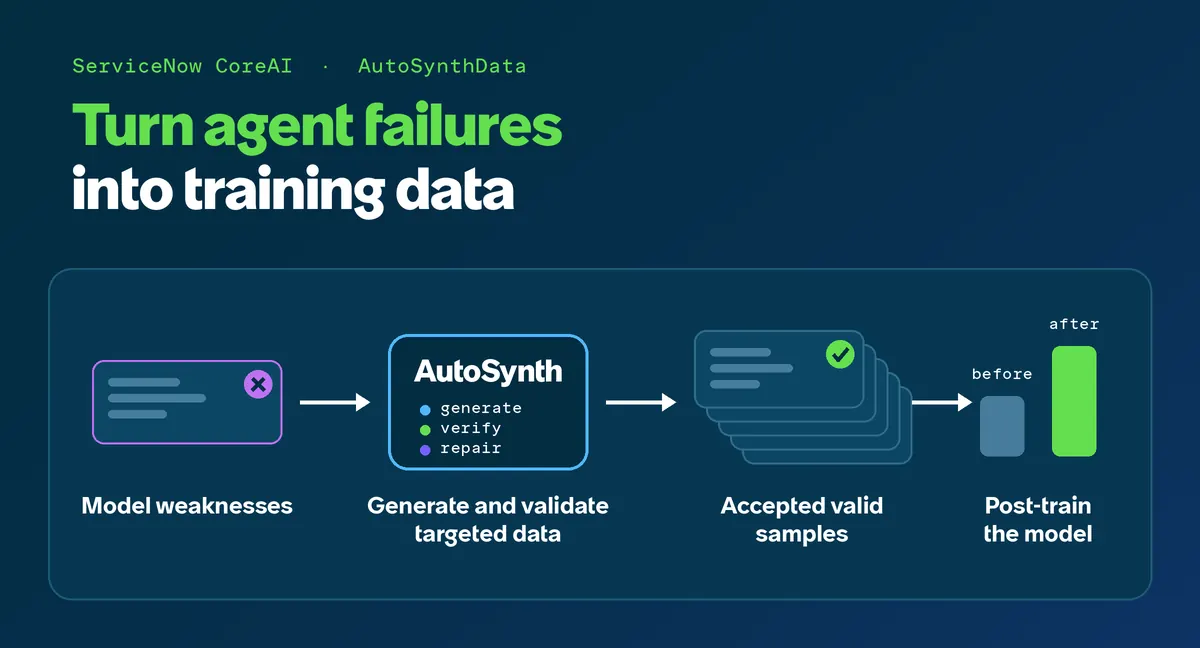
ServiceNow CoreAI представила AutoSynthData — метод создания тренировочных данных на основе ошибок, которые ИИ-агент допускает в конкретной корпоративной среде. Система сравнивает работу целевой модели с более сильной моделью-учителем, описывает обнаруженные пробелы в навыках и генерирует новые задачи для их отработки.
Описание метода опубликовано 2 октября 2026 года в блоге Hugging Face. В качестве экспериментальной среды авторы используют EnterpriseOps Gym и сообщают о выпуске связанного набора данных. При этом доступные материалы исходят от самой исследовательской команды: независимого воспроизведения результатов или сравнения с альтернативными генераторами данных в публикации не представлено.
От единичной ошибки к серии тренировочных задач
Корпоративному агенту недостаточно уметь отвечать на общие вопросы. Он должен работать с определёнными API, учитывать состояние внутренних систем, соблюдать политики доступа и правильно выполнять многошаговые операции. Модель может успешно справляться с типовыми запросами, но ошибаться при необычном сочетании инструментов или ограничений.
Один неудачный запуск показывает наличие проблемы, однако сам по себе почти не подходит для дообучения. Нужен набор разнообразных примеров, проверяющих ту же способность в других обстоятельствах. По замыслу ServiceNow CoreAI, AutoSynthData автоматизирует именно этот переход: от наблюдаемого сбоя к группе новых задач.
Каждая задача в методе состоит из трёх элементов:
— системной спецификации, определяющей инструкции, политики и начальное состояние среды;
— пользовательского запроса, описывающего требуемый результат и ограничения;
— верификатора, проверяющего, действительно ли агент достиг результата.
Авторы выделяют три требования к генерируемым задачам. Они должны быть выполнимыми с доступными инструментами, напоминать реальные рабочие запросы и оставаться достаточно сложными для текущей версии агента. Если модель уже стабильно решает задачу, такой пример даёт мало нового тренировочного сигнала.
Как AutoSynthData находит слабые места модели
Первый этап начинается с диагностических запусков в целевой среде. Одни и те же задачи выполняют обучаемая модель и более сильная модель-учитель. Затем система анализирует различия между их действиями и выделяет повторяющиеся типы ошибок.
Результаты анализа преобразуются в так называемые карточки спецификаций способностей. Они описывают навык, который требуется улучшить, но, по утверждению авторов, не содержат исходных пользовательских запросов, сущностей, траекторий действий и деталей верификаторов из диагностического набора.
Такое разделение должно снизить риск простого копирования оценочных примеров. Однако оно само по себе не доказывает отсутствие утечки: для проверки нужны опубликованные карточки, правила их очистки и возможность сопоставить тренировочные задания с исходным тестовым набором.
На основе карточек генератор создаёт новые сценарии. Если агент, например, плохо выполняет последовательность из нескольких вызовов инструментов, система может менять начальное состояние среды, используемые сущности, формулировку запроса и допустимый путь решения. Модель-учитель выполняет задачу и предоставляет успешную траекторию, которую затем можно использовать при supervised fine-tuning.
Две стадии отбора синтетических данных
Формирование набора разделено на стадии target и multiply. На стадии target независимые рабочие процессы создают основные примеры под обнаруженные пробелы в навыках. Каждый кандидат проходит проверку, выполнение в среде, оценку решения и при необходимости исправление.
Стадия multiply создаёт варианты уже принятых задач. У них должны отличаться пользовательский запрос, конфигурация сущностей, начальное состояние, траектория решения и верификатор. Эти варианты проходят тот же цикл проверок, что и исходные примеры.
Критически важную роль здесь играет верификатор. Слишком мягкая проверка может засчитать ошибочное поведение, а слишком узкая — отклонить корректное решение только потому, что агент пошёл не по заранее предусмотренному маршруту. Поэтому авторы требуют согласованности верификатора с условиями задачи, способности отклонять неверные результаты и принимать разные допустимые решения.
После отбора примеры используются для дообучения целевой модели. Обновлённого агента снова запускают на диагностических заданиях, после чего следующая итерация генерации концентрируется на оставшихся слабых местах. Таким образом, учебная программа меняется вместе с моделью, а не остаётся фиксированной.
Что показано на EnterpriseOps Gym
Авторы иллюстрируют подход на EnterpriseOps Gym — среде, моделирующей выполнение корпоративных операций. В статье утверждается, что AutoSynthData позволяет создавать задачи, привязанные к возможностям среды и текущим недостаткам агента.
Однако по имеющимся материалам нельзя переносить этот результат на любые корпоративные системы. EnterpriseOps Gym — контролируемая среда, тогда как в реальной инфраструктуре состояние данных может меняться, API — возвращать непредвиденные ошибки, а права доступа — зависеть от пользователя и контекста. Отдельной проверки потребуют и операции с необратимыми последствиями.
Публикация также не устанавливает, насколько дорого обходится работа модели-учителя, генерация вариантов и многократное исполнение кандидатов. Для практического внедрения это существенный вопрос: автоматическое создание данных может сократить ручную разметку, но увеличить расходы на модельные вызовы и изолированные тестовые среды.
Материалы ServiceNow AI собраны в профиле исследовательской команды на Hugging Face. Доступные наборы данных можно проверить отдельно в разделе datasets организации. Публикация датасета не означает автоматически, что вместе с ним доступны весь код конвейера, конфигурации экспериментов и условия для точного воспроизведения.
Что проверить разработчикам перед экспериментом
Для команды, уже тестирующей агентов в воспроизводимой среде, AutoSynthData предлагает понятную схему: фиксировать ошибки, группировать их по недостающим навыкам, создавать вариативные сценарии и принимать в обучение только задачи с надёжной проверкой результата.
Перед использованием метода стоит проверить четыре пункта:
— можно ли безопасно сбрасывать среду к известному состоянию после каждого запуска;
— допускает ли верификатор несколько корректных способов решения, а не одну эталонную последовательность действий;
— исключено ли смысловое дублирование между диагностическими и тренировочными задачами;
— превосходит ли дообученная модель базовую при одинаковом вычислительном бюджете и на ранее не использовавшихся сценариях.
Пока AutoSynthData следует рассматривать как исследовательский метод, а не как подтверждённый универсальный продукт для корпоративного посттренинга. Наиболее полезная следующая проверка — воспроизвести цикл на собственной среде, отдельно измерив качество задач, долю отклонённых примеров, стоимость модели-учителя и перенос улучшений на новые рабочие процессы.