Тема COMRAD404

Ollama

26 материалов

Как настроить локальное кеширование контекста в Ollama для LLM-агентов: архитектура, память и реальная экономия

Разбираем внутреннюю архитектуру кеширования контекста в Ollama, настраиваем параметры KV-cache для автономных агентов и замеряем реальное ускорение генерации при многошаговых...
Как настроить локальный рендеринг контекста для LLM-агентов через Ollama и MCP: архитектура, память и безопасность

Разбираем, как связать локальные модели через Ollama с протоколом Model Context Protocol (MCP) для безопасного управления контекстом агентов без утечки...

Автоматизация коммитов через LLM: разбор локальных утилит и безопасность пайплайна

Как настроить локальную генерацию описаний для git commit с помощью локальных моделей и CLI-утилит. Разбираем требования к безопасности кода, ограничения...

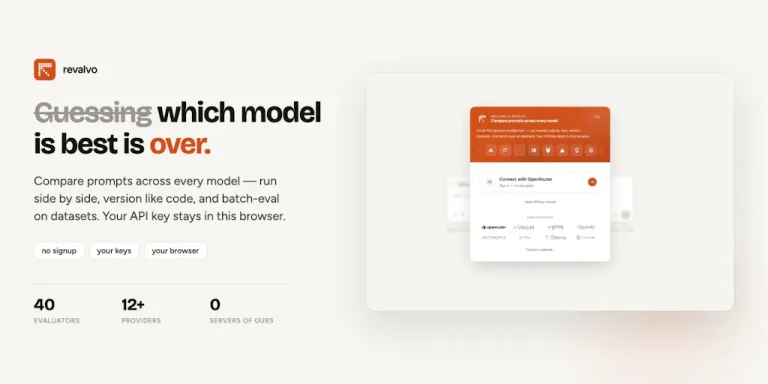
Локальный промпт-воркбенк Revalvo: пакетное тестирование моделей и гибридные эвалы без облака

Новый инструмент Revalvo предлагает разработчикам локальную среду для параллельного прогона промптов по нескольким моделям, пакетной оценки через детерминированные правила и...

Как локальные LLM меняют разработку: обзор инструментов и практика запуска

Разбор актуальных инструментов для запуска локальных больших языковых моделей на потребительском «железе». Сравнение производительности, утилит для интеграции с IDE и...

Как запустить агента на базе LLM локально: минимальная конфигурация для разработчика

Собираем рабочего агента на локальной LLM без облачных API. Инструкция для разработчика: выбор модели, фреймворк, инструменты и ограничения, о которых...

Локальные языковые модели на ПК: как выбрать аппаратную конфигурацию и инструменты для запуска

Разбор актуальных подходов к запуску LLM локально. Какие требования предъявляют современные открытые модели к видеокартам и оперативной памяти, а также...