Тема COMRAD404

генерация видео — страница 29

1082 материалов

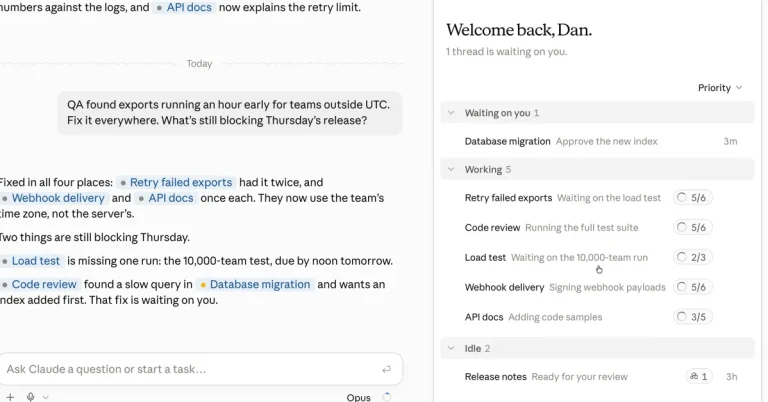
Как протестировать tool calling в LLM до продакшена: сценарии, метрики и автоматическая проверка

Практическая методика проверки tool calling в AI-агентах: синтетические сценарии, валидация аргументов, тесты цепочек, обработка ошибок и критерии допуска в продакшен.
Как оценивать стабильность контекста в LLM-агентах: разбор метрик, уязвимостей к «забыванию» и методов проверки

Разбираем практические методы оценки стабильности контекста у LLM-агентов. Анализируем метрики деградации памяти, проблемы «забывания» в длинных сессиях, бенчмарки и подходы...

Кейс Intercom и OpenAI: три архитектурных принципа масштабирования AI-агентов в поддержке

Команда Intercom поделилась опытом внедрения продакшн-систем на базе языковых моделей OpenAI. Разбираем автоматизированную оценку, модульную архитектуру и логику эскалации для...

Воспроизводимость AI-бенчмарков не гарантирует верификации бизнес-заявлений

Аналитик проверил пять AI-проектов XPRIZE: технические результаты воспроизводились, но бизнес-заявления оказались сложнее. Например, “91,2%” зависели от метода агрегации, а “AI...

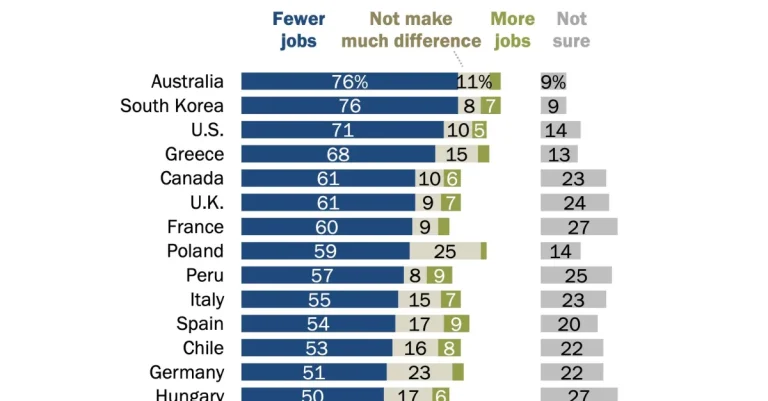
ИИ-апокалипсис для рабочих мест: глобальный опрос Pew Research подтвердил самые мрачные ожидания

Крупнейшее за последние годы международное исследование Pew Research Centre, охватившее 42 151 респондента в 37 странах, показало: большинство жителей планеты...