IFEval: как объективно проверить, что AI-агент выполняет ваши инструкции
Разбираемся, как работает бенчмарк IFEval от Google Research, и показываем, как с его помощью протестировать, насколько точно AI-агент следует заданным...
Тема COMRAD404
Разбираемся, как работает бенчмарк IFEval от Google Research, и показываем, как с его помощью протестировать, насколько точно AI-агент следует заданным...
OpenAI сообщила о MentalHealthBench — бенчмарке с участием экспертов, который предназначен для оценки полезности и безопасности ответов ИИ в реалистичных...
Практический расчёт стоимости 1000 вызовов инструментов на Claude, GPT-4o и Gemini 2.5. Как не переплатить за агентов, где сэкономить и...
OpenAI сообщила о выступлении Сэма Альтмана в Совете Безопасности ООН. Главными темами стали безопасность ИИ, сохранение контроля человека и международное...
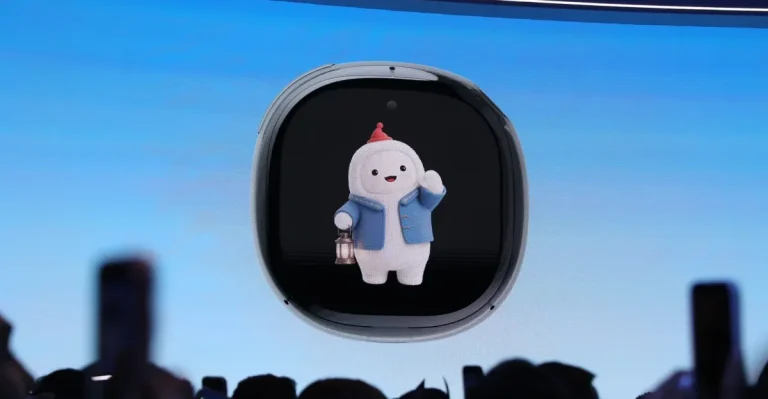
Марк Цукерберг продемонстрировал прототип Muse Charm с экраном, камерой, микрофонами и датчиком отпечатков. Meta рассчитывает начать поставки в декабре 2026...
GitHub запустил публичный превью локальной песочницы для десктопного приложения Copilot. Теперь агентный код выполняется в изолированном окружении с ограничением доступа...
Пошаговое руководство по настройке MCP-сервера для работы с PostgreSQL: от установки до тестирования tool calling. Разбор конфигурации, ограничений безопасности и...
GitHub разделил геометрию строк кода и комментариев, чтобы Copilot app мог открывать огромные пул-реквесты без миллионов DOM-элементов и резких скачков...
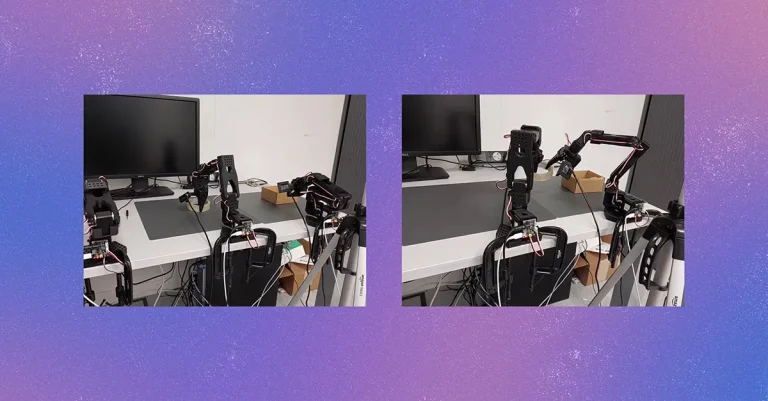
Microsoft Research сравнила бортовой, периферийный и облачный инференс в задачах мобильной робототехники. По данным авторов, внешние GPU ускоряют планирование и...
Koreshield заявляет, что проверяет сообщения, извлечённые данные и вызовы инструментов до выполнения действий ИИ-агентом. Пока возможности продукта описаны только его...