

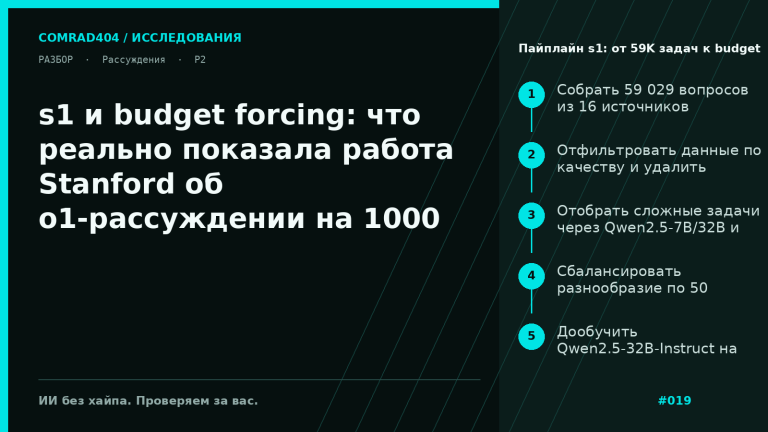
s1 и budget forcing: что реально показала работа Stanford об o1-рассуждении на 1000 примерах
Разбираем s1 — работу Stanford от 31 января 2025 года о reasoning-модели, обученной на 1000 примерах. Объясняем, что такое budget...
Тема COMRAD404
Разбираем s1 — работу Stanford от 31 января 2025 года о reasoning-модели, обученной на 1000 примерах. Объясняем, что такое budget...
Разбираем, что исследователи называют faithfulness цепочки рассуждений, как это измеряют в работах Anthropic, OpenAI и других, и почему полезный CoT...
Разбираем, что такое GRPO у DeepSeek, чем этот метод отличается от PPO, почему его истоки лежат в DeepSeekMath 2024, и...
Brown et al. показали, что множество независимых попыток может заметно поднять качество LLM без нового обучения. Разбираем repeated sampling, результаты...
Разбираем работу OpenAI Let’s Verify Step by Step: зачем давать награду не только за финальный ответ, но и за каждый...
Test-time compute — это отдельный дизайн вычислений на этапе ответа: sampling, ревизии, verifier и поиск. Разбираем, как работы 2024 года...


