ARC-AGI и спор об AGI: что тест реально измеряет
ARC-AGI часто подают как индикатор пути к AGI, но по замыслу Франсуа Шолле он измеряет более узкую вещь: насколько система...
Тема COMRAD404
ARC-AGI часто подают как индикатор пути к AGI, но по замыслу Франсуа Шолле он измеряет более узкую вещь: насколько система...
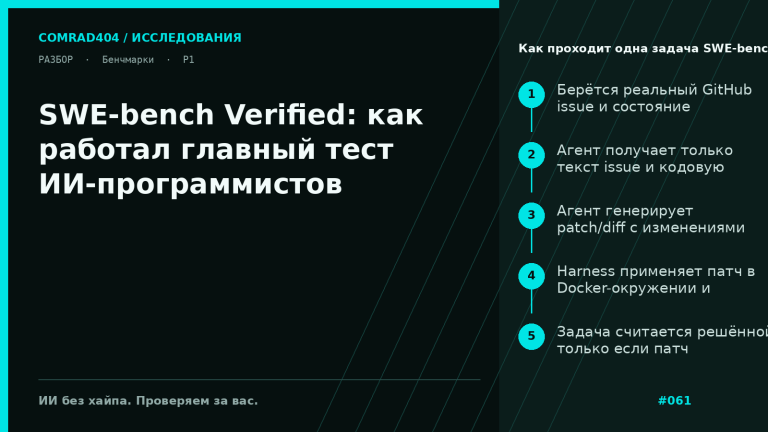
Разбираем, как устроен SWE-bench Verified: из чего он вырос, что именно измерял у coding-агентов, почему его цифры часто сравнивали некорректно...
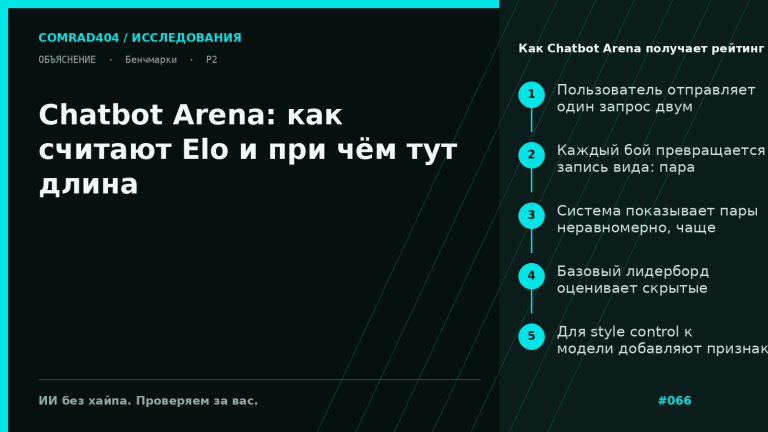
Разбираем, как Chatbot Arena превращает анонимные парные сравнения в «Arena Elo», почему на деле это Bradley–Terry, и зачем LMSYS отдельно...
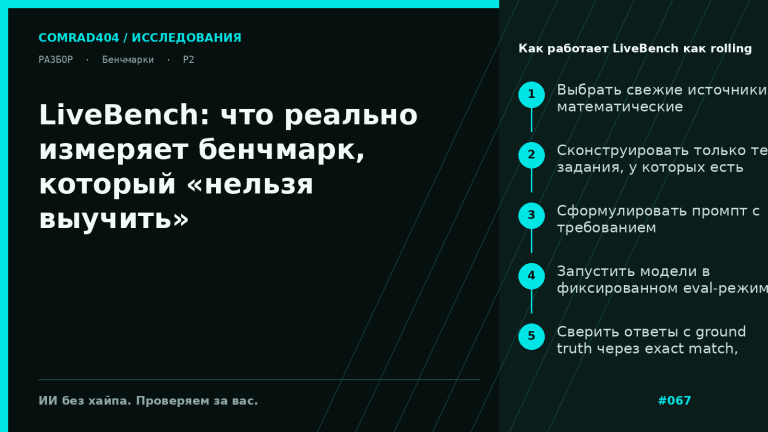
LiveBench обещал стать бенчмарком, который трудно «выучить» через тренировочные данные. Разбираем стартовую версию 2024 года, её метод, результаты и ограничения...
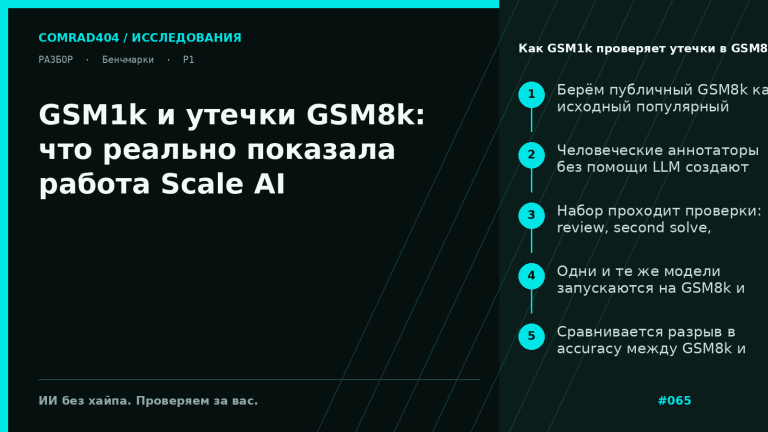
Разбираем работу Scale AI о GSM1k — закрытом аналоге GSM8k для проверки утечек. Что именно показал бенчмарк, почему в источниках...
Разбираем FrontierMath от Epoch AI в исторической версии 2024 года: как собрали задачи, почему ни одна модель не превышала 2%...
Разбираем Humanity’s Last Exam — бенчмарк CAIS и Scale AI для закрытых вопросов экспертного уровня. Что в нём меряют, почему...
Разбор GPQA — benchmark Rein et al. для graduate-level science QA, где вопросы проверяют пределы веб-поиска, экспертной верификации и supervision...
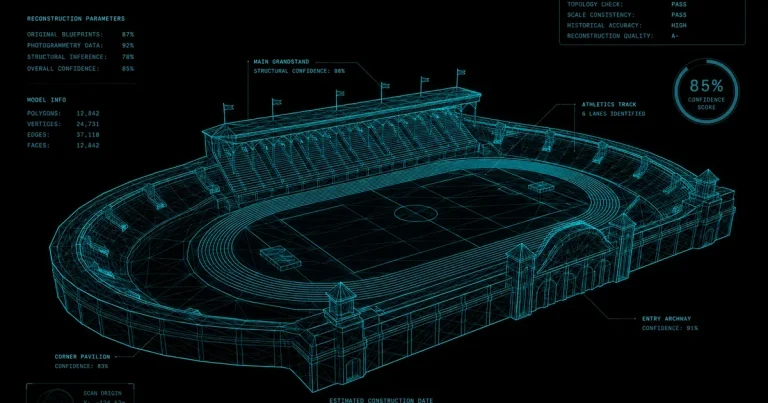
GPT-5.6 Sol восстановила White City Stadium 1908 на Three.js с источниками, кодом и автотестами. Разбираем цены, бенчмарки и историю с...