Anthropic вместе с партнёром Theorem поручила Claude формально проверять уже существующий программный код и создавать математические доказательства его корректности. По данным The Decoder от 23 октября 2026 года, за несколько недель модель сгенерировала примерно 180 млн строк кода доказательств для 123 библиотек с открытым исходным кодом из проекта Google OSS-Fuzz. Для читателя это означает возможный способ находить ошибки, которые обычные тесты не замечают, но не универсальную гарантию безопасности программ.
Claude проверял существующий код математическими доказательствами
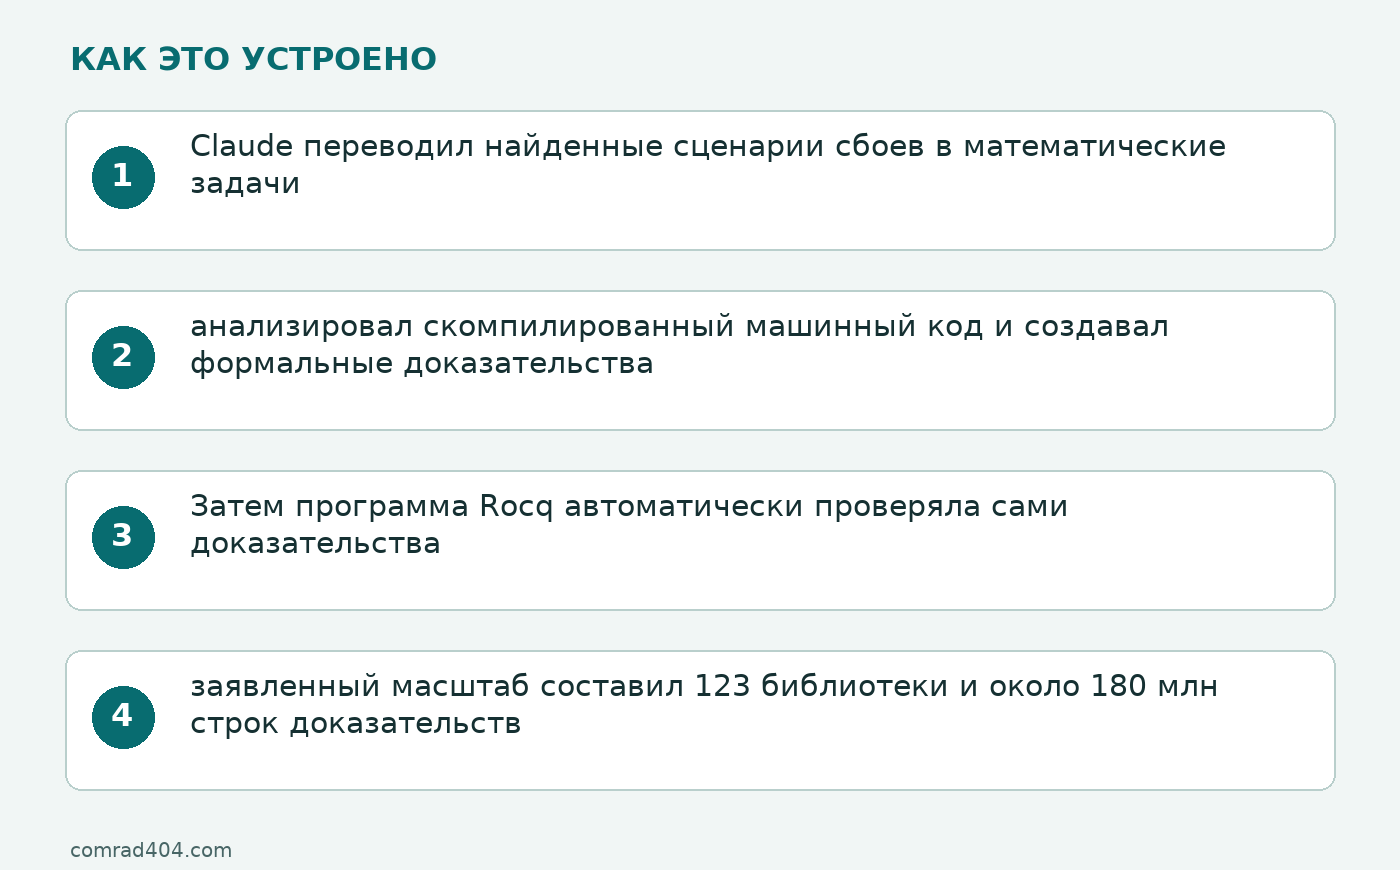
Задача состояла в том, чтобы описать поведение программы математически и доказать её корректность при заданных условиях. В эксперименте использовались библиотеки, связанные с тестами безопасности OSS-Fuzz, а заявленный масштаб составил 123 библиотеки и около 180 млн строк доказательств. Эти числа The Decoder приводит со ссылкой на Anthropic и Theorem.
Как проходила формальная проверка
Процесс начинался с аварийных тестов. Claude переводил найденные сценарии сбоев в математические задачи, анализировал скомпилированный машинный код и создавал формальные доказательства. Затем программа Rocq автоматически проверяла сами доказательства. Такой подход отличается от обычного тестирования: тест показывает поведение на отдельных наборах входных данных, а формальное доказательство должно подтвердить утверждение для заранее описанного диапазона условий.
По описанию проекта, участие человека в проверке доказательств требовалось в минимальном объёме. Однако это не означает, что весь процесс разработки или постановки задачи был полностью автоматическим: опубликованный материал не раскрывает детальную методологию отбора библиотек и проверки всех промежуточных решений.
Какие ошибки удалось обнаружить
Anthropic утверждает, что Claude нашёл сотни ошибок, пропущенных обычными тестами. В одном из примеров при проверке распространённого PDF-ридера команда за неделю обнаружила столько уязвимостей, сколько обычно сообщают для этого продукта за год. В другом приложении модель выявила логическую ошибку, которая оставалась незамеченной более десяти лет.
Это примеры, приведённые участниками проекта, а не независимое измерение эффективности метода. Материал также не даёт полного распределения найденных ошибок по 123 библиотекам и не показывает, сколько из них было подтверждено разработчиками или исправлено.
Где доказательства перестают действовать
Формально проверенный код не становится безошибочным во всех обстоятельствах. Anthropic описывает доказательства, действующие при конкретной архитектуре процессора, для однопоточных программ и входных данных размером менее 64 МБ. Те же библиотеки на другом оборудовании, в многопоточном режиме или с более крупными входами могут вести себя иначе. Отдельные доказательства, по описанию компании, требуют до сотен миллионов токенов; общая стоимость проекта не раскрыта. В небольшом тестовом запуске Opus 5.5 решил половину доказательств примерно на 40% меньшем числе токенов, чем Opus 5, но это сравнение не является независимым бенчмарком и не показывает стоимость промышленного внедрения.
Что подтверждено, а что остаётся заявлением участников
Подтверждённый факт публикации — The Decoder 23 октября 2026 года описал эксперимент Anthropic и Theorem с Claude, формальными доказательствами и автоматической проверкой Rocq. Масштаб, число найденных ошибок, примеры с PDF-ридером и сравнение моделей в доступном материале представлены как заявления Anthropic и Theorem, пересказанные изданием. Независимого тестирования или отдельного отчёта участников в доступных источниках нет, поэтому эти результаты следует считать атрибутированными, а не установленными независимым измерением.